本期看点
Agent 的慢工具、GPU 内部距离和边缘节点的排队都能成为推理瓶颈。AOSpec 将投机与正确性验证结合;NUNA、DEFRAG 和空间缓存则从不同层次调整计算、通信和资源位置。加密分割推理提供一个隐私敏感 CNN 的邻近案例。
01 · AOSpec:把动作与观察一起投机
AOSpec: Action and Observation Co-Speculation for Low-Latency Agent Serving
Hao Mark Chen, Jinnan Guo, Wayne Luk, Hongxiang Fan · 2026-08-01
Agent 每一步通常先生成工具调用,再等待环境返回,慢工具会让模型空等。AOSpec 同时预测未来动作和观察,将模型生成与工具执行交叠;它针对的是完整 agent–环境循环,而不是仅加速模型解码。
系统用 Expected Value Decoding 优先预测能隐藏更多工具等待时间的观察,而不是单纯追求命中率。对只有真实执行才能揭示的结果,它在隔离的环境分支提前运行目标动作;Joint Action-State Verification 同时检查动作及其来源状态,只有与已提交执行一致时才复用结果。预测失败则沿真实轨迹继续,隔离与验证是保持串行语义的关键,尤其不能把它理解为可随意提前提交外部副作用。
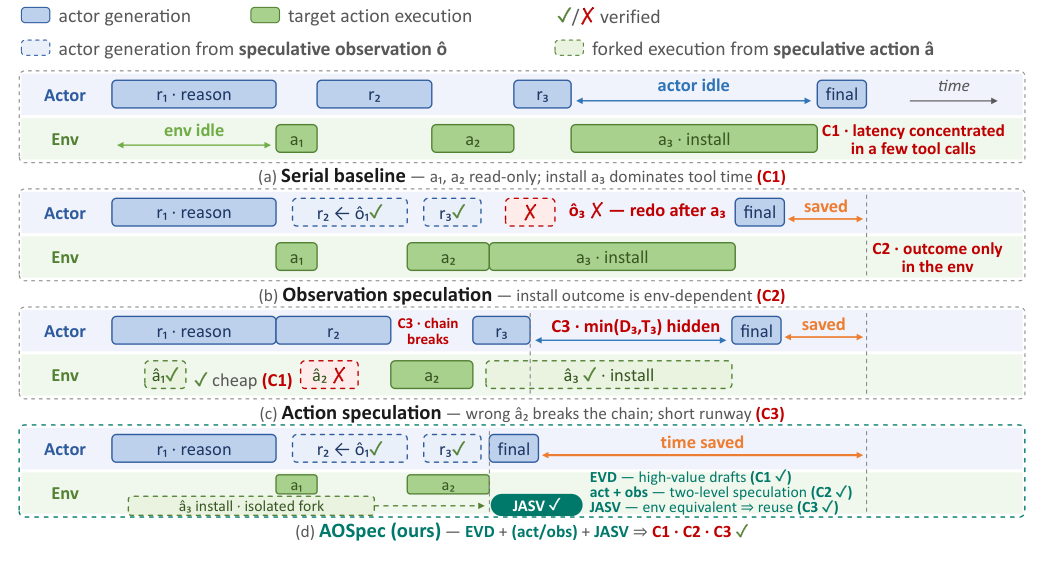
读图:从上到下比较串行、仅预测观察、仅预测动作,以及联合投机;底部在隔离分支执行较慢动作,验证动作和状态后才复用。
作者在 Terminal-Bench 2.0 的九组 harness/模型配置、五档生成速度上回放相同轨迹。相对串行执行,平均延迟节省从 20 ms/token 时的 11.8% 增至 1 ms/token 时的 32.5%;最强实际基线分别为 4.3% 和 12.2%。在 10 ms/token 条件下,中位数与 p90 延迟分别降低 10.7% 和 10.5%。SWE-bench Verified 的跨基准回放在 1 ms/token 下节省 18.9%。这些是固定轨迹回放和模型化生成速度的结果,并非线上部署的端到端实测;额外预测与隔离执行也需要资源。值得精读的是其把延迟收益和执行正确性放进同一设计。
02 · NUNA:让 GPU 通信考虑片内距离
NUNA: Characterizing and Mitigating Non-Uniform Network Access in Multi-Die GPU Scale-Up Systems
Conor James Green, William Won, Tuan Ta, Bradford M. Beckmann · 2026-08-01
多 die GPU 上,计算单元、显存和跨 GPU I/O 端口之间的距离不相同。NUNA 将这种网络访问不均匀性作为优化对象:NUNA-aware routing 根据物理位置选择端口,NUNA-aware placement 则将线程块和数据放到靠近对应 I/O 的位置。它与传统只关注计算和内存局部性的 NUMA 优化不同。
作者在 ASTRA-sim 建模的 scale-up 系统中报告,单用 placement 的集合通信最高加速 1.5 倍,结合 routing 后最高 1.8 倍;12 种 LLM 架构的推理模型中每输出 token 时间平均改善 7%、最高 28%。端到端评估使用推理轨迹和 roofline 估算,计算和通信按串行建模,并非实体集群测量。对推理服务而言,值得关注的是片内拓扑可能改变跨 GPU 通信成本,而这些倍率仍需在具体硬件和并行策略下验证。
03 · DEFRAG:边缘节点协作检索与生成
From Cloud to Crowd: Democratizing LLM Service with Decentralized Edge Collaboration for RAG
Jiaxing Li, Hengzhi Wang, Feng Wang, Chi Xu, Danyang Song, Ruixiao Zhang, Edith C. H. Ngai, Jiangchuan Liu · 2026-08-02
DEFRAG 针对边缘小模型知识覆盖不足、集中式服务成本和容量受限的问题,把知识图谱压缩共享与混合检索结合,再按查询使用贝叶斯在线优化选择模型和 RAG 参数,在准确率与成本之间取舍。它不是把一个大模型简单切分到设备上,而是让异构节点协作提供检索和生成。
作者在六台异构设备的原型上评估 Natural Questions 与 HotpotQA,各取 500 个问答对;也考察移动路径、非均匀数据分布与领域问答。在其成本模型和基线下,准确率导向配置把两项任务的准确率提升到 67.8% 和 81.4%,相对 235B 模型的差距分别缩小到 6.4 和 2.3 个百分点;资源共享时报告最高 98.4% 成本下降。该幅度取决于所比较模型和计费假设,不能视为任意边缘部署的收益。其价值在于把检索知识共享与按查询配置选择一起纳入边缘服务。
04 · 空间前缀缓存:缓存命中还要考虑排队
Spatial Prefix Caching for Wireless Edge LLM Inference: A Stochastic-Geometry and Queueing Framework
Le Yang, Zhouyong Liu · 2026-08-02
无线边缘节点既有不同距离,也缓存不同长度的 KV 前缀。选最近节点可能浪费复用机会,选最长前缀又可能造成通信和排队热点;持久缓存还会占用运行请求的显存。论文用泊松点过程表示节点,用前缀树表示共享关系,再把节点关联、缓存配置、可用并发和队列稳定性联合建模。
归一化模拟中,在指定请求强度为 4、TTFT 门限 0.8 秒时,负载感知策略的覆盖率约 0.63,忽略排队的前缀感知路由约 0.23。这个对比说明缓存亲和性可能在高负载时适得其反;它是特定模型参数下的分析和模拟,不是无线生产网络或连续批处理服务的实测。
05 · 加密分割推理:联合选择端与边界
Latency-Optimal Adaptive Split Inference for Privacy-Preserving Cloud-Edge-End Collaboration
Yi Li, Peng Zhang, Man Ho Au · 2026-08-02
这项工作面向隐私敏感的 CNN 批推理,而非 LLM 服务。端设备执行明文前缀并持有密钥,之后将中间激活加密;边缘和云在全同态加密数据上执行剩余部分。规划器联合选择端侧切分点与边缘终止点,考虑计算、加密和通信成本。
在 CIFAR-10 和 PathMNIST 上,作者报告相对全云 FHE 约 12.9 倍、相对块级切分约 3.9 倍的摊销加速;计入模型化通信后仍约为每样本 1033 秒和 1023 秒。它提供了异构推理规划的邻近案例,但这些结果不能外推到 LLM 或交互式低延迟服务。
社区动态
OpenSRE 介绍帖 描述一个自托管的 AI SRE 工具:告警后聚合日志、指标、追踪和部署信息,利用工具调用检验假设,并给出可追溯证据的根因报告。项目介绍还提到标识符遮蔽与遥测退出;帖文称其为公开 alpha。它值得作为事故调查工作流的实现观察,而这些功能描述本身不证明诊断准确率。