本期优先看 ByteSplat 和 Coda。前者包含 Minyi Guo,展示三维场景训练如何同时减少片外访问和卡间传输;后者把编码 Agent 的缓存恢复成本与批内上下文差异放进服务决策。两篇的共同阅读价值,是解释局部优化何时能变成整条执行路径的收益,而各自的峰值仍受工作负载与配置约束。
其余四篇提供不同层次的补充:WakeKV 让缓存降级可逆,ServeTwin 让模拟器保留队列与 KV 反馈,VenusRL 围绕轨迹组完成调度训练,BitIR 检查同一语义故障跨 GPU 后端的后果。它们不是一套统一方案;选择原文时,应先区分实机测量、轨迹模拟和故障模型下的实验。
01 · ByteSplat:把数据搬运与场景表示一起优化
ByteSplat: Efficient Distributed 3D Gaussian Splatting Training via Intra- and Inter-GPU communication reduction
Shuo Wu, He Zhu, Han Zhao, Xiaohui Zhang, Yaqian Zhao, Hui Wei, Ruyang Li, Hongzhi Shi, Lihua Lu, Jingwen Leng, Yu Feng, Minyi Guo · 2026-10-02 (UTC) · arXiv v1 · Minyi Guo 参与
加速来自少搬数据,也来自改变工作集
3D Gaussian Splatting 用大量高斯表示场景。分布式训练时,拥有高斯参数的 GPU 把属性发给负责图像区域的 GPU,后者渲染、算损失,再把局部梯度送回。显存容量因此扩大,但本地 DRAM 与卡间链路都可能成为瓶颈。ByteSplat 同时处理这两段数据流,值得关注之处是把内核实现和场景表示联系起来。
常规流程把前向光栅化、损失计算和反向光栅化拆成不同内核。中间像素、梯度和高斯属性反复写回、重读。ByteSplat 把三者融合,尽量让数据留在片上。但这要求损失能在图像 tile 内计算:普通 SSIM 的邻域会跨 tile,论文改用 tile 内的 S3IM 消除依赖。因此它涉及训练目标的调整,不能只看成一次等价的内核合并。
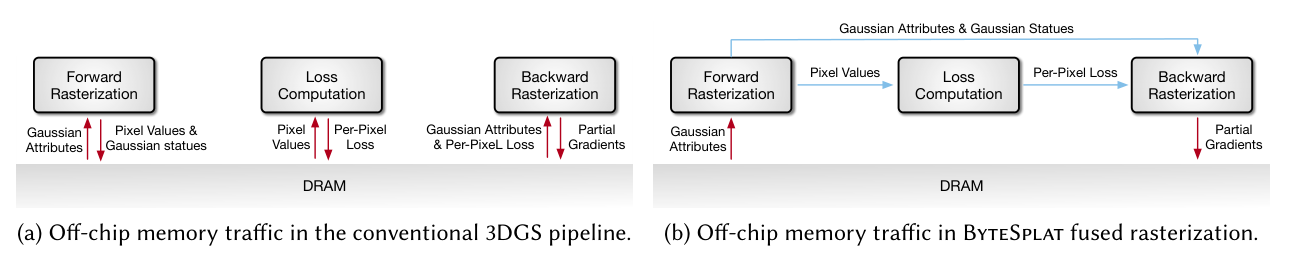
读图:左边三个阶段经 DRAM 交换中间结果;右边让像素、损失和高斯状态在融合计算中直接传递,最终梯度仍写回。
融合还会拉长数据在共享内存中的驻留时间。一个 tile 涉及的高斯太多,就装不下;即使装得下,也可能压低并发线程块数。系统先正常训练、增密,再删除从未成为像素主要贡献者的高斯并微调,随后根据目标 GPU 的共享内存预算,对拥挤 tile 做硬件感知剪枝。超预算区域仍走常规路径,保留的高斯通过训练补偿被删表示。
卡间优化则利用另一个事实:参与区域筛选的高斯,未必真正贡献到像素。系统只压紧、传输非零局部梯度,并在所属 GPU 解码聚合。这里删除的是所有分量都精确为零的记录,与前述可能影响质量的高斯剪枝应分开理解。
剪枝使表示本身随硬件预算变化,换平台时也要同时检查重建质量和融合覆盖率。只迁移融合内核而沿用原有表示,未必获得完整系统的收益。
6.1 倍的条件是什么
作者在六个数据集上比较 Grendel-GS:八张 A6000 的每轮训练平均加速为 3.4×,峰值 6.1×;八张 A100 上平均 2.7×、峰值 3.6×。完整系统反向卡间通信平均减少 65.8%,其中去零贡献 46.2%,剪枝再贡献 19.6%;这些百分比都相对原始通信量。质量方面,最大 PSNR 降幅 0.1 dB,最大 SSIM 降幅 0.01,并非逐项完全不变。
这些结果支持“减少搬运并塑造工作集”的联合设计。最需要保留的边界是,性能以剪枝微调后的检查点测量每轮延迟;初始训练平均约 20 万轮,剪枝后另做 3 万轮微调,6.1× 不能直接解释为从零训练到同等质量的总用时缩短。收益也随场景密度、共享内存和互连变化。优先阅读融合数据流、硬件感知训练与消融实验:它们比单一峰值更能说明哪些优化可以迁移到自己的 GPU 工作负载。
02 · Coda:让恢复成本与上下文长度进入准入决策
Coda: Exploiting Admission Flexibility for Coding-Agent Serving
Youhe Jiang, Fangcheng Fu, Binhang Yuan, Krishna Malladi, Ehsan K. Ardestani, Zhan Shu, Adnan Aziz, Yi Xu · 2026-10-02 (UTC) · arXiv v1
工具返回了,请求却未必适合立刻执行
编码 Agent 在模型调用与工具之间反复切换。工具结束只说明逻辑上可以继续:历史 KV 可能还在 CPU,恢复后又可能遇到与其他请求差异很大的上下文长度。Coda 把这两类成本放到准入层,分别决定下一条先准备谁,以及本轮注意力如何组织。
与主要围绕缓存命中和负载做调度的系统相比,它增加了“准备成本”和“执行兼容性”。前者包括取回 KV 与新增 token 的 prefill;后者关注当前实际上下文长度,而不是预测最终答案有多长。两种信息都随会话恢复、缓存搬运和请求完成而更新。
Tiered-Aging 先在显存可容纳的候选请求中偏好准备成本低者,再用等待时间提高旧请求的优先级。实验中老化时间尺度为 5 秒,等待达到 20 秒时最老的可行请求优先。这个保护限制的是被效率偏好反复绕过,仍受显存可行性约束,不能读成每个请求必在 20 秒内执行或完成。
分开注意力,保留同一轮参与者
纯 decode 轮次中,系统按上下文长度排序,尝试切成较短与较长两组。只有保守估计的收益至少 5%,且两组都足够大时才拆分。每层仍做一次整批 QKV 投影与 KV 更新,两组分别调用注意力,再回到整批后续计算;请求集合没有减少,完整模型也没有执行两遍。
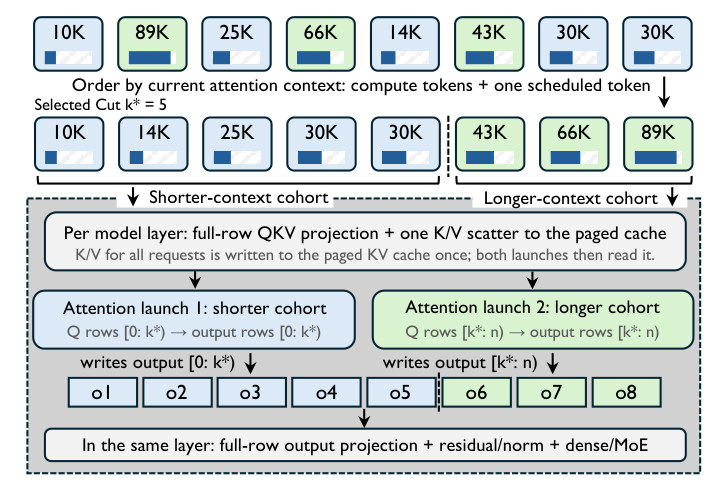
读图:先按上下文长度排序,中间只写一次 KV,再分两组计算注意力;底部回到整批投影与 dense/MoE 计算。
多 worker 时,路由先保留可用 KV 亲和性并约束负载,再用上下文兼容性选择位置。这说明缓存所在位置与批内计算形态是不同信号:命中多的 GPU 未必最适合接下一个请求,而为了相近长度任意放弃缓存也可能得不偿失。
吞吐收益与实现边界
作者用 TraceLab 派生轨迹,以每秒 3、5、7 个请求回放,比较 CacheWise、SMetric 和 vLLM。四张 A100-80GB 服务 Qwen3-Coder-30B-A3B-FP8 时,相对每项指标和轨迹中最强的竞争基线,输出 token 吞吐提高 4.2–12.1%,SLO 合规吞吐提高 15.9–44.3%。后者依赖论文的延迟目标口径,不代表任务正确率提升。单 GPU 消融与更大模型实验提供了额外证据,但不宜把跨设置汇总峰值套到所有服务。
一个容易漏掉的限制是:动机分析的存储层级回放包含 SSD,设计公式也有 SSD 加载项,但附录明确当前原型与报告实验未配置 SSD,该项为零。迁移到实际磁盘缓存要重新测量加载曲线,不能声称论文已验证这一路径。值得先读准入机制和附录校准方法:这是一项调度与执行组织的系统改进,收益取决于恢复成本、长度异质性以及成本模型是否准确。
03 · WakeKV:给被移出显存的 KV 留一条回路
WakeKV: Reactive, Reversible KV Residency for Heads That Change Their Minds
Utkarsh Ranjan · 2026-10-02 (UTC) · arXiv v1
注意力头的读取行为会变,prefill 时一次分类可能过时。WakeKV 为每个头维护有预算的 GPU LRU 集合,把移出的完整 KV 页留在 CPU,需要时再取回;代价从永久丢失转成可恢复的传输等待。
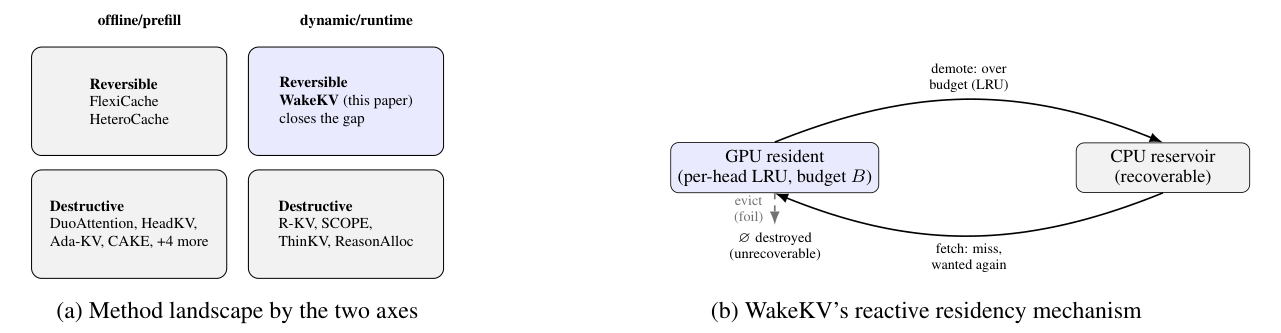
读图:左侧是作者对方法的分类;右侧沿 GPU 到 CPU 的降级箭头,再沿 miss 后取回的箭头读,虚线表示不可恢复删除的对照。
作者在 A30、Mistral-7B 上用 FlexiCache/vLLM 接入验证:严格每步重排配置相对 stock FlexiCache 吞吐为 1.34×,LongBench 相对质量为 97.4%;放宽到每 16 步重排可达 2.33×、质量 95.0%。收益也来自减少注意力工作,不能全部归因于搬运策略。模拟比较的是未命中率,且部分基线是简化重实现,不等于端到端停顿减少。适合追踪可逆缓存策略,但目前实机证据仅一张 A30 和一个模型,CPU 容量及 PCIe 等待仍需评估。
04 · ServeTwin:让模拟时间反过来改变服务状态
ServeTwin: A Benchmark-Validated Simulator for Distributed LLM Architecture Exploration
Sungjoon Park, Changue Jung, Kyungno Joo, Mincheol Kang, Jaehyung Ahn, Sehwan Lee, Sangjoon Kim · 2026-10-02 (UTC) · arXiv v1
只把各算子耗时相加,容易漏掉缓存满后排队、请求完成后批次变化等反馈。ServeTwin 将有状态服务循环、iSTAGE 解析式执行轨迹和 ASTRA-sim 耦合,让预测时间推进时钟,再更新准入、批处理和 KV 生命周期。
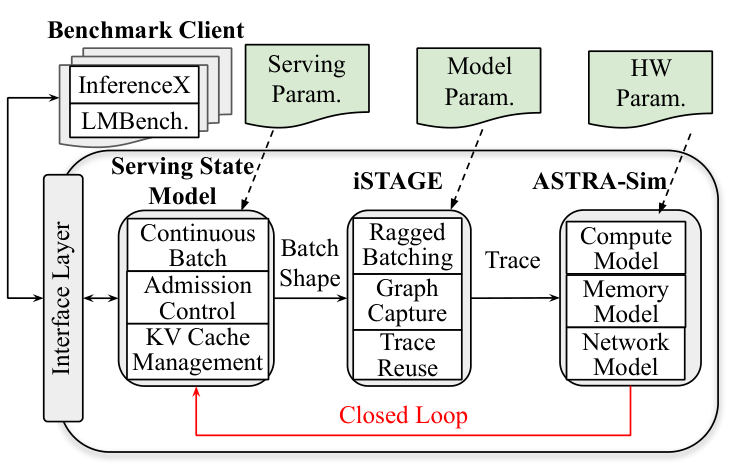
读图:服务状态产生批次形状,iSTAGE 生成轨迹,ASTRA-sim 估算执行;底部反馈把时间送回服务循环。
作者在 InferenceX 的 27 个工作点上报告平均误差 3.6%,留出点误差 3.7%;多轮 LMBenchmark 汇总误差为 9.9%,但个别指标仍可偏差 20% 以上。它避免目标硬件的逐算子 profiling,仍需按组件校准吞吐、调度与运行时成本,不能称为无需实测。适合架构探索与瓶颈假设筛选;仿真中的带宽、容量取舍不是实际芯片收益承诺,关键应看跨平台校准规则与多轮状态验证。
05 · VenusRL:优先凑齐下一步训练所需的轨迹组
VenusRL: A Fully Disaggregated Agentic RL System with Priority Scheduling and Scalable Interaction
Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang, Xiaohe Hu, Jun Chen, Zhixin Wang, Xutong Wang, He Liu, Yanmin Jia, Shengrong Zhu, Peng Sun, Mingjie Zhang, Liming Liu, Jinlong Hou, Yuan Cheng, Yujun Zhang · 2026-10-02 (UTC) · arXiv v1
Agent RL 需要一组轨迹全部完成后才能贡献训练数据,单纯把 GPU 填满可能让许多组都差最后一条。VenusRL 分离训练、生成和环境交互,用剩余生成长度预测优先推动能尽快凑齐的组,并协调准入、KV 驻留与请求迁移;环境侧共享同模板的只读快照页,写入时复制。
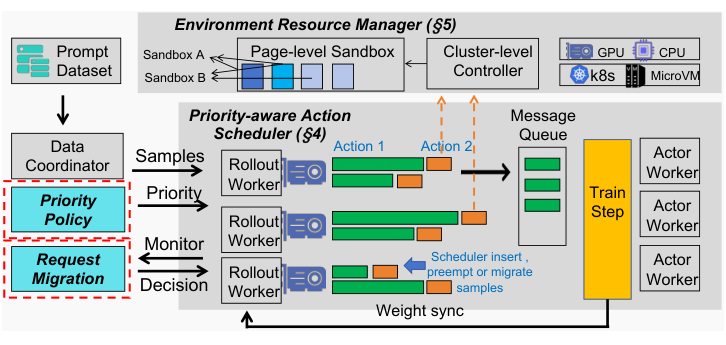
读图:左侧给轨迹设优先级,中间生成与环境交互交叠,右侧完成的样本组进入训练,底部同步新权重。
在 32 张 Hopper GPU(16 生成、16 训练)、Qwen3-4B/32B 与 OpenSWE 上,作者报告相对 RollFlash 最高 4.24× 训练加速;该峰值依赖较大批次与异步设置,严格 on-policy 的收益较小。沙箱密度提升也不保证永不内存超限,文中保留动态准入和迁移应对突发增长。值得关注组完成时间这一目标;长度预测、权重陈旧度及共享页隔离,是评估迁移价值时的核心边界。
06 · BitIR:在同一语义位置比较 GPU 故障后果
BitIR: Cross-Architecture Fault Injection for Resilience Analysis of Heterogeneous GPU Applications
Maisy Dunlavy, Michael Papka, Zhiling Lan · 2026-10-02 (UTC) · arXiv v1
不同 GPU 指令集让故障注入结果难以直接比较。BitIR 在 LLVM IR 层定义语义对应的位置和位索引,再经各厂商工具链编译,在 A100、Intel GPU Max 1550 与 AMD MI250X 上运行;用各平台无故障参考输出统一判定掩蔽、静默数据损坏和失败。
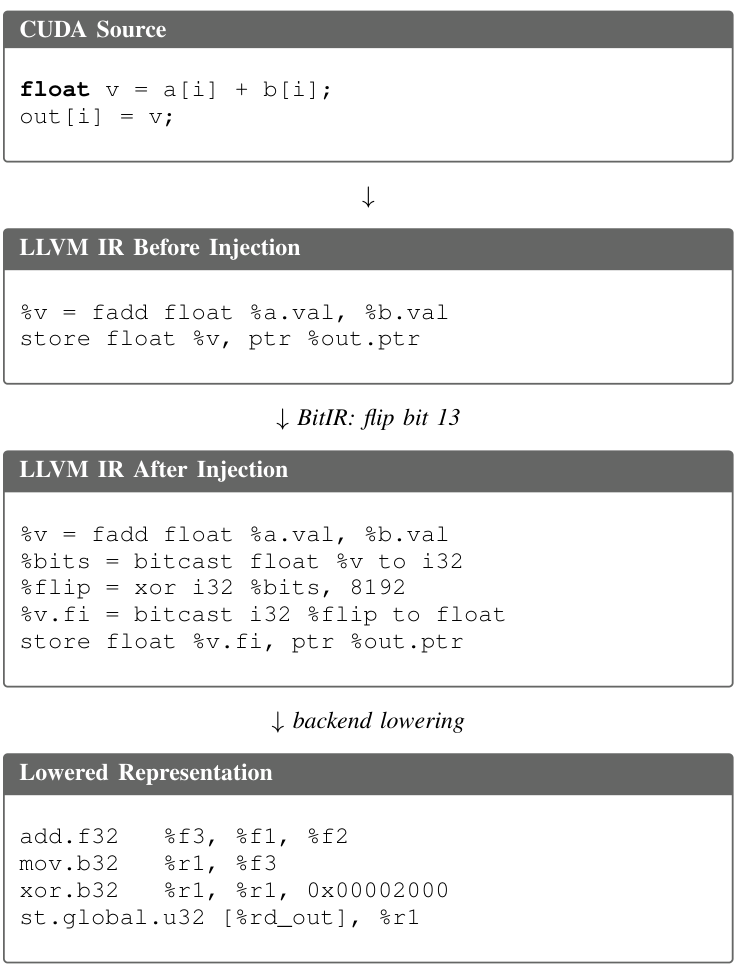
读图:从源代码往下看,在 IR 中加入单比特 XOR,再交给后端编译;此图展示 NVIDIA 路径,并非三个后端生成相同指令。
在保留的对齐注入集合中,作者报告仅 10.4% 的注入在三个后端产生同一结果类别,说明容错不能仅依靠跨平台功能等价来推断。这个比例属于选定 HeCBench 工作负载和单比特 IR 故障模型,包含编译器与运行时影响,不是硬件自然出错概率,也不能据此给厂商排可靠性名次。优先看故障等价定义与输出分类,它们决定跨架构比较究竟比较了什么。
一则阅读线索
@learnk8s 的原帖介绍了用生产 Agent 轨迹回放评估推理的方法,关注会话级指标与调用依赖,并指向 OpenTelemetry Trace Replay for Inference Perf。它与 ServeTwin 的阅读联系在于:多轮请求之间的关系会改变负载。这里仅记录原帖提供的线索,不把转述当作已经验证的性能结果;原帖显示 10 月 2 日,清单标为 10 月 3 日,未确认页面时区。