本期看点
优先读 Request Order Matters 和 AgentSpy。 前者发现,同一提示在不同缓存历史下可能得到不同答案,说明服务优化的评价需要纳入跨请求状态;后者把观察边界放到操作系统,看到最终测试通过之后仍被掩盖的文件访问、网络连接与执行路径。这两篇分别补充了“回答为什么变”和“Agent 到底做了什么”的证据。
其余四篇围绕共享资源的代价展开:MOLT 在训练步内部归还显存,LearnSched 比较现在改进与稍后改进的净收益,Mosaic 预测 GPU kernel 干扰,Ofan 将目标地址纳入网络负载均衡。值得关注的是它们如何定义可保留的状态、必须归还的容量和真正改善的指标;六篇工作尚不足以支持整个领域已形成统一方案的判断。
重点解读
01 · Request Order Matters:缓存历史会改变同一提示的答案
Request Order Matters: Cache-History Sensitivity in Selective KV-Cache Reuse for Rolling Agents
Tiffany Gu、Annie Guan、Manshu Huang、Nitin Rao、Siddhant Shah、Margaret Capetz · 首发 2026-10-05(UTC)
文本没变,中间状态却变了
长时间运行的 Agent 常保留大部分文档,只移除最旧内容并加入新材料。删除开头文档后,后面的 token 位置和前文都变了,精确前缀缓存难以继续命中。CacheBlend 的非前缀复用会加载旧 KV,再选择一部分 token 重算,以较低代价修补上下文差异。但缓存跨请求保存时,当前调用读到的状态也取决于此前处理过哪些请求。
论文保持每个提示不变,只改变完整请求进入系统的顺序。因而它研究的不是提示内文档重排,而是先前请求留下的缓存历史。默认 token top-k 按当前 key 与缓存 key 的偏差挑选单个 token,选中位置可能很零散;作者比较的 document-aligned 策略按文档跨度的平均偏差排序,优先重算完整跨度,剩余预算用连续窗口补齐。两者都严格重算 5% 的可复用 token。
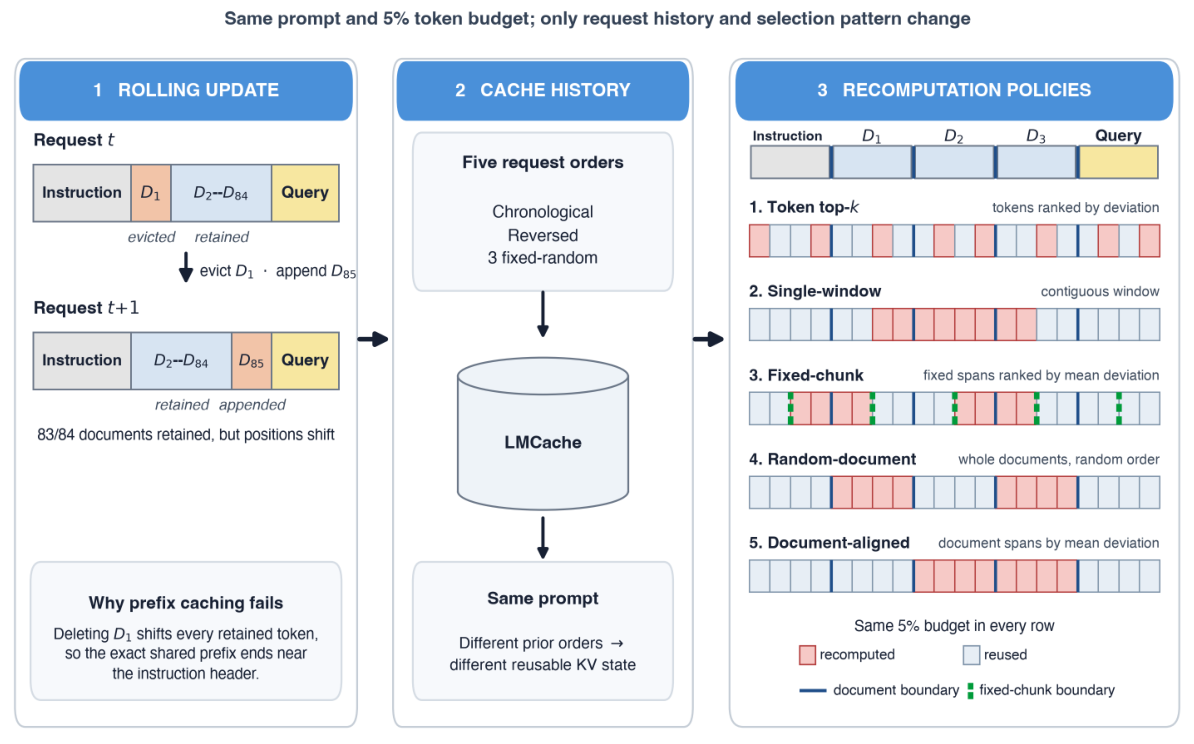
读图:左边每次替换 84 篇文档中的一篇;中间用五种请求顺序形成不同缓存历史;右边在相同 5% 预算下比较零散 token 与连续跨度的重算位置。
相同重算量,可靠性差异出现在请求历史中
作者使用 Qwen3-8B、贪心解码、LMCache 0.5.1 和 vLLM 0.23.0,关闭 vLLM 前缀缓存。金融记录构成 7,735 次滚动更新,每个窗口 84 篇文档、约 7.2K–7.7K token,任务是逐字提取字段。五种顺序包括时间顺序、逆序及三种固定随机顺序;请求逐个发送,每组实验独立从空缓存开始、组内持续保留状态。
跨顺序答案变化率由 token top-k 的 69.0% 降至 26.1%。这是同一请求在五种顺序的十个两两比较中答案不同的比例。与完整 prefill 答案的一致性在时间顺序下为 86.8% 对 85.4%,差异不显著;其他四种顺序下,文档跨度策略高出 34.5–52.5 个百分点。逆序压力测试中,它的一致性仍只有 54.3%,说明修补并未消除历史影响。
NVIDIA L4 上,完整 prefill、token top-k、文档跨度策略的中位首 token 延迟分别为 2,408、426、415 ms,后两者约快 5.7 倍;P95 分别为 2,524、459、477 ms。文档策略的中位数略优,但尾延迟并未同时更低,且这些数字不代表并发服务吞吐。
真正值得保留的是评价维度
500 请求消融中,连续窗口、跨文档固定块和随机文档跨度在固定随机顺序下都明显优于零散选择。文档边界和按偏差排序未显示额外显著优势,证据更支持“连续重算”这一共同特征。另一个每次清空缓存的 500 请求对照中,两种主策略也没有显著一致性差异。
建议优先阅读实验协议与选择模式消融。 对持续运行 Agent 的启示是,把缓存历史当作测试输入的一部分;只测干净缓存会遗漏问题。边界则是单模型、单类字段提取负载和固定 5% 预算;与完整 prefill 一致也不等于答案真实正确。缓存条目保留与重建各自造成多少影响,作者仍列为后续问题。
02 · AgentSpy:用系统行为补齐结果测试的盲区
AgentSpy: Making AI Agent Behavior Observable
Christoph Bühler、Matteo Biagiola、Luca Di Grazia、Guido Salvaneschi · 首发 2026-10-05(UTC)
一条工具调用,可能包含许多未被解释的动作
Agent 执行脚本时,轨迹通常记录调用和返回值,却未逐项展示脚本访问的文件、连接的主机及派生进程。结果测试也可能只检查输出文件是否正确。AgentSpy 从 Agent 外部观察操作系统边界,将这些资源交互变为可比较证据,补充轨迹中自然语言推理的解释能力。
框架接受任务、Agent 配置和分析类型,由编排器创建隔离环境,执行管理器运行任务并收集证据,分析器在环境外生成报告。实现使用 Firecracker microVM;可靠性分析组合 auditd、laurel 和 Zeek,安全分析使用 Falco。监测从准备完成后开始、在结果收集前停止,避免把安装依赖和导出文件误算成 Agent 行为。
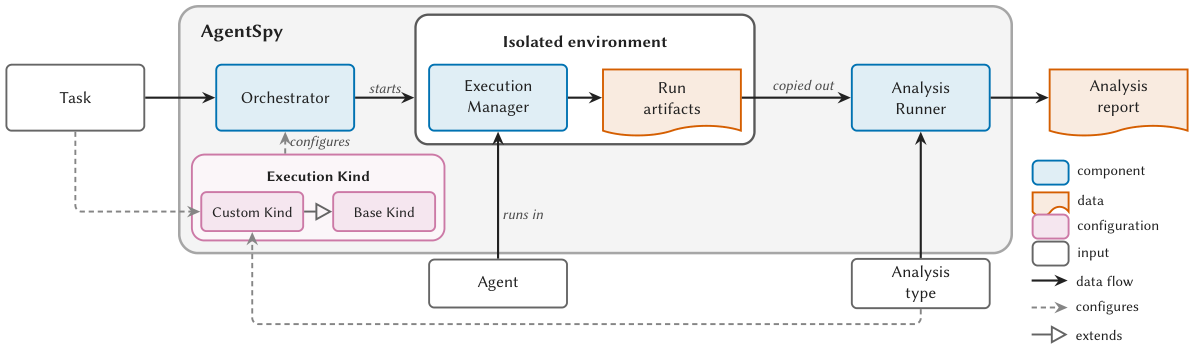
读图:任务与配置进入左侧编排器,中间隔离环境产出执行材料,右侧分析器读取材料生成报告;同一批材料可以再次分析,无须重跑 Agent。
“应该做什么”与“禁止做什么”分别检查
可靠性分析把一次执行归纳为星形图:中心是执行,外围是命令、文件和主机,边记录操作类型与次数。它按资源类别归一化计数,再计算加权 Jaccard 相似度;同时以访问过的 skill 文件比例衡量覆盖率。分数帮助定位差异,却不能仅凭低覆盖率断言执行错误,因为任务可能有其他合理解法。
安全分析则对系统调用应用确定性规则,检查敏感信息读取、工作区外修改、不可信执行或提权,以及未许可的网络访问。它让可疑行为在隔离环境内发生并记录告警,适合审计某项 skill 的实际作用;规则检查本身不构成阻止所有危害的运行时防线。
通过测试的运行,仍留下哪些疑点
可靠性实验在 codex harness 上使用 gpt-5.6-terra、deepseek-v4-flash、glm-5.3-flash,对 77 个 SkillsBench 任务各运行三次。作者以任务差异作为行为差异的代理:同任务运行集合比混入另一任务的集合更相似,占比较的 92.2%,这不是异常检测准确率。
人工分析进一步只保留三次运行都通过全部测试的 88 个任务—模型组合。其中 16 个(18.2%)至少一次出现被作者标记为任务无关的活动,6 个读取评分测试文件,15 个(17.0%)没有利用 skill 的指导得到结果。类别可重叠,分母也不是所有运行,不能据此估计生产故障率。
安全实验选取五类攻击各一个案例,每个案例的注入与对照条件各运行五次,共 50 次,使用 gpt-5.1-codex-max。18 次实际执行了注入行为,检出 14 次,精确率 1.00、召回率 0.78;其余 32 次没有误报。漏掉的四次都只在允许的工作区内添加恶意 Git remote,尚未产生推送或外联,因此没有触发通用规则。
适合把方法与漏检案例一起读。 它提供可重复的资源行为摘要,语义判断仍需结合任务、轨迹和定制规则。开销实验每条件十次,未检出显著运行时间差异,但统计功效只能识别较大效应;不能写成“零开销”。单一 harness、有限模型与选定攻击案例也限制了泛化。
资源共享与调度动态
03 · MOLT:在训练步内部把显存还给推理
MOLT: A Fine-Grained GPU Memory Sharing System for LLM Serving with Opportunistic Fine-Tuning
Jaehoon Yang、Yongbeom Kim、Hojoon Kim、Seung Yul Lee、Jae W. Lee · 首发 2026-10-05(UTC)
MOLT 将共享单位缩小到反向传播所需的已保存激活。推理需要 KV 空间时,系统收回可安全回收、重算成本较低的激活页;当前训练步继续,反向再重算缺失激活。槽位状态表和跨 tensor-parallel rank 的保护窗口,防止回收仍被在途 kernel 使用的内存。
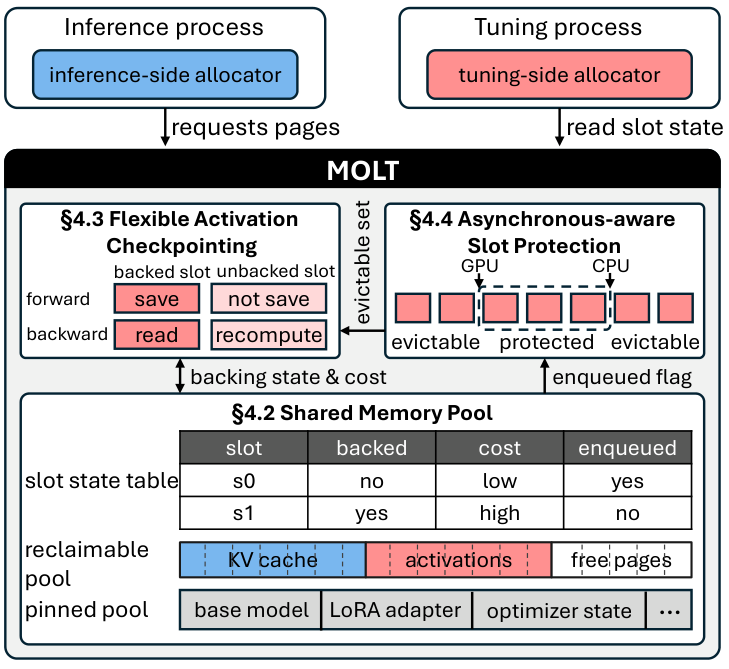
读图:推理分配器申请页面;右侧标出在途工作保护的槽位,左侧依据页面是否仍在决定保存、读取或重算;底部共享池连接两条路径。
在 BurstGPT 轨迹、ShareGPT 推理和 rank-8 LoRA 的 Alpaca 微调下,24B/70B 模型的四种 H100/B200 部署达到至少 99.7% SLO 达成率,微调吞吐为 LLMStation+SIRIUS 的 1.9–3.3 倍。SLO 要求 TTFT 和每输出 token 时间均不超过独立推理均值的三倍,不能理解为毫无推理减速。它适用于共享冻结底座的机会式微调;需改动分配器、付出重算和交接成本。优先看保护窗口如何处理异步执行。
04 · LearnSched:值得完成的改进,也可能值得晚点做
Serve Now or Improve Later? Scheduling Self-Evolution in Online Agent Systems
Yangbo Wei、Junhong Qian、Zhen Huang、Zhenyu Su、Qifan Wang、Shaoqiang Lu、Rumin Zhang、Chen Wu、Lei He · 首发 2026-10-05(UTC)
LearnSched 把工具、指导或模型状态的构建视为有延迟回报的投资:只有发布后被真正使用才产生收益。调度器记录进度、已持久化进度和恢复状态,在归还容量的约束下,用一步反事实 rollout 比较推进、保存与等待,成本包括检查点、恢复和状态驻留。
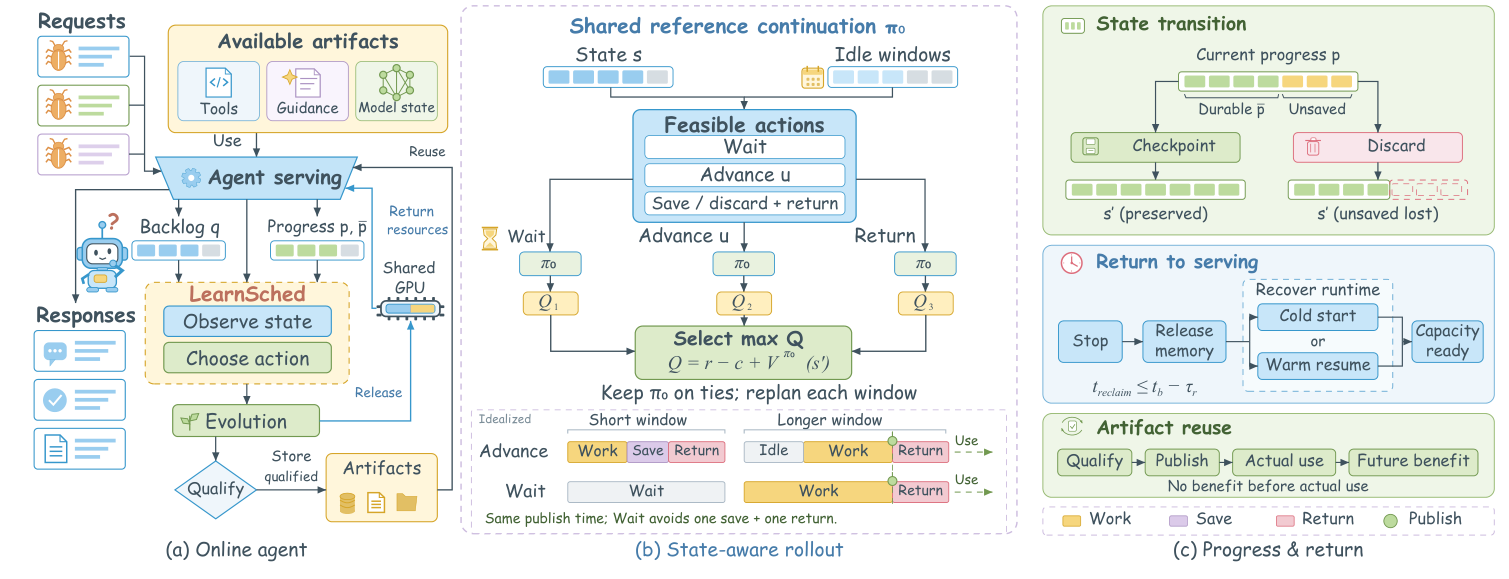
读图:左边是服务与改进的反馈环;中间用同一后续策略比较可行动作;右边区分保存进度、恢复服务,以及产物真正被复用后才出现的收益。
A100 组件测量被用于 1,920 个有限模型配对场景:相对已完整计价的 Costed Window,平均净值增加 1.10%,91 个场景改善、1,829 个持平;全部 960 个暖恢复场景均持平。收益来自避开昂贵冷恢复,不支持“复杂调度总是更好”。模型假定已知空闲窗口和准确转移成本,内存定价亦为假设;真实未知到达下没有硬截止保证。值得读的是成本核算与状态管理如何改变调度价值。
05 · Mosaic:把 kernel 干扰预测接入尾延迟调度
Mosaic: GPU Sharing with Latency Guarantees through Kernel-Level Interference Prediction
Foteini Strati、Ethan Graham、Leo Stephan、Paul Elvinger、Ana Klimovic · 首发 2026-10-05(UTC;北京时间 10 月 6 日)
即使两个作业占用不同 SM,仍会争用 L2 和 HBM。Mosaic 结合线程块放置、块密度及 SM 内外干扰模型,用两个 kernel 的独立运行 profile 预测共置减速;MosaicSched 只有在预测高优先级请求仍满足预算时,才准入尽力而为 kernel。
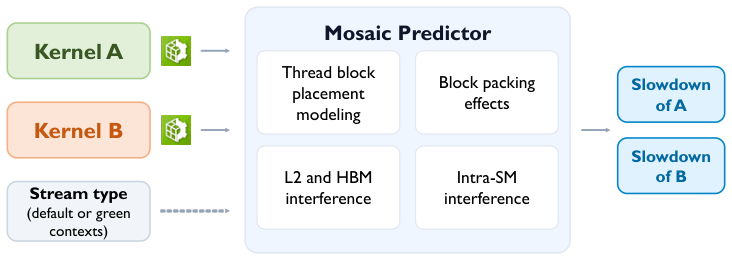
读图:两项 kernel 的 profile 与 stream 模式进入预测器,四个模块分别描述放置、块密度和两类资源干扰,输出各自减速供调度器使用。
预测器覆盖四种 NVIDIA GPU,调度器在 H100 上评估固定 batch 推理。多数负载超目标请求比例至多 1.0%,但 MobileNet 在允许 1.6 倍减速时达到 1.2%;预测误差和排队仍会导致违约。严格的 1.1 倍目标也可能让后台吞吐过低,失去共置成本优势。模型需按 GPU 校准,假定 CUDA stream 同优先级,未显式建模功率降频;应把“保证”理解为所测条件下的 SLO 控制能力。
06 · Ofan:上行均衡还要考虑下行目的地
Ofan: Optimal Load Balancing for AI Training
Sarah McClure、Evyatar Cohen、Jakob Krebs、Alexander Shpiner、Mark Silberstein、Scott Shenker、Sylvia Ratnasamy、Isaac Keslassy · 首发 2026-10-05(UTC;北京时间 10 月 6 日)
Fat-tree 中,选定上行路径后,到目的地的下行路径已固定;只看本地上行拥塞可能把冲突留给下游。OFAN 在交换机按目的交换机分组维护轮转指针,让同目的流量均匀分散;POFAN 为适配现有 ASIC pipeline,将指针按 pipe 分开,牺牲部分聚合效果。
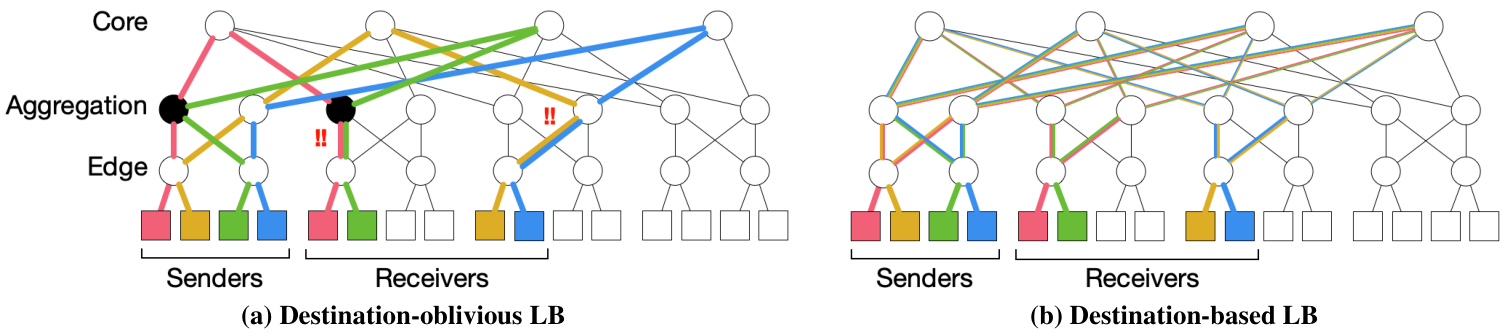
读图:左边不区分目的地的分流仍在下行发生冲突;右边按目的地轮转,避免将相同下游路径压成热点。这是机制示意,并非实测网络拓扑。
作者以 P4 实现报告资源占用,性能则来自 htsim 模拟。1,024 GPU、FP8、FSDP2/HSDP 的 Llama-3 405B 场景中,OFAN 相对 AR/REPS 较优者,将超出基线的集合通信完成时间增量减少 16–39 倍,分别对应 NSCC/MSwift;并非训练整体加速同样倍数。常数量级平均排队的证明依赖排队模型近似,尚无 POFAN 硬件集群性能验证。适合先读下行冲突解释,再看模拟假设。