本期看点
Agent 服务的瓶颈正在从一次模型调用,延伸到连续请求如何共享缓存、长短工作流如何共用设备。本期优先读 Vesta 和 AgentWeave:前者把缓存归属与执行位置分开,解释为什么空闲时值得搬运、拥塞时又要克制;后者沿数据依赖拆分长任务,解释为什么仅把模块放到同一组 GPU 上还不够。两篇优化的是不同层次,性能数字不能直接横比。
另外两篇分别补充成本与可靠性视角。TurboProm 将反复执行的指标查询转成可复用摘要计算;KedgeFlow 将动作批准、单次权限消费和目标执行串成明确契约。阅读时值得区分三类证据:轨迹回放的服务性能、查询成本估计,以及模拟目标上的权限边界验证。
01 · Vesta:缓存归属不变,执行位置随队列调整
Vesta: Queueing-Aware LLM Scheduling for Real-World Workloads
Lancheng Zou, Bowen Li, Wei Mao, Wenbin Ye, Lecheng Li, Kai Liu, Chao Deng, Jianchen Zhu, Bei Yu · arXiv · 2026-10-10
缓存命中高,仍可能等很久
多轮 Agent 往往把上一轮回答和工具结果追加到上下文。前缀缓存能够省掉重复 prefill,但把每轮都送回同一实例,会让热门实例积压、其他 GPU 空闲。直接迁走又要搬 KV 状态:如果全局已经拥塞,新增传输工作可能拖慢后来请求。Vesta 的增量,是把这种对后续队列的影响纳入调度,而不只比较当前请求在哪里最快。
系统为会话指定相对稳定的 holder,按会话 ID 在当前长度桶内哈希分配,保存持续累积的 KV 缓存;每个请求另选 executor。远端执行器取回可复用前缀,算完后把新增状态写回 holder,不把副本继续卸载到自己的主机缓存。GPU 中的临时副本仍可复用,因而不等于禁止一切复制。这样既能借用空闲算力,又避免长期副本挤占其他会话的缓存容量。
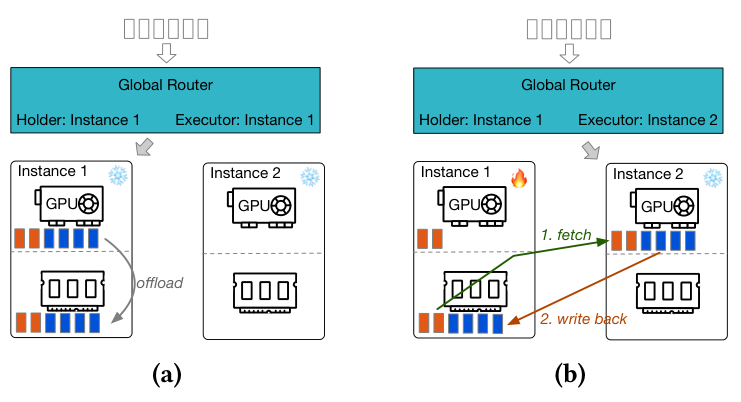
读图:左侧 holder 自己执行;右侧 executor 先取回橙色前缀,再把新增的蓝色状态写回原 holder。执行迁移没有改变缓存的长期归属。
每次迁移都要算上后来的等待
候选实例的评分包括未完成 prefill 积压、当前请求的计算与缓存加载成本,以及相对最低成本候选所增加工作的拥塞惩罚。集群空闲时惩罚小,可以提前借用其他实例;接近饱和时惩罚增大,倾向少搬运、少重算。与等 holder 过载才迁移的 SMetric 相比,这是一种逐请求、结合全局负载的判断。
会话长到进入更大长度桶时,系统还把最长可复用前缀转给新桶中的 holder,避免桶切换导致全量重算。哈希平衡的是长期会话数量,不保证瞬时请求负载相同;后者仍由 executor 选择处理。
延迟改善来自什么条件
作者在 H20 集群、200 Gb/s RDMA 网络上回放线上 Agent 轨迹,按原始到达时间发请求,会话内串行,并固定生成长度为轨迹记录值。32 个 prefill/decode 共置实例运行 Qwen2.5-7B-Instruct-1M 时,相比 SMetric,平均首 token 延迟从 3,993.89 ms 降至 1,685.63 ms,下降 57.8%;报告的 TPS 从 46.9 升至 53.4,约增 14%。
分离部署的改善较小:Qwen 的 24P8D 配置、2,552 个会话和约 33K 请求下,平均 TTFT 下降 18.1%;Hy3-FP8 的 6P6D 配置下,平均下降 14.5%、P99 下降 29.0%。这些数字来自不同配置,不能合成一项统一收益。去掉拥塞定价的消融中,完整方案在 Qwen 6P2D、8,030 请求下将平均 TTFT 从 2.71 s 降至 2.17 s,支持定价项确有作用。
值得精读的是缓存所有权与排队成本的组合设计。 排队模型用于构造受限的近似评分,并非真实流量的精确预测或延迟保证。实验依赖可远程读取的主机缓存、离线校准的延迟模型及长前缀复用;频繁改写历史上下文的应用未必得到同样收益。建议先看 holder 写回协议,再看分离部署与消融,判断自己的瓶颈是否确实在排队。
02 · AgentWeave:按数据流拆开长任务,减少请求阻塞
AgentWeave: Efficient Distributed Agent Serving via Flow Decomposition
Kaibin Guo, Pengtu Li, Zicong Hong, Zhiyuan Fang, Wuhui Chen, Rachid Guerraoui, Anne-Marie Kermarrec · arXiv · 2026-10-10
模块放在一起之后,长任务仍会挡路
把 LLM、检索、重排等模块分放到不同设备,可以形成流水线,但各模块耗时不均时,较快设备会等待较慢阶段。AgentWeave 采用聚合部署,让各模块跨全部可用 GPU 执行,减少这种空转。然而整条工作流按大批次推进,又会让短请求跟着长请求等待,新请求也难以及时进入。
论文因此把调度单位从整条请求细化到数据流触发的执行片段。它与只优化模型内部批处理的方案不同:拆分发生在跨模块工作流层,并且必须守住数据依赖,否则提前执行可能改变答案。
能分块的不是所有输入
系统先将工作流表示为流依赖图。可拆分数据必须能形成独立子流,而且子流结果应是完整执行结果的正确子集。例如文档可以分别建立嵌入,表达完整意图的查询却不能任意切开。
重排更微妙:候选文档可以分批到达,但全局 top-k 需要跨批次比较。AgentWeave 增加补充依赖,把先前累积的重排结果交给下一批处理,维持完整输入所要求的计算。其关键是说明中间状态怎样延续,而不是认为所有工具天然支持分块。
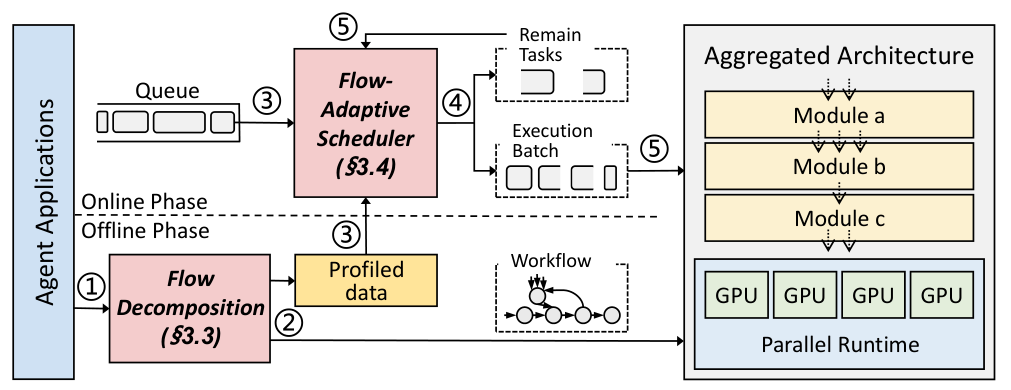
读图:下半部离线确定分解规则并测量成本;上半部按队列选择分块大小,将本轮批次交给右侧聚合执行器,剩余工作回到后续轮次。
分块越小,新请求越容易插入,调度和状态管理的轮次也越多。在线调度器结合队列状态及离线性能画像,给完成请求和未完成请求的部分进度计分,同时扣除预计累积开销。它选择的是每轮分解粒度,不承诺把长请求本身的计算量缩小。这个取舍解释了为什么尾延迟需要单独观察。
最大倍率分别出现在哪些任务
作者在相同硬件上比较 Ayo、Autellix:RAG 和 KB-RAG 使用 4 张 A100,DeepSearch 与多模态生成使用 2 张 A100。两类 RAG 主实验使用 Qwen3-32B、Qwen3-Embedding-8B 和 Qwen3-Reranker-8B;DeepSearch 使用 Qwen3-14B/4B,多模态使用 Qwen3-14B 与 Stable Diffusion 3。
四种应用的吞吐分别达到基线的 1.33×、1.81×、1.68×、1.28×;平均延迟分别缩短至基线的 1/2.28、1/2.45、1/2.08、1/2.15。摘要中的最大吞吐和平均延迟倍率来自 KB-RAG,而 2.04× 的最大 P90 改善来自 RAG。不能把这三项上限当作每个应用都能同时获得的成绩。
与仅聚合部署的消融方案相比,RAG 高负载吞吐再提高 1.19×,说明拆分机制带来额外收益。TriviaQA 上 RAG、KB-RAG 的准确率分别保持 0.8470、0.8170,GAIA 上 DeepSearch 保持 0.3097;这些是所测流程的质量结果,不构成任意工具分解都正确的证明。
适合关注复杂工作流服务的读者精读。 当前应用必须显式提供可拆分流和完整输入依赖,尚不能自动理解任意 Agent 程序。离线画像也可能随硬件或负载改变而失准;动态生产 Agent、外部工具故障、多租户仍待验证。论文没有给出误差条或显著性检验。优先看 RAG 分解例子与仅聚合部署的消融,可分清收益来自设备布局还是调度粒度。
03 · TurboProm:用可复用摘要加速指标查询
TurboProm: Low Cost and High Performance Metrics Observability at Scale
Milind Srivastava, Zeying Zhu, Peilin Xin, Yancheng Yuan, Zaoxing Liu, Vyas Sekar · arXiv · 2026-10-10
监控面板反复扫描相似指标窗口,会把可观测性本身变成计算负担。TurboProm 根据历史查询规划摘要,在摄取时预计算,并通过标明数据范围、摘要算法与载荷的 SDS 复用结果;无法优化的查询回退原后端,保留 Prometheus 查询入口。
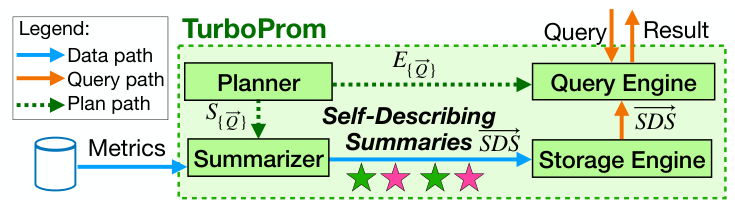
读图:Planner 决定摘要及查询改写;指标进入 Summarizer,紧凑摘要写入存储,Query Engine 读取摘要估计结果。
作者用 10 组随机查询负载、每秒 8K 测量值、每组 20 分钟验证,概述查询成本约降至一半、延迟约降至十分之一。成本以 p99 CPU 使用量衡量,未计摄取成本;大规模场景的 1.2–900× 是外推估计。近似摘要也不能等同于所有告警零误差。
值得关注的是查询间、时间窗口间复用,而非最高倍率。高频重复聚合更适合这一路径,临时查询仍依赖原后端;按摄取量收费的 SaaS 也不会自然将查询计算节省转成用户账单下降。
04 · KedgeFlow:让批准的动作与真正执行的动作一致
KedgeFlow: A Programmable Control Plane for Enterprise AI Agents
Jun He, Deying Yu · arXiv · 2026-10-10
Agent 获批操作后,仍可能替换参数、并发复用权限或因响应丢失而重试。KedgeFlow 把签名授权绑定到精确动作,由可信网关原子消费共享的一次性额度,再检查当前权限并发送请求;目标侧条件约束提交,结果未知时也不恢复额度。
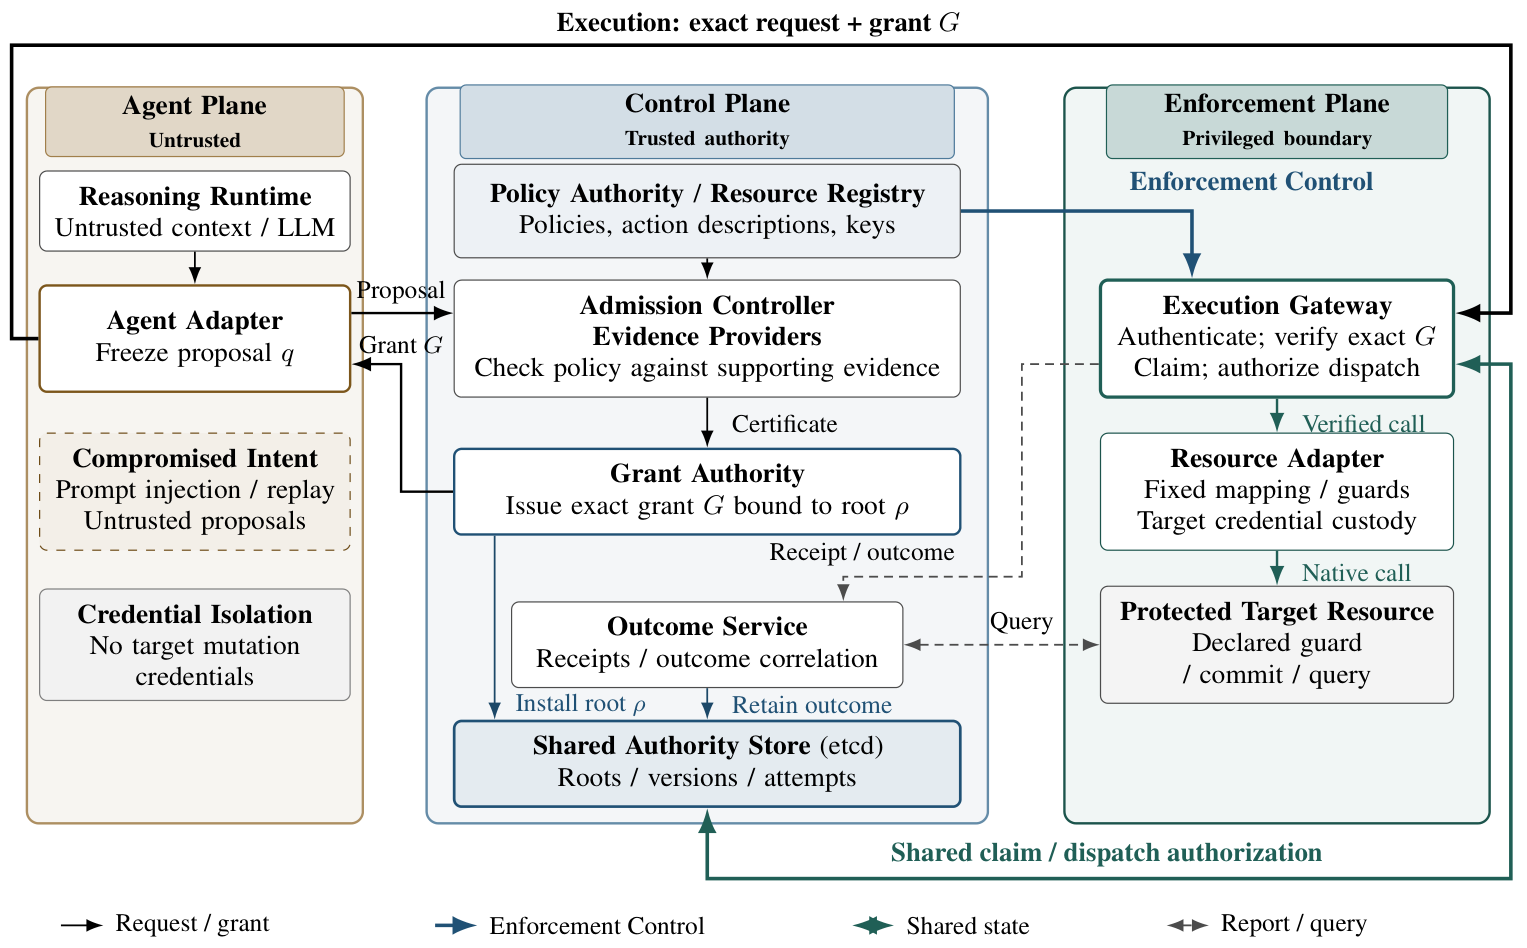
读图:左侧只提出动作,中间签发授权并保存权限状态,右侧持有目标凭据并核验执行;底部共享状态阻止同一额度被重复消费。
单机运行三个 etcd 成员,作者记录 6,560 次账本竞争中 82 个额度各成功一次;另一次 32 调用网关竞争只产生一个模拟目标提交。前者统计的是权限消费,不是完成的外部操作。
这是一项执行契约与边界验证工作。 放宽策略后,合法授权仍可导致有害动作;模拟目标上的保护也不证明真实资源具有 exactly-once 效果。其价值在于分清批准、发送和提交,生产采用仍依赖凭据隔离、所有访问路径受控及目标原生条件检查。