本期看点
Agent 系统的进展正在触及两种容易被总分掩盖的问题:测量结果是否可信,以及多轮执行中的资源是否用在了真正需要的位置。评测器审计揭示,评分函数对环境的副作用足以让后续评分读到错误终态;Prorsa 则利用工具返回、沙箱启动等生命周期信号,提前调整预填充与解码的容量。
本期优先读这两篇。 前者提供了检查评测基础设施的具体方法,后者把多轮 Agent 的执行结构转化为调度依据。另三篇分别讨论生成式奖励训练的资源迁移、Kubernetes 的知识驱动调优,以及工作流故障的责任定位。Josh Rosen 的 tracing 文章补充一个实践视角:记录模型说了什么,还不足以解释外部环境发生了什么。
01 · 评测器审计:高分可能来自被改写的终态
When Agent Evaluation Becomes Unreliable: An Empirical Study of Oracle Failures and Configuration-Dependent Measurement in an LLM Agent Benchmark
Junjie Chen · arXiv v1 · 2026-10-12
先检查量尺,再解释分数
Agent 基准通常把任务、模拟用户、工具环境和奖励函数串在一起,最后给出成功率。Junjie Chen 把奖励函数本身作为被测软件:如果判分时改动了数据库,结束后的环境还代表 Agent 的操作结果吗?这比再增加一道模型能力题更基础,因为错误的判分可能同时污染多个模型的比较。
发现的缺陷发生在参考答案回放:奖励函数重置数据库、执行参考操作以构造预期状态,却没有恢复原状态。函数当时返回的分数可以正确,直接消费该返回值的原基准 runner 不受影响;但作者的 harness 在会话结束后另行评分,第二次读取的已是参考答案留下的数据库。于是,一个没有执行写操作、只告别的轨迹,也可能被判为数据库通过。这里的风险来自评分函数与调用方式的组合。
用状态约束和已知答案分别检查
审计接口要求能创建干净环境、取得状态签名、调用 oracle,并定位可注入缺陷的类。五条不变量检查评分是否改状态、重复调用是否一致、评分顺序是否影响结果、异常时是否恢复,以及终止步骤后是否保留 Agent 终态;三组已知答案控制则检查空操作不能成功、参考解必须成功、允许的输出变体应被接受。只检查状态干净,发现不了始终返回成功的评测器,因此两组检查互补。
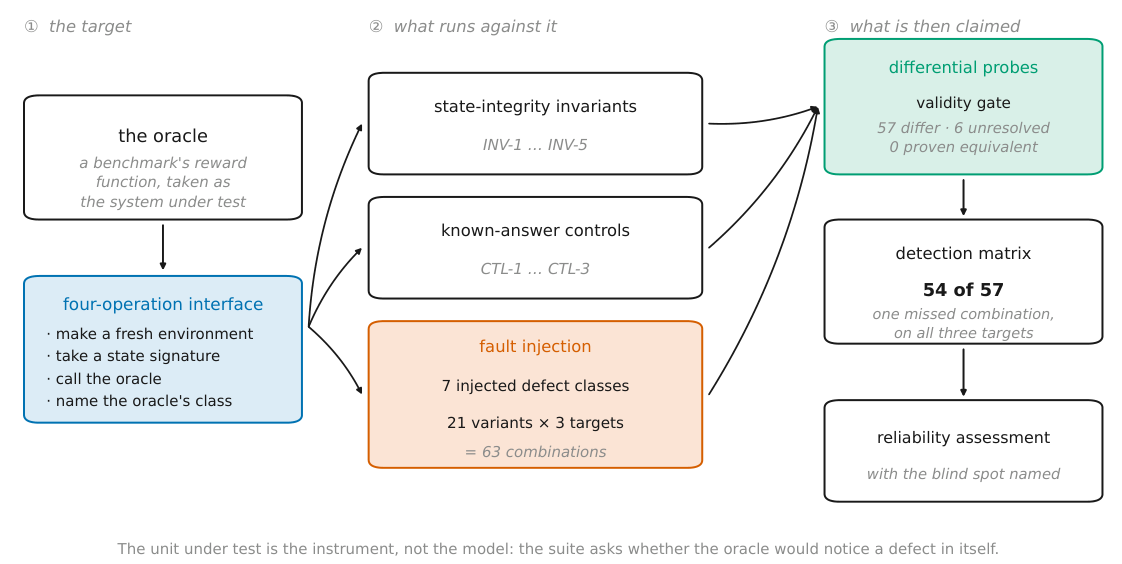
从左到右看:先暴露 oracle 的四个操作,再运行不变量与已知答案控制;右侧先确认缺陷是否可区分,才计算检测结果。
作者将七类缺陷实现为 21 个变体,在同一实现的零售、航空两个领域及一个合成领域上构成 63 个组合。其中 57 个经差分探针确认与修复版行为不同,检测到 54 个;另六个无法确定。三个漏检来自同一种吞掉内部异常的变体。论文因此支持一套有明确盲点的测试方法,不能把“覆盖七类缺陷”读成对所有实例的完全检出。
分数修正与方法边界
对 4,320 条存档轨迹,作者在干净数据库上重放工具调用,数据库通过数由 4,194 降至 2,883,总体成功率由 94.3% 降至 65.5%。数据库通过和总体成功是不同指标,后者还包含文本条件。回放中 33,402 条工具观察与存档逐字一致,137 条未经过缺陷路径的步数超限轨迹也保持原标签,为修正提供了交叉检查。
另一组 3,240 条轨迹的组件实验显示,策略文档、工具描述、错误字符串的语言配置都会改变测量;第二任务域甚至反转了用户语言效应方向。这不足以支持某种语言普遍更可靠,也不能排除跨批次模型漂移。更直接的迁移限制是:第二个独立基准无法从 API 日志重建参考终态,审计在那里没有得到检测率。
值得优先读方法与缺陷复现部分。 最可迁移的贡献是把终态完整性、重复评分和已知答案测试纳入评测器验证;它需要可重置、可回放的环境,而不只是保存一张成绩表。
02 · Prorsa:跟着轨迹生命周期调整预填充与解码资源
Prorsa: Unleashing the Potential of Prefill-Decode Disaggregation in Agentic Reinforcement Learning
Chiheng Lou, Xiangwei Deng, Bangjun Xiao, Xiaodong Ji, Yikai Zhao, Xin Jin, Hailin Zhang · arXiv v1 · 2026-10-12
多轮 rollout 改变了计算的节奏
单轮 RL 常在开始时集中处理提示,随后长时间解码;工具型 Agent 却在生成、工具执行和再次请求模型之间循环。工具返回不断带来新的 prefill,异步采样又继续注入轨迹。若预填充与解码共置,一个注意力数据并行分组遇到长 prefill,可能让其他分组的 decode 等待。即便拆开两个阶段,固定 GPU 比例也跟不上训练过程中变化的需求。
Prorsa 的增量是利用 RL 框架看得到的轨迹生命周期预测近期负载,再调整 worker 角色。它分别选择两个阶段的并行配置,并把 decode 的 KV 容量约束纳入分配,避免只按 token 速率配资源、却装不下并发长轨迹。
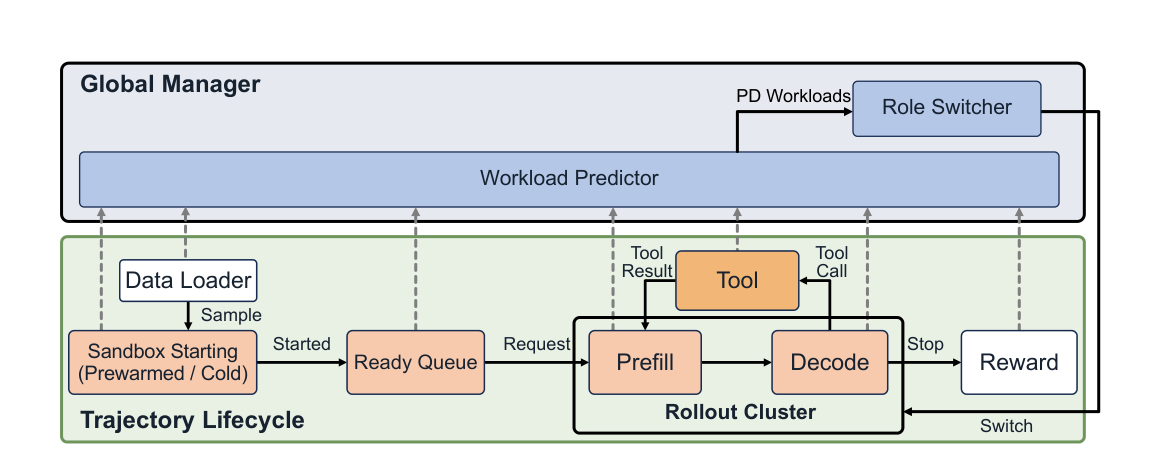
下方轨迹在 prefill、decode 与工具执行间循环;上方汇集生命周期信号,预测需求并调整两类 worker 的数量。
预测的是即将到达的工作
每条样本先启动预热或冷启动沙箱,首次请求进入 ready queue;prefill 完成后转入 decode,工具调用完成又生成下一次请求,轨迹终止则进入奖励阶段。预测器综合待发样本、正在启动的沙箱、已排队请求及在途工具,利用历史耗时和已经过去的时间估计未来窗口内的到达量。
已排队和正在 prefill 的请求计入完整提示长度;预计完成 prefill 的请求提供 decode 新增 KV 需求。这里没有预测后续输出长度。运行观测持续更新耗时统计和偏差修正,角色切换器再结合已有 decode KV 占用、实测 prefill 处理能力和 GPU 预算选择比例。实验使用十秒预测窗口,因而工具等待也成为提前安排容量的信号。
预测器也有误差。在 MiMo-V2.5-Pro 的两类 Agent 任务上,prefill 的加权绝对百分比误差为 5.40%–14.37%,decode 入场量为 5.19%–13.69%;工具耗时更不稳定的通用任务误差较高。这提示收益依赖于在线统计能否及时跟上负载变化。
加速来自哪些部分
作者基于 Verl 与 SGLang,在 16 台、每台八块 GPU 的集群上评估;每台配置八张 400 Gbps RDMA 网卡。模型为 FP8 的 Qwen3-235B-A22B、DeepSeek-V3.2 和 MiMo-V2.5-Pro,Agent 任务使用 SWE-smith,以及 APEX-Agents、Toolathlon、MCP-Atlas,GRPO 的 Agent 分组大小为 32。
在同步及允许陈旧度为 2、8 的异步设定中,两个 Agent 任务的 rollout 相对 PD 共置加速 1.11–4.05 倍。这包含阶段拆分、并行配置和动态调度的共同收益;不能全归功于预测器。以 MiMo-V2.5-Pro 对比调优后的固定 PD 比例,角色切换贡献的是 1.0–1.44 倍。论文另报轨迹完成延迟的改善,它与整轮 rollout 时间也不是同一个指标。
边界来自单轮 AIME25 数学任务:相对共置,归一化 rollout 时间为 0.86–1.28,多数设定反而更慢,因为预填充与解码重叠较少,传输和切换开销无法充分摊销。值得读生命周期预测与静态比例消融。 这项工作说明长轨迹的等待结构可以帮助调度,但能否受益取决于阶段重叠、KV 压力及工具耗时稳定性,不能直接推出所有 RL 训练都会更快。
03 · PivotRL:在生成、奖励与训练之间移动 GPU
Efficient Resource-Shiftable RL Post-training with Generative Rewards
Yanfeng Zhao, Haoyang Li, Sheng Lin, Yuming Zhou, Jiawei Jiang, Bin Cui, Fangcheng Fu · arXiv v1 · 2026-10-12
生成式奖励模型本身也要生成长序列,因此 rollout、奖励评估和策略训练的瓶颈会轮流变化。PivotRL 将集群 CPU 内存组织成全局参数存储,让 GPU 换角色时取得对应模型;再用共享等待队列迁移序列,由规划器比较持续吞吐收益与切换成本。
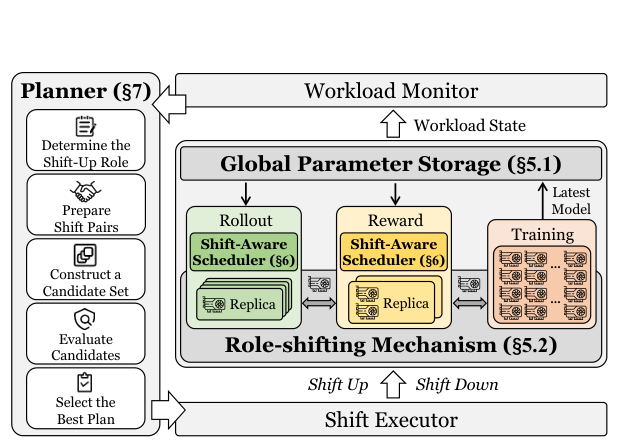
从监测器到规划器再到执行器形成控制回路;全局参数存储和阶段调度器支撑实际迁移。
在 128 块 H20 96GB GPU、DAPO-Math-17k 训练和 AIME-24 验证的四组模型实验中,端到端吞吐相对共置提升 1.81–2.05 倍,相对静态分离提升 1.50–1.95 倍,每组重复三次。角色切换需要数秒,序列迁移还会重新 prefill;规划窗口过大又会引发过度切换。值得关注的是把迁移代价写进决策。 数学奖励场景下的收敛曲线接近,并不等于长时间工具交互也已验证。
04 · Kubernetes 调优:把专家规则变成配置约束
Domain-Knowledge Driven Configuration Tuning of Kubernetes Workloads
Federico Imberti, Luca Cavagnis, Stefano Cereda, Giovanni Gibilisco, Claudio Menghi · arXiv v1 · 2026-10-12
这项工业研究把专家经验整理为配置规则目录,再通过启发式或优化求解器生成 CPU、内存配置。目录共 65 条规则,本次聚焦 workload 层的 36 条;目标是在控制成本的同时减少约束违反,避免只按利用率压缩资源。
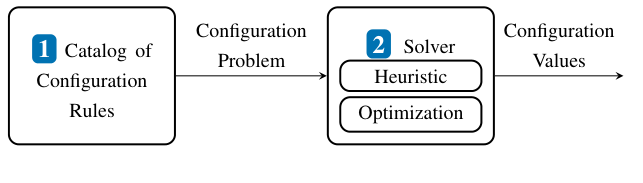
规则目录定义配置问题,两条求解路径给出配置值;图中没有在线试错控制回路。
作者分析两个工业应用、八个集群的 14,742 个 workloads。在 Apple M4 Max、36GB 内存上,两种求解器平均每次配置提取耗时分别为 0.71 秒和 45.54 秒,体现速度与更充分约束求解的取舍。成本来自 CPU、内存公开单价估算,不能当作已兑现账单节省;正文所列平均成本与报告的差额还存在算术不一致,不宜直接采用其精确节省额。更适合阅读规则建模与求解过程,规则满足度也不能替代线上性能验证。
05 · 工作流故障分类:同一症状背后的责任边界
Why Agentic Workflows Fail: A Taxonomy Derived from Literature and Empirical Data
Xin Li, Rami Bahsoon, Tao Chen · arXiv v1 · 2026-10-12
故障分类同时记录责任来源、具体类型、工作流阶段和 Agent 能力,避免把工具服务失败与 Agent 选错工具混在一起。作者将 397 条文献记录与来自 229 个仓库的 1,196 条 GitHub 故障片段放入统一分类,形成 65 种类型。
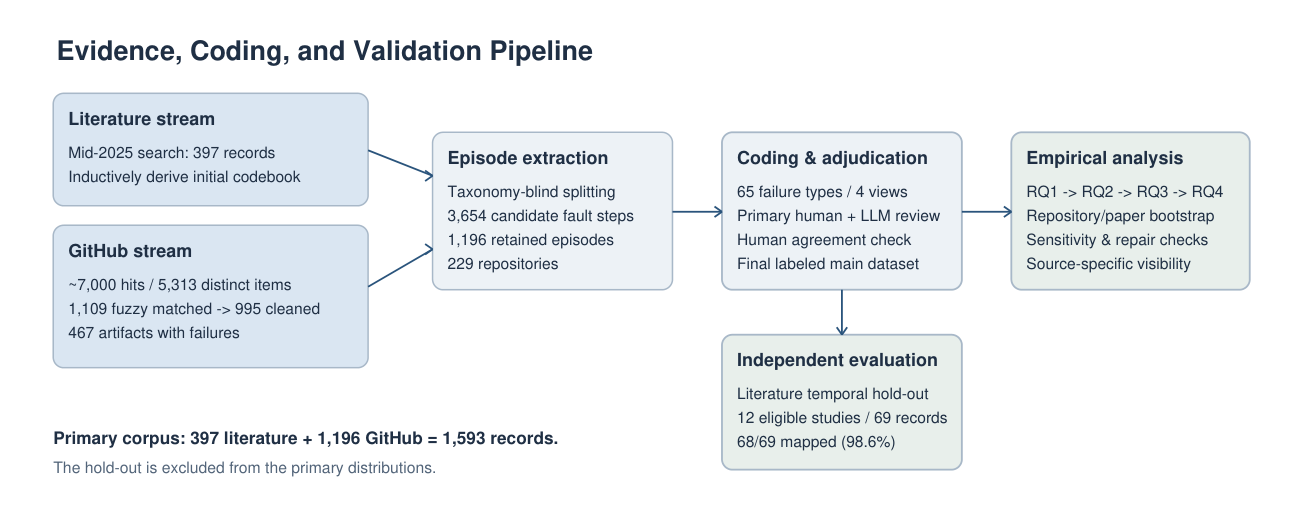
上方构造并分析主数据集,下方用后续文献检查分类覆盖;时间留出集不混入主分布。
在有效阶段—能力矩阵中,“迭代执行 × 行动”占 GitHub 记录的 771/1,189(64.8%),文献为 56/397(14.1%)。分仓库重采样等检查后差异仍在,但这说明两种来源看见的问题不同,不能直接推算生产故障率。后续 69 条文献故障中 68 条可映射到既有类型。适合作为诊断分类框架阅读;它尚未证明使用该分类能提高修复成功率,人工与 LLM 辅助编码也仍可能遗漏上下文。
延伸阅读:轨迹要连接到环境证据
Agent Traces: Patterns for Capturing Agent Execution · Josh Rosen · 2026-10-12
Rosen 从模型接口、harness 插桩、原生会话记录、分布式追踪、环境证据、语义评估和测试数据集几个角度梳理 tracing。最有用的区分是:模型提出工具请求,并不等于工具真的执行,更不等于预期状态已经改变。文件差异、测试结果、页面快照或数据库变更,需要作为工件连接到对应操作。
这与评测器审计形成呼应:仅有调用轨迹,未必足以重建可信终态。文章也提醒,生产轨迹可以成为回归案例,但环境变化与生成随机性意味着轨迹不天然可重放。它是一篇架构综述,没有给出新的故障检测基准或产品性能对比。原帖没有适合这段机制解读的独立架构图。