本期看点
本期优先关注两种让证据更贴近执行的方法。Interaction-as-a-Judge 让裁判操作网页和游戏,检查静态代码判断漏掉的行为;RankLens 则保留一个 rank 的真实计算,用通信记录重建分布式现场。前者提高评测和修复的可信度,后者降低反复诊断的资源门槛,但二者都需要明确证据覆盖到了哪里。
系统方向还有一组围绕“少重做”的进展:ATTUNE 避免把错误配置当作吞吐优化,FastEEP 保留扩缩时的昂贵运行状态,光学 KV 网络与 CacheSmith 分别优化缓存搬运和选择性重算。Tremulant 与 CSNB 则提醒读者,温启动和局部数值校验仍会留下尾部风险。下文先展开两篇重点,再快速比较这些机制与适用条件。
01 · Interaction-as-a-Judge:让裁判真正操作应用
Interaction-as-a-Judge
Wayne Chi, I-Hung Hsu, Li Chen, Wei-Lin Chiang, Ion Stoica, Anastasios Nikolas Angelopoulos, Ameet Talwalkar, Chris Donahue, Cho-Jui Hsieh · 2026-10-13
网页能够构建、代码看似合理,按钮却可能没有作用,游戏也可能在切换场景时卡住。Interaction-as-a-Judge 把操作产生的可见行为加入评判证据,研究它能否改善人类偏好预测、需求核验以及后续修复。值得精读之处,是把“会不会使用应用”和“会不会评价应用”拆开比较,而不是只报告一个端到端分数。
从点击轨迹到评价,再到反馈
输入包括用户需求、候选应用及可选的代码和静态截图。计算机使用 Agent 操作应用,形成截图、动作和推理轨迹;裁判再据此比较两个应用,或将明确需求标为正常、损坏、无法验证。偏好比较交换两次候选顺序,减轻位置偏差。轨迹也可用来训练奖励模型,或者接回生成器构成修复循环。
作者比较三种取证方式:逐步观察再行动、一次规划全部动作、启发式选择控件。逐步交互能根据界面变化调整下一步,但每步都要调用模型;一次规划便宜,却难以应对预期外状态。主要偏好实验给每个应用 30 次工具调用预算,交互模型是 GPT 5.6 Luna。这里增加的是行为证据,不是保证穷尽所有功能路径。
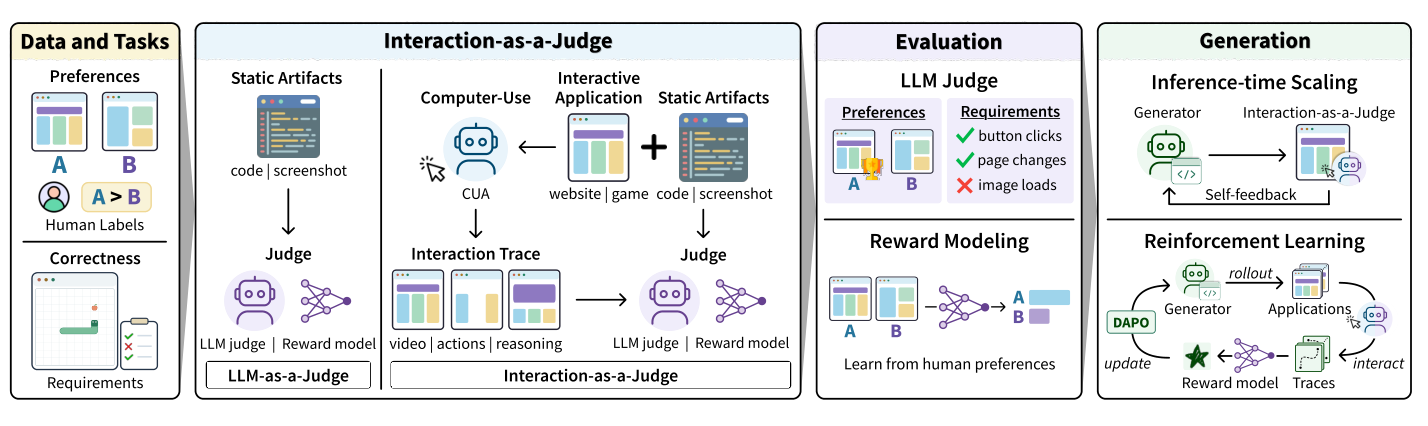
读图:左侧区分偏好与需求标签,中间由实际操作形成轨迹,右侧分别进入裁判、奖励模型和生成反馈循环。
数字需要连同裁判与任务一起读
ArenaPreferences 包含 6,858 对应用,覆盖七类网页开发任务;ArenaCorrectness 则有 222 个游戏版本、412 条人工核验需求,其中 323 条损坏、89 条正常。前者过滤了构建失败和偏好平局,后者来自用户投诉与修复记录,二者衡量的质量维度不同。
Gemini 3 Flash 的偏好准确率从仅代码的 65.6% 升至逐步交互的 69.1%,加入静态截图时为 67.6%;但 GPT 5.6 Luna 裁判没有显著收益。GPT 5.6 Sol 的需求核验从 77.0% 升至 81.6%,这是正常与损坏两类准确率的非加权平均,不能直接当作全部需求的总体正确率。
修复实验由 GPT 5.6 Luna 执行五轮修改,用更强的 GPT 5.6 Sol 复核。采用交互式复核时,修复成功率为 75.5%,仅代码反馈为 55.4%。这支持交互反馈改善修复,但最终分数仍依赖模型裁判,不是逐项人工验收。
对编码 Agent 评测的推进与边界
训练实验用 Qwen-3.5-9B、DAPO 和交互奖励模型,在不含游戏的六类任务上训练;相对代码奖励,生成代码长度下降 35.7%,构建失败率从 18.7% 降至 11.5%。相对基础模型的胜率增益为 6.72 个百分点,由自动 rubric 裁判在成功构建并渲染的应用上测得,不能解释为无条件的人类胜率。
最值得继续读的是交互策略对比与修复实验:它们展示了评测证据怎样转化为改进信号。局限也很具体:成本限制了更强交互模型的试验,需求发现仍困难,有限轨迹可能根本没有触发隐藏故障。交互评测适合补充代码和测试证据,其收益取决于取证能力与裁判是否会使用这些证据。
02 · RankLens:用单 GPU 保留分布式训练的局部现场
A Distributed View from a Single GPU: RankLens for Distributed Training
Yufan Wang, Yihao Zhang, Yi Liu · 2026-10-13
分布式训练中的异常往往只需检查一个 rank,却要反复占用整个集群才能重现。直接改成普通单卡训练又会改变分片、进程组和通信路径。RankLens 的切入点是:目标 rank 继续运行真实代码,把其他 rank 对它的影响压缩到通信边界,让重复调试与局部调优只占用一张 GPU。
保存远端的影响,执行本地的计算
输入是原训练脚本、并行配置和执行记录。系统先采集训练状态、进程组通信、底层集合通信三层轨迹;单卡回放时,虚拟化 world size、rank 身份、拓扑与进程组,让框架仍沿原来的分布式控制流执行。它不是将模型缩小后重新跑一遍,也不是把本地算子时间全部换成预测值。
遇到通信调用时,系统按训练位置、进程组、操作类型、消息大小与提交顺序匹配记录。只检查路径时保留结构即可;分析等待和重叠时注入已记录或估计的完成时间;调试数值异常时再恢复通信后的张量。替代的 Work 对象保留提交、完成、等待之间的依赖,避免把异步通信错误地改成提交处阻塞。
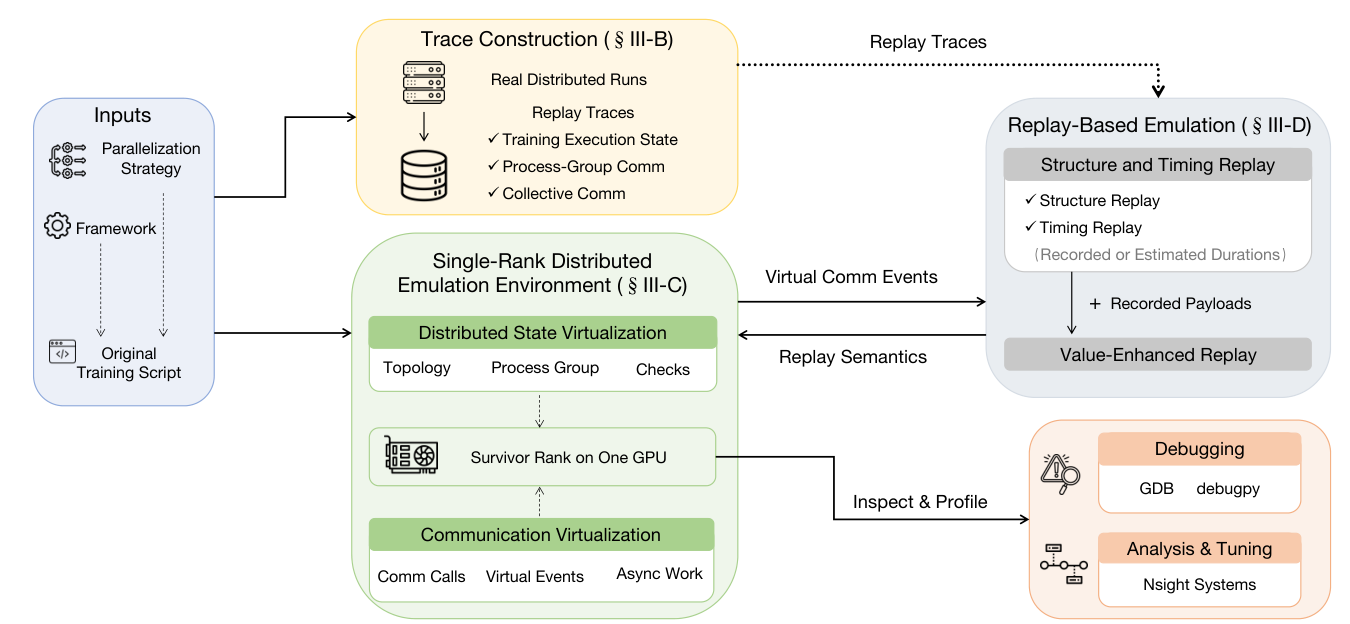
读图:上方收集真实运行轨迹,中间在单 GPU 执行目标 rank,右侧按任务恢复结构、时间或张量值,再接入调试工具。
这种分层很重要:记录通信元数据相对便宜,保存所有张量则可能显著拖慢采集。数值回放还要求本地状态、输入与原执行对应,恢复的是已记录远端结果在本地造成的症状,不会重新求解远端所有进程。已有 GDB、debugpy 和 Nsight Systems 可以继续用于检查与分析。
保真度在哪些条件下成立
作者在 A100 PCIe 40GB、节点间 100 Gb/s RoCEv2 环境中,用 DeepSpeed 和 Megatron-LM 比较 8–64 GPU 配置与单 GPU 回放。训练张量通信签名计数匹配率为 100%,步时相对误差低于 5%;这个结构指标排除了部分管理接口,不能扩大成所有运行行为都完全相同。
受控异常实验恢复了通信引入的 NaN 及其对参数更新的影响,但远端故障位置由注入过程指定,并未证明自动定位远端根因。更能说明边界的是调度修改:推迟一次等待后,回放估计步时减少 23.60%,真实双 GPU 执行减少 14.75%,高估 8.85 个百分点。真实通信与计算的资源竞争没有被完全复现。
价值在于便宜地反复观察
对 355M–1.5B 模型、8–64 GPU 的计时轨迹采集,作者测得开销低于 4%;完整张量记录开销明显更高,应按诊断需求选择。没有目标执行的计时轨迹时,可从历史相似通信估计持续时间,但这不意味着可以凭空重建未知的通信输出。
这项工作适合关注分布式诊断与训练工具链的读者。优先看三种回放模式、异步语义替换和调度对照实验:前两者解释为什么单卡仍有分析价值,后者提醒我们如何使用预测结果。局部代码调整若破坏了轨迹与控制流的对应关系,就越出了回放依据;收益方向可用于筛选优化,最终幅度仍需要目标环境验证。
研究动态
03 · ATTUNE:把正确性门禁放在吞吐调优之外
ATTUNE: Agentic Throughput Tuning for LLM Training
Leo Fan, Hongyang Wang, Wenbo Chen, Jingguo Liu, Xian Li, Xuan Wang, Ruochen Wen, Yiming Yan, Hao Wu, Zheshen Wang, Benoit Dumoulin · 2026-10-13
训练配置跑得更快,可能只是无意改变了训练目标。ATTUNE 用单个编码 Agent 诊断瓶颈、逐次调整配置,并由独立脚本约束预算和验收:先检查改变目标的参数与已知缺陷,再比较候选与基线的 20 步损失曲线。
在同一软件栈运行公开配方作为基线,128 张 B200 上,三次调优的平均吞吐增益为 Llama-3.1-405B 的 6.7% 和 GLM-4.5 的 33.9%;128 张 H100 上的 Mixtral-8x22B 没找到超过噪声带的收益。它衡量的是配方迁移到该环境后的改进,不是超过原作者最优部署。
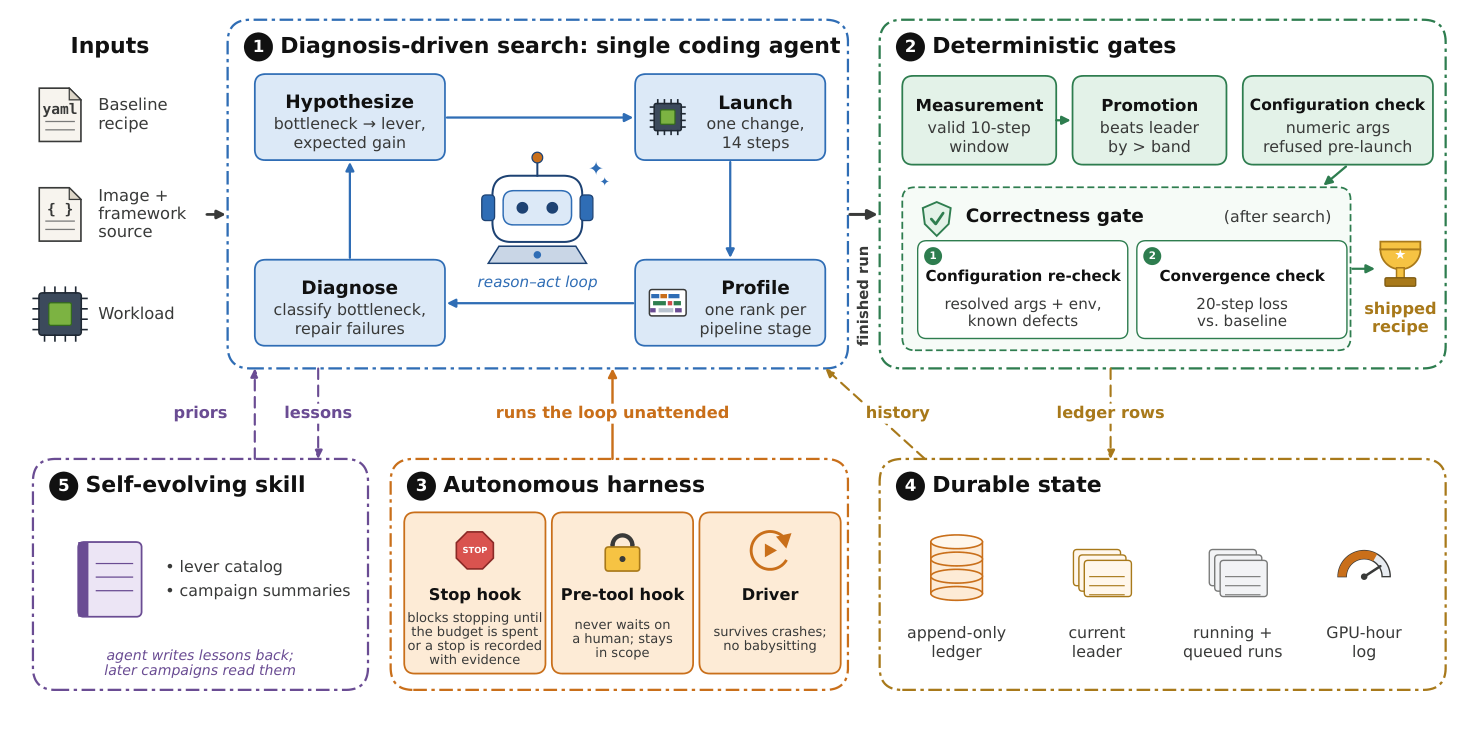
读图:左上提出假设、运行和诊断,右上独立检查配置与损失,下方保存经验、执行控制与预算记录。
门禁放过全部 133 次合法运行,拦下 24 次故障运行中的 16 次,漏掉对短期损失影响轻微的 8 次。值得看的是搜索与验收分离;短损失曲线仍不能保证完整训练收敛。
04 · 光学 KV 网络:在 prefill 期间提前预约电路
An Optical KV Cache Network for Disaggregated LLM Serving
Seongwon Yoon, Shimeng Yu · 2026-10-13
长上下文 Agent 换到另一台 decode 实例时,可能要搬运整个历史 KV,而 prefill 只计算少量新增 token。论文把 KV 传输送入光电路交换网络:旧前缀在 prefill 开始时预约,新 KV 在最后一块 prefill 开始时预约,尽量把机械交换机重配置延迟藏进计算。
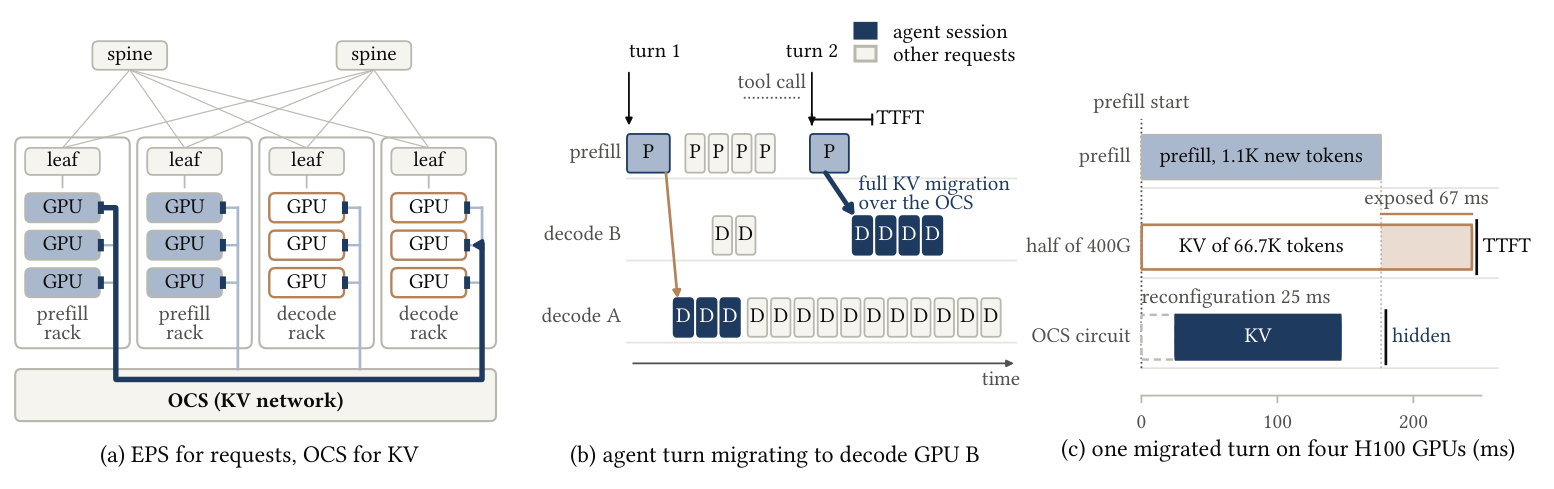
读图:左侧保留请求的电分组网络,中间显示跨轮迁移,右侧以测量驱动的时序示例说明预留电路如何覆盖重配置与 KV 传输。
作者用四张 H100 上测得的 Llama-3.1-70B prefill 时间驱动 128/256 GPU 流级模拟。配合 WDM 光模块,256–3,072 GPU 单级网络的成本模型为 2:1 电分组网络的 0.55–0.78 倍;在 60% 负载下可容忍 50 ms 重配置。性能优势主要相对 ECMP,强自适应路由与其接近。
这是网络与调度可行性研究:decode 被建模为 KV 接收端,不包含 decode 计算;成本还依赖光模块、端口价格与链路余量,不能解读为已部署的整套服务收益。
05 · FastEEP:扩缩专家组时保留昂贵运行状态
FastEEP: Fast Intra-Instance Elastic Scaling for Expert-Parallel MoE Serving
Yunfei Feng, Jingkai He, Shiqi Liu, Cheng Zhang, Dong Du, Erhu Feng · 2026-10-13
MoE 服务调整专家并行宽度时,重建 worker、通信组和 CUDA Graph 会带来长停顿。FastEEP 预先初始化最大拓扑,保留执行上下文与虚拟地址,只改变活跃成员和物理显存驻留;请求、专家映射、NCCL 子组与 NIXL 可达性在短暂静止点一致切换。
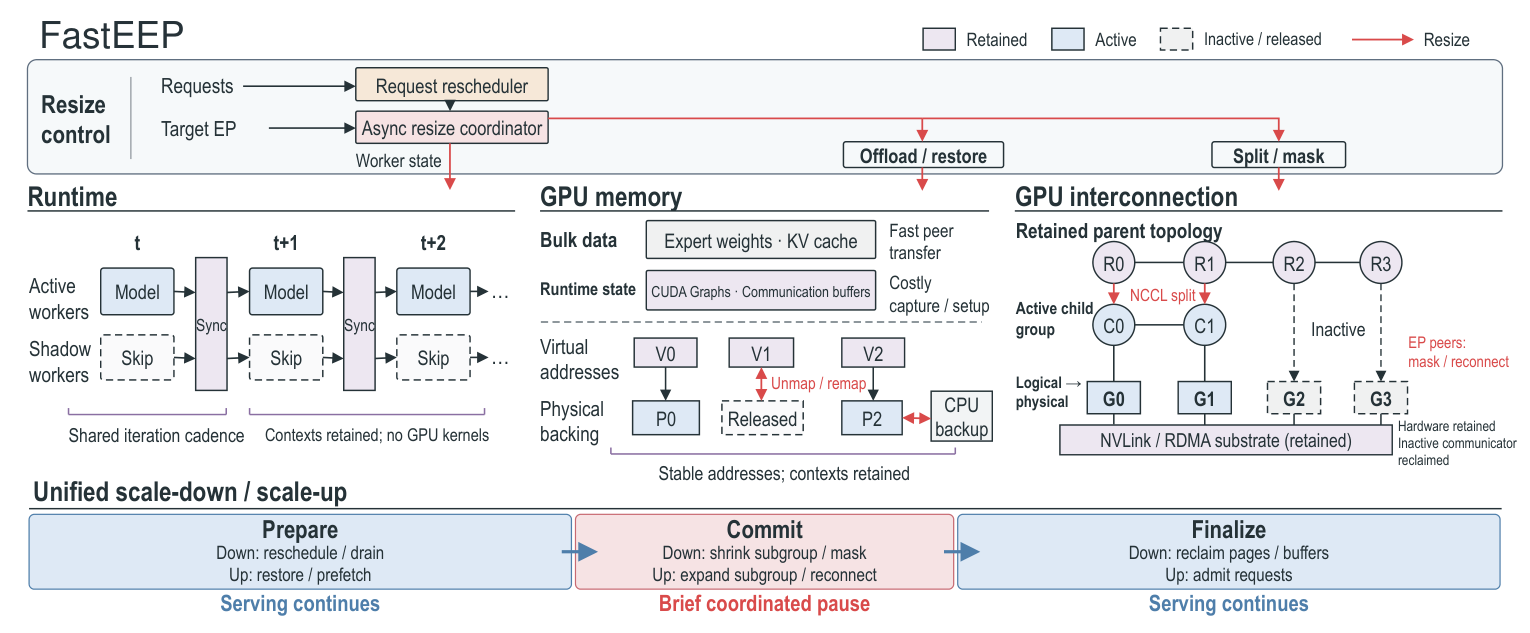
读图:三列分别保留 worker 上下文、虚拟地址和父通信拓扑;底部准备、提交、收尾阶段协调资源切换。
两节点、16 张 H20-3e 的六模型实验中,普通 FastEEP 扩缩耗时 4.2–13.4 秒。对能够运行的 vLLM Elastic EP 模型与转换组合,加速为 4.5–11.7 倍;两种模型的该基线无法成功运行,不属于这一倍率的比较集合。
值得读的是物理显存回收与逻辑状态保留如何兼容。弹性范围受启动时最大拓扑限制,扩容仍要有可用显存,更大拓扑变化需重建;这些数字是扩缩延迟,不是稳态推理吞吐倍率。
06 · Tremulant:温启动也会制造极端长尾
Tremulant: Latency in Serverless Platforms beyond the 99th Percentile
Linus Gustafsson, Trever Schirmer, David Bermbach · 2026-10-13
优化冷启动并不能消除 FaaS 的全部长尾。Tremulant 重新分析七个平台数百万次调用,主数据为连续 53 天的空函数请求,以客户端首字节延迟衡量平台及网络路径影响;再用四份公开数据检查现象是否持续存在。
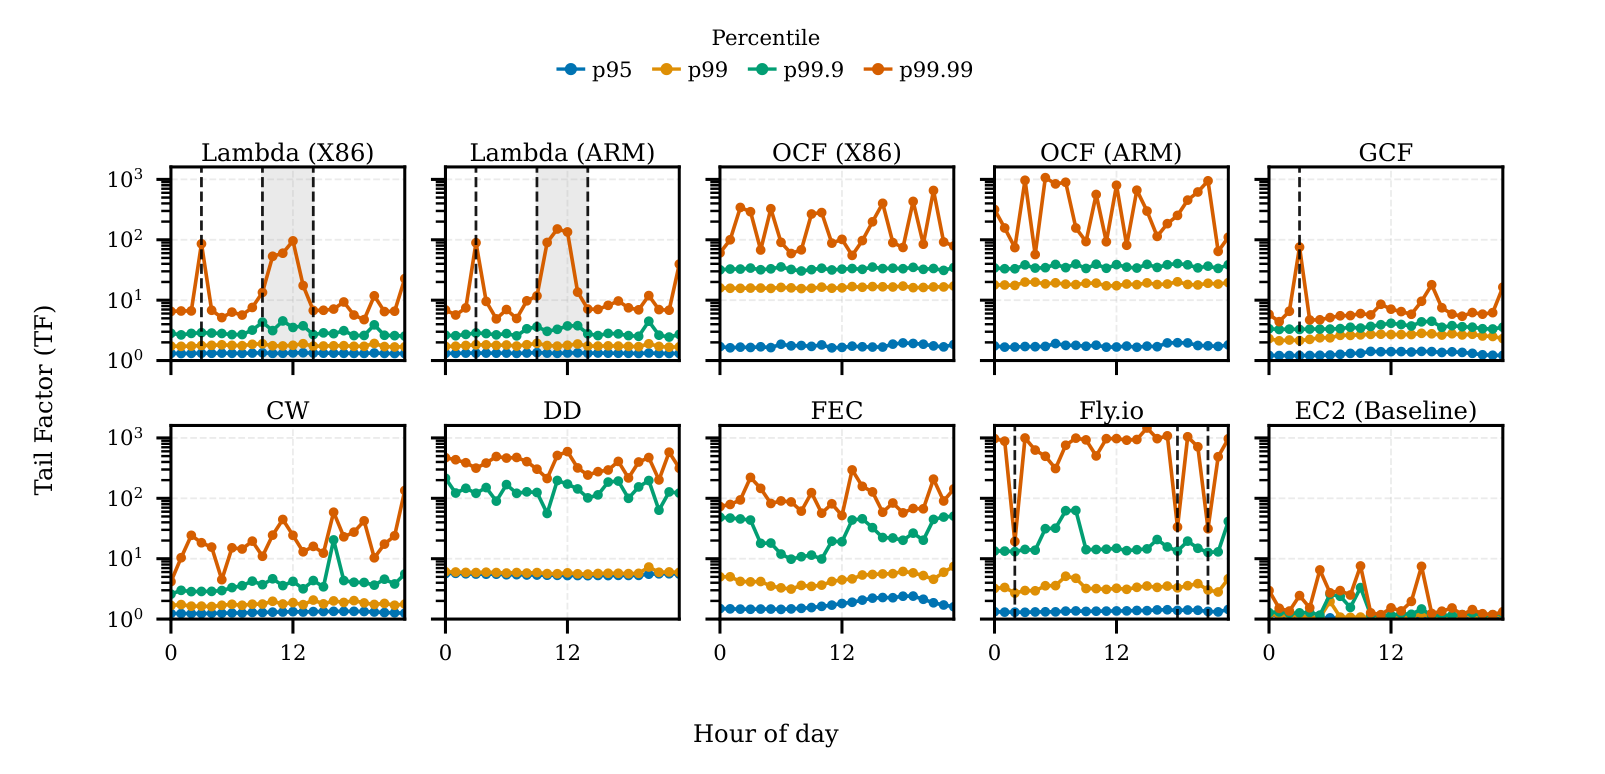
读图:纵轴是分位延迟相对中位数的倍率,橙色 p99.99 曲线揭示更极端的尾部;FEC 面板含全部调用。原文无方法架构图,此处采用直接支撑结论的结果图。
Deno Deploy 的 p95/p50、p99/p50 分别约为 5.43、5.85,到了 p99.9 和 p99.99 则升至 138.46、424.05。只看 p99 会漏掉分布末端的陡增。图中的 Fastly 因不保留全局状态、所有调用都被标为冷启动,使用全部调用,不能当作纯温启动数据。
这是一项测量研究,没有给出通用消除机制;空函数放大了相对延迟,VM 基线也并非同期采集。对多函数串联服务,最直接的启发是分别报告冷、温调用的更高分位及样本数,而非把偶发慢请求全归因于冷启动。
07 · CSNB:低成本数值校验需要按算子选择
Revisiting Cauchy-Schwarz Norm Bounds for SDC Detection in LLM Inference
Anton Altenbernd, Dylan Everingham, Philipp Wiesner, Odej Kao · 2026-10-13 · SoCC ’26
CSNB 利用输入向量范数给矩阵乘法输出设上界,越界即报警,相比校验和式 V-ABFT 减少校验计算。作者在 L40S、BF16 推理中向线性层输出注入 1、2、64、256 位翻转,覆盖 GSM8K 与 SQuAD v2,检查生成 token 序列是否偏离无故障参考。
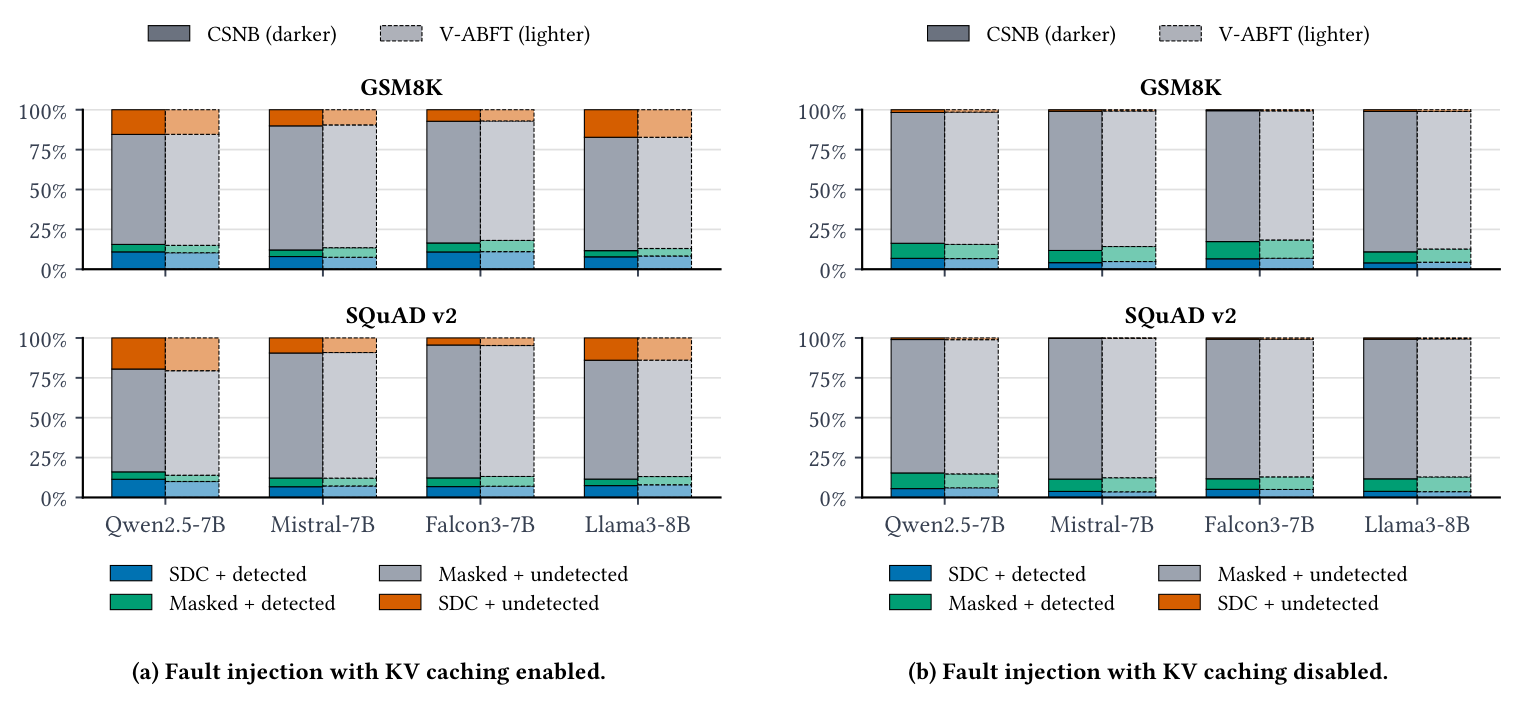
读图:左右分别开启和关闭 KV 缓存;颜色区分检测情况与输出是否变化,橙色表示未检出的输出变化,深浅柱分别代表两种校验。
稠密模型受测线性层平均保留 V-ABFT 99% 的检测能力,校验开销下降 87%,单独评估的阈值计算开销下降 67%;但 Mixtral-8x7B 路由门只保留 55% 的检测能力。99% 是相对基线,不是所有故障的检出率;两项开销也不能相加成端到端加速。
原文没有方法架构图,结果图显示局部漏检可能经 KV 缓存继续传播。FlashAttention 内部矩阵乘法不在保护范围,序列变化也不等同语义错误。这项研究的价值是明确保护对象,而不是给整个推理系统提供正确性保证。
08 · CacheSmith:把回答质量与首 token 时限一起调度
CacheSmith: Accurate RAG Serving under Latency SLOs with Adaptive KV Reuse
Xinyue Ma, Damin Lee, Aashaka Shah, Myeongjae Jeon · 2026-10-13
RAG 复用独立文档块的 KV 会丢掉跨块注意力,固定比例重算又难以适应排队和请求差异。CacheSmith 将过程拆成 WarmUp、Probe、Patch:先恢复部分完整层,再提取 token 选择信号,最后按预算修补关键 token;调度器同时决定组批与预算,运行时监测偏差后可重新规划。
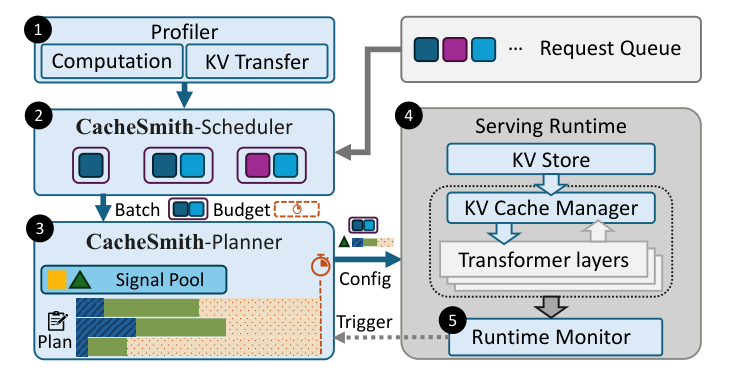
读图:左上离线测量成本,调度器交付 batch 与预算,规划器选择重算配置;右侧加载 KV 并执行,监测器在偏离预算时触发重规划。
在 RTX PRO 6000 上,作者以单卡 Llama-3.1-8B 和双卡 Qwen3-32B 评估四类任务。主要实验的 96 种任务、到达模式与时限组合中,93 种超过事后选择的 BestStatic,论文报告质量门控 SLO 达成率提升 2–27.5%。该指标要求同时及时且答对:检索/问答采用精确匹配,另两项采用 F1 高于 0.5。
值得看的是重算与排队的联合取舍。在线规划依赖离线成本和质量分布,不能保证每个请求的答案质量;部分基线共用作者重实现的未调优 Probe 内核,性能比较应保留这个条件。
项目动态:vLLM 接入 ReplaySSM
vLLM 官方公告 · @vllm_project · 2026-10-13
vLLM 宣布已支持 Mamba2 标准解码,以及采用 FlashInfer 后端的多 token 预测(MTP)路径。ReplaySSM 缓存 SSM 输入,并在需要时才更新 checkpoint,以减少循环状态的内存流量。对状态空间模型服务而言,值得关注的是状态更新与内存访问的实现路径;原帖没有给出这一 vLLM 配置的完整基准条件,不能直接把引用帖中的最高加速倍率当成集成后的保证。原帖无适合的机制配图。