本期看点
推理效率的改进正在深入不同执行层。TokenGate 学习哪些 token 值得继续计算,Koi 学习哪些部署方案在当前集群里有效;缓存构建、跨区域发现、驱动层共享和跨模型编译,则分别处理峰值内存、请求路由、重复驻留与算力空隙。它们优化的对象不同,不能把各自加速倍数相加。
另一条主线是执行依据:Agent 为什么继续检查、哪条局部错误被后续步骤吸收、模型输出怎样进入程序控制流,以及谁有权批准结论或网络连接。这里最值得关注的变化,是把最终成功之外的过程和权限做成可检查对象。
优先读 TokenGate 与 Koi。 前者有明确的质量—资源曲线与训练机制,后者结合真实异构集群和模拟,展示如何把模型提议纳入受约束的系统闭环。
01 · TokenGate:让模型学会哪些上下文值得继续计算
TokenGate: Adapting LLMs for Fast and Memory-Efficient Prefill with Learned Token Pruning
Liana Patel, Rishabh Ranjan, Ion Stoica, Matei Zaharia, Carlos Guestrin · 2026-10-19
长文档和代码仓库输入的代价,不只在于生成答案时读取 KV cache。标准 Transformer 在 prefill 阶段会让每个 token 穿过全部层,产生计算和中间状态。免训练剪枝可以提前丢弃部分 token,却依赖注意力等启发式信号;剪得越早,节省越大,重要信息也越容易被误删。TokenGate 值得优先读,因为它把“保留什么”变成可学习决策,并让模型一起适应这项决策。
从打分到可训练的稀疏计算
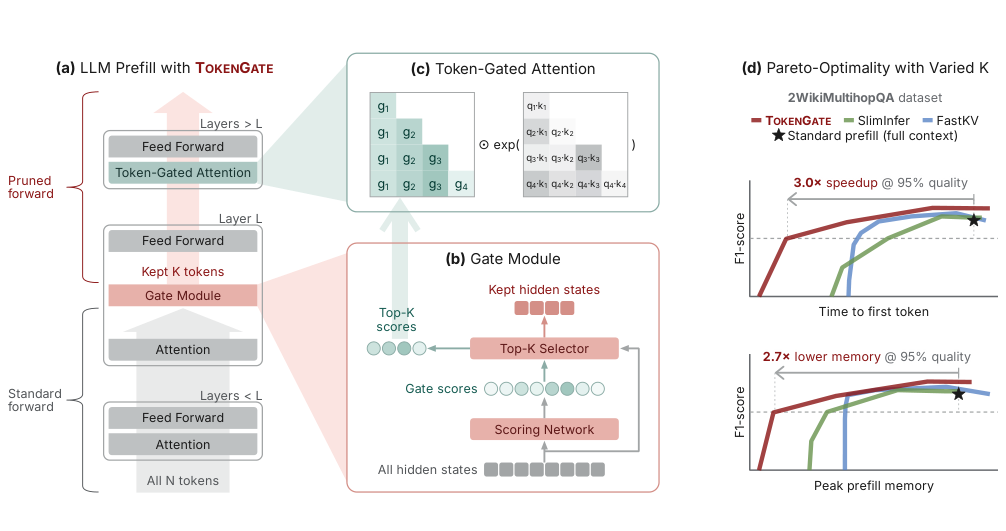
先完整处理上下文,再由 gate 选择 token;上层只处理保留项,重要性分数同时进入注意力计算。右侧展示质量与时延、内存的取舍。
在选定层,轻量 MLP 读取 token 表征并产生分数,top-K 选择保留的文档 token;问题、答案或指定的不可剪枝 token 另行保留。之后的层只继续计算这些位置,被删项不再生成上层 KV。下层已经付出的计算和缓存仍然存在,因此它不是把整个输入直接缩短到 K 个 token。
难点在于 top-K 的离散选择。作者将保留项的 gate 分数放入上层注意力权重,使任务损失能够沿这些分数回传;每个注意力头的缩放和长度相关温度则调节剪枝后的注意力分布。训练同时使用全上下文和随机较小预算的损失:前者给所有 token 学习信号,后者训练压缩能力。gate 与 LoRA 参数共同更新,区别于在不变模型上加一个筛选器。
这也解释了它的适用前提。论文考虑问题在前、文档在后的请求,让文档表征能携带问题信息;它需要任务适配数据和训练,而不是加载任意模型就获得相同收益。消融显示,学到的选择器优于随机选择;即使随机选择,经过联合适配的骨干也更耐剪枝,说明收益包含选择与表征适应两个部分。
数字对应什么条件
作者在 Qwen3-1.7B 上比较代码补全、多跳问答、摘要、医学信息抽取和检索任务;基线同样经过 LoRA 微调。单张 A100、BF16、batch size 1 的推理计时中,在匹配全上下文任务质量的点上,TTFT 加速为 1.4–11.3 倍,峰值 prefill 内存降低至原来的约 1/1.5–1/3.4。这些是不同任务的范围,不能当作所有请求的固定加速。图中的问答案例采用另一条件:保留全上下文质量的 95% 时,TTFT 为 3.0 倍加速、内存为 2.7 倍降低。
Qwen3.5-2B 混合架构上的 NIAH-32K 实验也有效:在匹配质量时,第三层 gate 达到 3.8 倍 TTFT 加速。更早剪枝可进一步提速,但会出现质量损失。训练每步约慢 1.3 倍,总训练时间随任务变化;并非所有任务都更省训练成本。
阅读判断:这是面向已有模型的适配方法。 最有价值的是打通剪枝与任务损失的梯度路径,以及公平基线的实现细节。当前结果主要来自小模型、单请求与指定任务;对高并发 serving 的吞吐、长输出延迟和跨任务质量,还不能从 TTFT 曲线直接推断。
02 · Koi:用部署证据校准异构推理规划
Koi: Evidence-Guided, Self-Calibrating Planning for Multi-Cloud, Heterogeneous LLM Inference Fleets
Mankeerat Sidhu, Gangmuk Lim, Hetarth Chopra, Maximillian Eisenberg, Quan Hao Ng, Aryan Gosaliya, Shu Liu, Luka Govedič, Jiaxin Shan, Hongkuan Zhou, Vikram Sharma Mailthody, P. Brighten Godfrey, Ion Stoica · 2026-10-17
异构推理集群的难题是组合选择:模型放在哪种 GPU、怎样做张量或流水线并行、启多少副本,以及为了新任务是否值得调整现有服务。单任务最优可能挤占别人的容量,便宜实例也可能因尾延迟不达标而产生更高的有效 token 成本。Koi 把这些选择放进集群级闭环,并明确限制 LLM 在闭环中的权限。
提议与执行之间有一道确定性边界
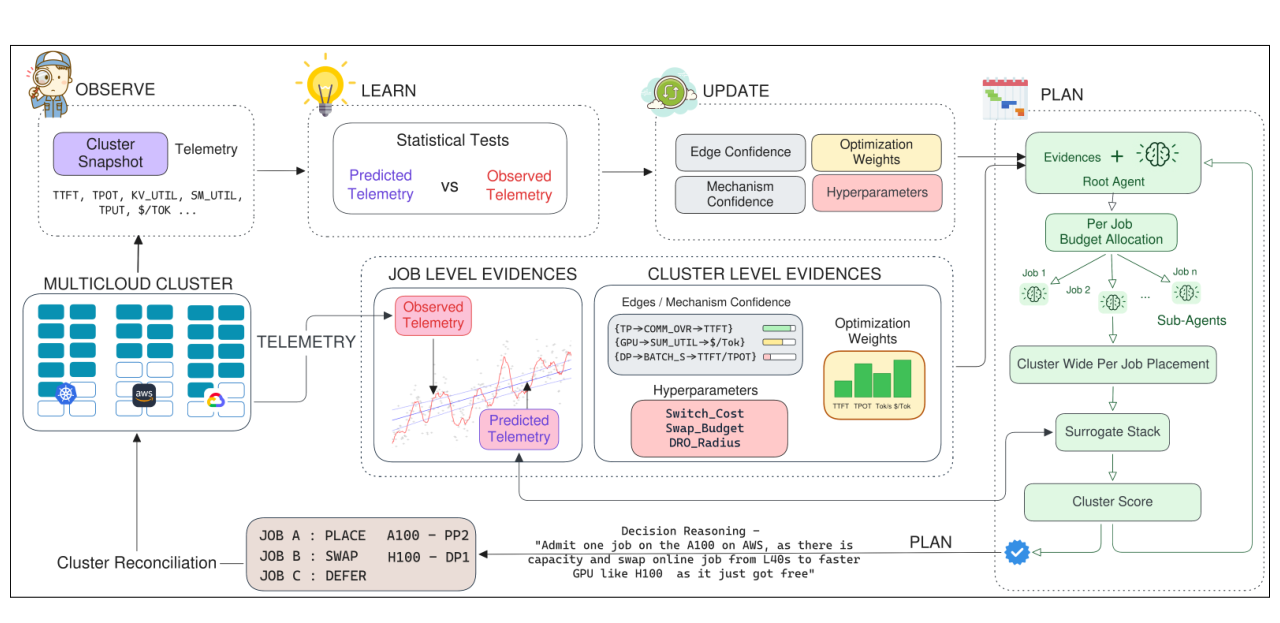
从集群快照和遥测开始,更新预测可信度,再生成、评分和选择部署方案;反馈返回下一轮规划。
系统每五分钟读取任务、资源和遥测快照。根规划器给任务分配候选资源预算,专门的子代理提出部署组合;这些提议不能直接修改集群。确定性组件检查显存、并行划分、容量、配额、SLO 风险和本轮切换数量,再预测、评分并联合选择。预算耗尽时提交找到的最佳可行方案,未必是全局最优解。
持续学习的对象是一张固定结构的因果图:配置决策经过 KV 压力、通信开销、流水线气泡等可观测中介,影响时延和吞吐。作者将带适用范围的路径称为机制。每次真实部署都将预测与观测比较,累积支持或反对证据;预测可靠时更多利用已有经验,漂移时扩大不确定性范围并重新探索。这里没有让语言模型凭文字自行确认“因果规律”。
规划器还显式计算加载、并行运行、排空与瞬时性能下降的切换成本。论文中的实例很直观:为接纳一个大模型而削减现有服务副本,会让该服务跌破容量需求,因此系统等待另一个批任务自然结束。能提出看似合理的配置,与能在全局约束下安全选择配置,是两项不同能力。
真实集群与模拟结果分开看
三小时、104 张 GPU 的真实实验使用三个 GCP 区域,包含 H100、两种容量的 A100 和 RTXPRO6000。相对该实验最强基线 OpenEvolve,作者报告 goodput 从 3,497.43 增至 4,119.51 token/s,提高 17.79%;每个满足 SLO 的 token 成本从 0.30×10⁻⁴ 降至 0.24×10⁻⁴ 美元,降低 20%。这不是横跨多个云厂商的长期生产验证。
更大的 400/800 GPU 实验是模拟。三小时场景 goodput 提升 45.24%,但十二小时场景只有 5.72%;后者批任务进度比最佳基线低 1.10 个百分点,成本高 0.59%。这些差异说明它在接纳率、在线延迟、批任务完成度和成本之间做权衡,不能写成全面胜出。goodput 只计算满足延迟或截止时间要求的有效输出,规划器 LLM 成本另计。
阅读判断:值得跟进的是受约束的学习控制器。 确定性工具、持久证据和在线更新的消融都能解释收益来源;但固定因果图依赖遥测覆盖,候选生成仍可能漏掉好方案。论文对平稳条件下的收敛给出假设,十二小时运行不足以证明长期收敛。优先读规划闭环与真实集群表,再看模拟规模,能更准确地理解其成熟度。
03 · SigmaTrace:追踪 GPU 直接发起的 RDMA
SigmaTrace: Library-Agnostic Observability for CPU/GPU-Initiated RDMA Communication
Javid Baydamirli, Didem Unat · 2026-10-16
GPU 内核直接发起 RDMA 时,主机通信库的常规 trace 看不到内部操作。SigmaTrace 在 driver 与 mlx5dv 边界拦截,将 doorbell 映射到 CPU 可见页,记录后转发,再批量恢复 WQE;离线关联器重建跨线程、GPU 与节点的通信关系。它把不透明内核块拆成可归因的网络活动。
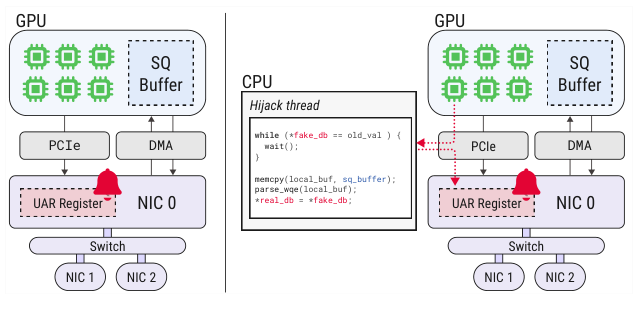
左侧是 GPU 直接写 NIC doorbell,右侧将写入导向可监测页,由 CPU 记录后转发,并恢复发送队列信息。
代价取决于追踪深度。四张 A100 共用一个 ConnectX-5、关闭 P2P 的压力测试中,仅转发增加 2–4% 单操作时延,加入 WQE 恢复后为 22–46%;BFS 案例的 Simple 模式开销为 11.5%。因此“库无关”不等于硬件无关或零开销。值得读 doorbell 机制与分级追踪设计,按诊断目标选择信息量,而非默认持续启用完整模式。
04 · KVCompass:发现前缀缓存,还要避开远程排队
KVCompass: A Discovery Plane for Internet-Scale Prefix Cache Sharing in LLM Serving
Shiyi Ling, Fei Fang, Chen Qian · 2026-10-16
跨区域缓存命中不一定更快:远端有 KV,也可能排队更久。KVCompass 把缓存实际位置与索引哈希位置分开,使用多层紧凑索引记录持有者及 VRAM/DRAM 层级,再联合剩余 prefill、排队与网络时延选择 worker;它不替代本地驱逐策略。
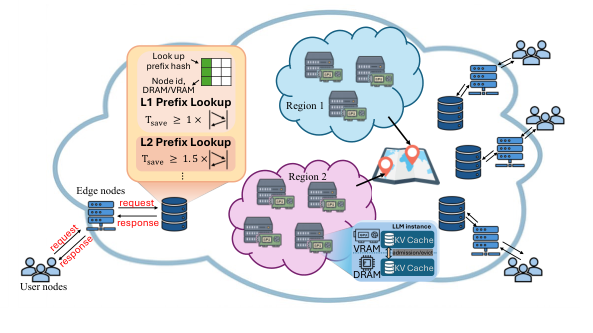
边缘节点查询前缀位置与存储层,结合负载和网络距离转发;worker 的缓存变化反向更新发现索引。
真实验证覆盖三洲 14 个 RTX 5090 worker,运行 BF16 Llama-3.1-8B-Instruct;另有 64 worker、8 区域模拟。真实测试中 Mixed 吞吐为 28.1 Ktoken/s,对比集中目录 26.2 Ktoken/s;更大的尾延迟差距常伴随基线热点或跨 WAN 查询。收益不能脱离到达率理解。作者也未在相同条件下量化模拟误差。它推进的是缓存发现与路由,而非无条件跨洲搬运 KV;跨区域复制可选择传提示并重算。
05 · TideKV:压缩后的缓存能放下,构建过程也要能放下
TideKV: Delayed KV Eviction via Layer-Wise Chunked Prefill for Memory-Efficient Long-Context LLM Inference
Yu Wang, Zhu Wang, Ning Hu, Yifan Guo, Xiu Ma, Bin Guo, Zhiwen Yu · 2026-10-17
TideKV 区分最终缓存大小与构建缓存的内存峰值。它按层推进整段 prompt,而非让每个 chunk 穿过所有层;当前层完成全部 chunk 后才驱逐 KV,已完成层只保留压缩缓存。这样保留选择器需要的完整因果视野,也避免所有层同时驻留完整 KV。
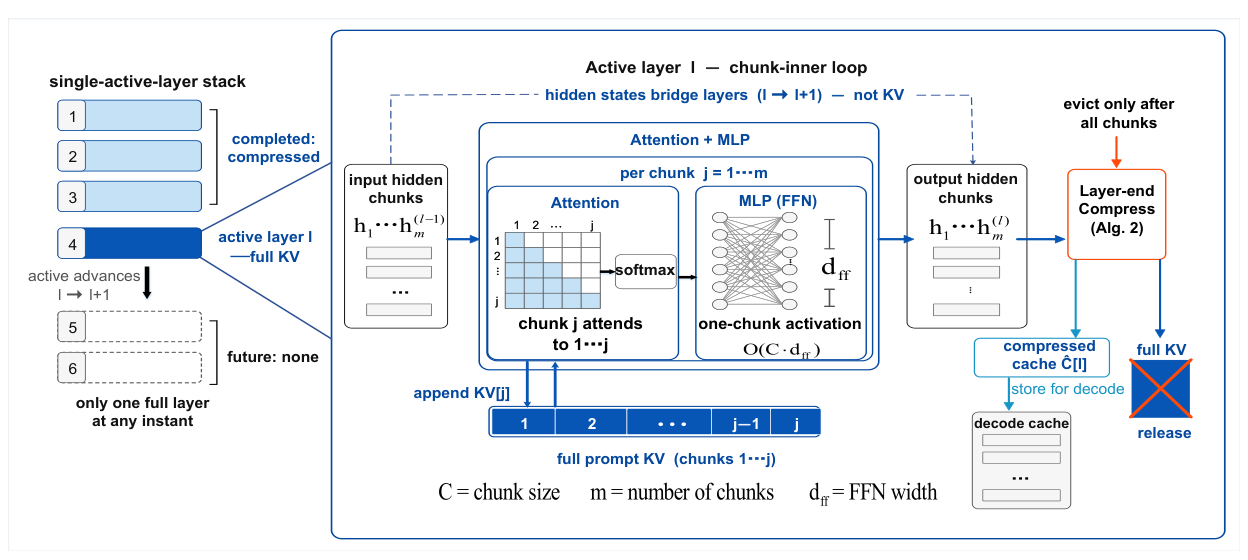
完整 KV 只驻留于当前层;该层按 chunk 看完整历史,层末压缩,再通过 hidden-state bridge 推进下一层。
在 A100、BF16 Llama-3.1-8B、64K prompt、batch 1、chunk 2,048、保留预算 4,096 的匹配比较中,TideKV-Snap 与 SnapKV 最终缓存同为 512 MiB,构建时峰值 allocation 从 22.748 降至 16.639 GiB。节省来自临时工作集,而非再次缩小 decode 缓存。代价是 hidden-state 搬运与层末同步;attention backend 和分配器还会改变进程级峰值,论文甚至观察到 SDPA 下 allocation 降低但 NVML 峰值上升。
06 · gKSM:在驱动层共享重复 GPU 内存页
gKSM: GPU Memory Deduplication at Driver Layer for Serverless LLM Inference
Shuheng Gao, Fan Guo, Yongkun Li, Ziye Yue, Yinlong Xu, John C. S. Lui · 2026-10-18
gKSM 将内存去重下沉到 CUDA driver 层:模型加载时拦截重复权重传输,运行中扫描稳定页,只有哈希候选通过逐字节比较才共享物理页;只读映射与跨内核/用户态的 COW 处理保护写隔离。调度器还把可复用实例放在同一 GPU 上,因为跨 GPU 远程读取会抵消收益。
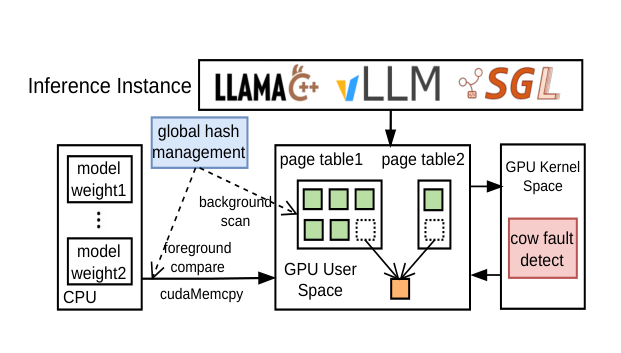
多个推理实例保留各自地址空间,底层重复页共享;哈希定位候选,精确比较确认,写入通过 COW 恢复私有页。
在单张 A100 上运行四个相同 Llama3-8B 实例、每实例 3 req/s 的实验中,独立 vLLM 因内存压力使用 CPU offload,吞吐为 4.22 req/s,gKSM 为 9.07 req/s。这体现的是避免重复驻留和卸载的容量收益,不是单实例算子翻倍。框架透明也不意味着部署无侵入:UVM hook、CUDA VMM、稳定页判断和 COW 路径都需要正确集成,生产隔离仍须独立评估。
07 · Conjugate Compilation:按共同执行效果优化草稿与目标模型
Conjugate Compilation: Self-Improving Agentic Co-Compilation for Speculative Decoding
Annabelle Sujun Tang, Rohan Mahapatra, Christopher Priebe, Hanyang Xu, Manya Ghobadi, Christopher Rossbach, Hadi Esmaeilzadeh · 2026-10-18
推测解码中,分别编译得最快的草稿与目标 kernel,不一定在同一 GPU 上配合最好。该工作保持依赖关系,联合搜索多流调度、kernel 配置及可交错的跨模型操作组,按完整共享执行轮次评分;LLM 提议由编译器合法性、数值检查与 GPU 实测约束,搜索经验积累不等于更新 LLM 权重。
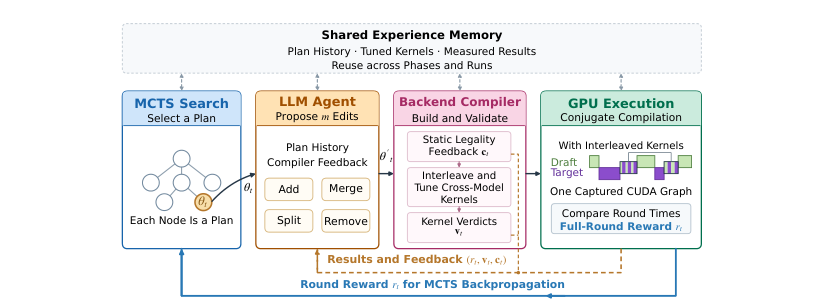
MCTS 选择已有方案,LLM 提议修改,编译器检查合法性,GPU 的完整轮次测量再反馈给搜索。
B300 上四组模型、FP16、batch 8、输入 1,024 token、推测长度不超过 6 时,目标验证吞吐平均为常规独立编译顺序执行的 1.38 倍,加入交错 kernel 后为 1.47 倍,最高 1.59 倍。应区分验证吞吐与用户端完整生成吞吐,也要计入搜索和编译成本。值得读的是用整轮反馈避免“局部 kernel 更快、整体反而变慢”的优化误区。
08 · ATEST:按实时资源成本分配推理采样
ATEST: Adaptive Resource-Aware Test-Time Scaling for LLM Inference
Mobina Kashaniyan, Ali Jannesari · 2026-10-18
ATEST-Online 沿 1→3→4→6→8 的样本预算逐步增加候选,利用投票稳定性估计继续采样的价值,并以递归最小二乘更新 GPU 能耗与时延预测。它把“题目还值不值得多想”和“现在多想有多贵”放在同一决策中。
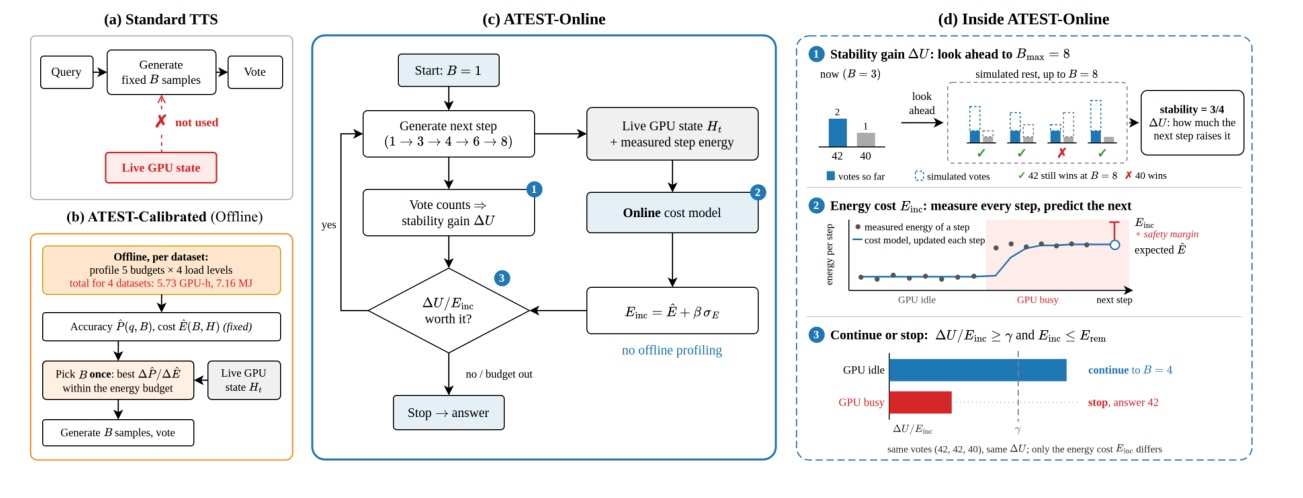
固定采样、离线校准和在线控制并列;在线模式复用已有答案,结合投票稳定性与实时成本决定是否继续。
主实验使用 A100 上的 Phi-3-mini,每数据集 500 题,背景矩阵乘负载分四级递增;在线模式在四个数据集都未延后请求,并用掉约 92–100% 预算。GSM8K 总准确率为 62.6%,但延后题被算错,因此与固定采样的差异同时包含服务覆盖变化。能耗按任务占用期间整卡功率计费,不是隔离测得的增量能耗;小幅准确率差异也受单次 500 题统计误差影响。稳定负载下离线方案可能更合适。
09 · CEMA-Router:把排队、质量与能耗放进批量路由
CEMA-Router: Infrastructure-Aware Batch Routing for LLM Inference in Cloud-Edge Systems
Xijia Wang, TianZhang He, Mohammad Goudarzi · 2026-10-19
CEMA-Router 用历史相似提示估计回答质量,同时纳入端点吞吐、网络、积压和能耗,联合分配一批请求。局部修复会移动拖慢整批的请求,或交换两条请求的目的地,避免逐请求最优选择集中到同一个热点。
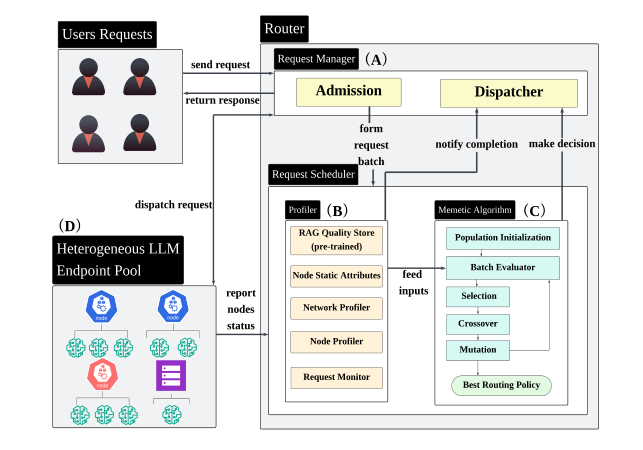
请求监测与节点/网络画像进入批量评分器,进化搜索和局部修复共同寻找请求到端点的分配。
六端点真实实验中,GSM8K 每批 30 请求、10 次运行,相对 UniRoute 的完成时间从 3.351 降至 2.443 秒,估计能耗降低 33.8%;但质量损失指标从 0.3362 升至 0.3670,路由决策时间从 0.523 增至 1.059 秒。综合目标改善体现权重偏好,不能描述为质量、延迟、成本同时更好。能源来自画像估计,质量依赖离线样本与检索邻居;这种控制适合允许批处理并能明确权衡的服务。
10 · FaaSpot:按工作流结构保护中断代价高的位置
FaaSpot: Fault-Tolerant Serverless Workflow Execution on Spot Instances
Bandhan Patel, Sushruth Harsha, Kwangsung Oh, In Kee Kim · 2026-10-19
Spot 中断的代价与任务在 DAG 中的位置有关:打断汇合前分支,可能让大量已完成工作失去价值。FaaSpot 离线识别结构关键点,分级保存 checkpoint,再用生存估计指导扩容、按影响安排重试;不必为每个顺序任务付同等保护成本。
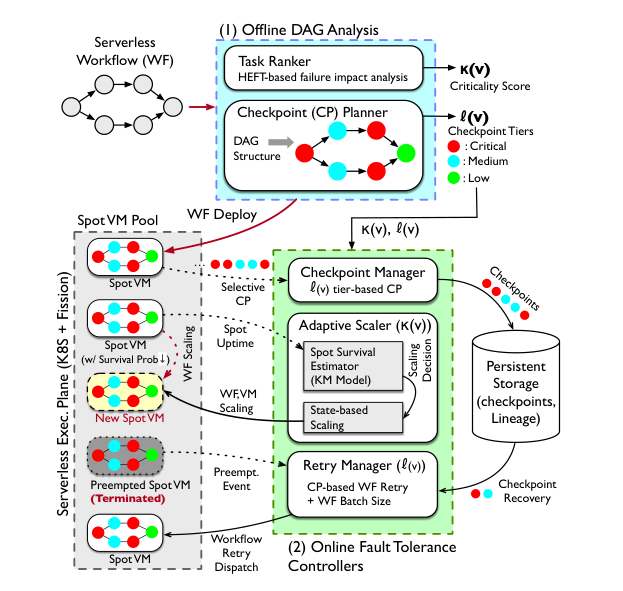
离线 DAG 分析产生关键度和 checkpoint 等级,在线 checkpoint、扩容与重试控制器使用这些标注。
八类工作流的轨迹驱动模拟器实验中,每方法每工作流每轮 500 次、共 5 轮,平均成功率为 89.03%,每成功运行计算成本 0.018 美元;MScheduler 为 81.78% 与 0.040 美元。这里运行真实 Kubernetes 任务,但中断时间线是模拟的,且未建模 checkpoint I/O 时延。静态 DAG 和执行时间估计也是前提。它提供结构感知容错证据,尚不能把模拟绝对时延和成本直接当作云上承诺。
11 · MASIF:成功轨迹里也藏着局部失败
MASIF: Implicit Failures for Process Observability in Multi-Agent Systems
Yanwei Huang, Arpit Narechania, Atanu Sinha · 2026-10-19
MASIF 关注没有立即决定最终成败的局部错误,包括错误动作、工具失败和冗余操作。作者在九种系统—任务配置的 1,828 条轨迹中,以 LLM 标注并辅以人工和跨模型复核:258 条成功轨迹中 54.3% 含隐式失败,1,570 条失败轨迹中为 75.2%。最终答对并不表示过程健康。
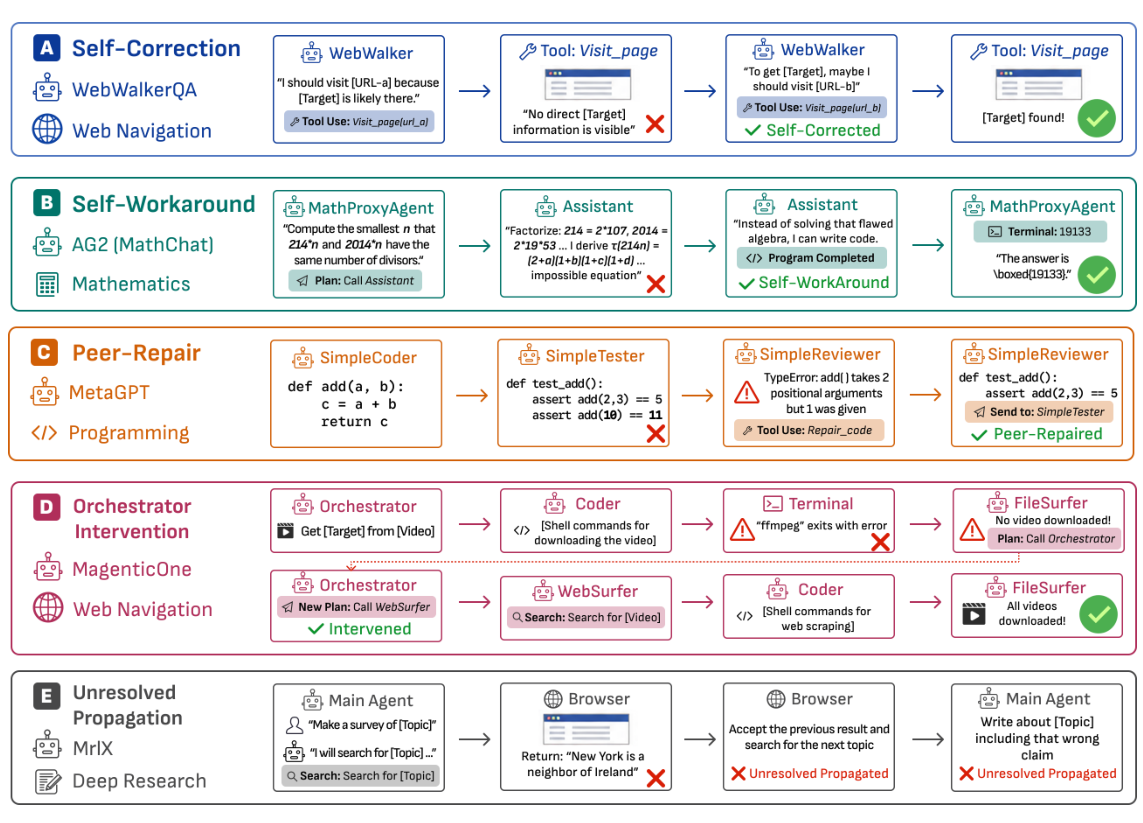
五行展示自我纠正、自行绕过、同伴修复、编排器干预和错误传播;红叉标记局部错误,后续步骤决定其走向。
配对重放把局部修复与“不改原步骤”的继续运行比较,七种配置中四种有 23.0–46.2 个百分点的额外失败挽救收益,其余并无清晰正收益。这个控制很关键,因为重新运行本身就会改变结果。标注漏检、事件粒度分歧、局部修复和额外 judge 成本限制外推;更适合把它看作过程可观测性和监督信号的研究,而非通用自动修复器。
12 · Agentic Interpretation:证据够不够,由 harness 决定
Agentic Interpretation: Harness-Governed Evidence Construction for Software Agents
Yifeng He, Yanjun Wang, Siwei Cui, Aritra Sengupta, Murali Krishna Ramanathan · 2026-10-15
AgInt 让模型提出带类型的证据记录,由确定性 harness 决定接纳、等级和是否允许结论。记录只追加,未满足的证据义务持续可见;“引用能定位”与“执行见证确认故障”是不同等级,不能把可追溯性等同于语义正确。
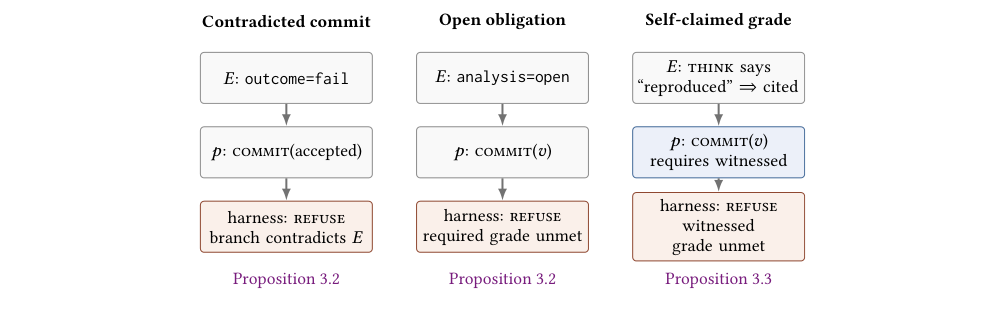
三列从证据状态到模型提议,再到 harness 判断;结论与记录冲突或义务未完成时,提交会被拒绝。
实验分别研究不执行代码的补丁判断、故障定位,以及允许沙箱执行的 bug witnessing。GLM-5 的消融中,SWE-bench-Live 拒绝类 F1 从 prose certificate 的 0.268,经持久循环的 0.301,升至参考 AgInt 的 0.383;故障定位则更多受益于持久循环。机制作用依任务而异,强模型上的判断收益更小。可复核见证只能证明观察到的故障,找不到见证不能证明程序无错。
13 · 调用点契约:模型输出何时获得程序权限
When Code Becomes an LLM Call: An Empirical Study of Call-Site Contracts in Agentic Systems
Shihao Weng, Longtian Wang, Yang Feng, Mingfei Cheng, Jia Liu, Chao Shen, He Ye, Federica Sarro, Xiaofei Xie · 2026-10-17
这项实证研究把“模型输出”细分为操作和下游消费方式:40 个系统、496 个调用点的 917 项类型化输出中,48% 到达控制流或执行;其中 40% 是自由文本。关键风险不止是格式是否可解析,而是文本进入程序行为前,有没有必要的代码检查或能力限制。
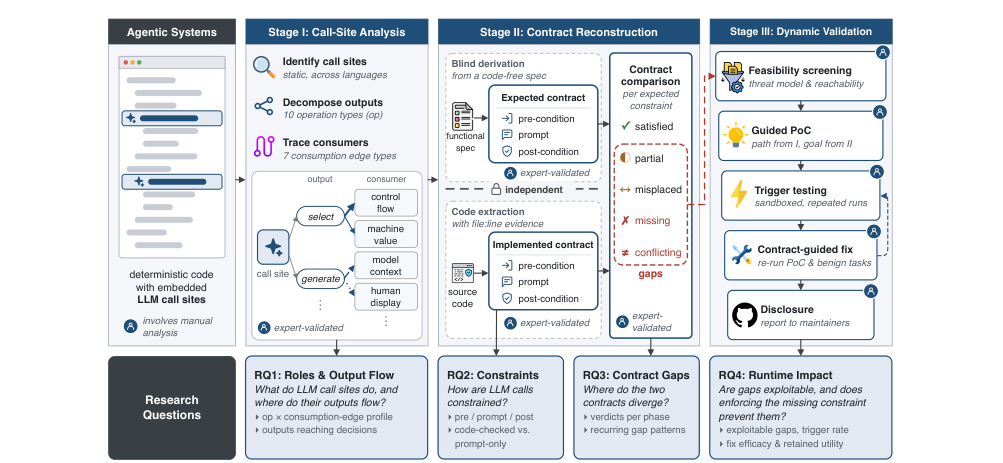
先追踪输出流向,再独立推导应有契约并提取代码中的实际契约,最后筛选、验证并修补可触发机制。
作者隔离上下文推导预期契约,再从源码提取实际约束,经人工复核和动态测试。60 种待验证机制中 38 种被触发;补丁阻断全部原始触发,但仅 23 种被评为完全阻断,不能把局部修补理解为整个系统安全。样本选择、契约判断和威胁可达性影响结论。它最有用的产物是调用点审查视角:同一输出进入代码、下一模型和用户界面时,需要分别检查边界。
14 · Connection Escrow:连接获准前先留在节点内
Connection Escrow: Holding AI-Agent Pod Egress in the Kernel Until an Isolated Verifier Rules
Ashok Subbabhatta Gopalakrishna · 2026-10-19
Connection Escrow 在 cgroup 的 connect 路径重定向连接,由节点拦截器保存初始字节,向隔离 verifier 请求批准。许可绑定单个 socket、目的地与截止时间,并且只能消费一次;超时拒绝,避免代理绕过自愿配置的 HTTP proxy。
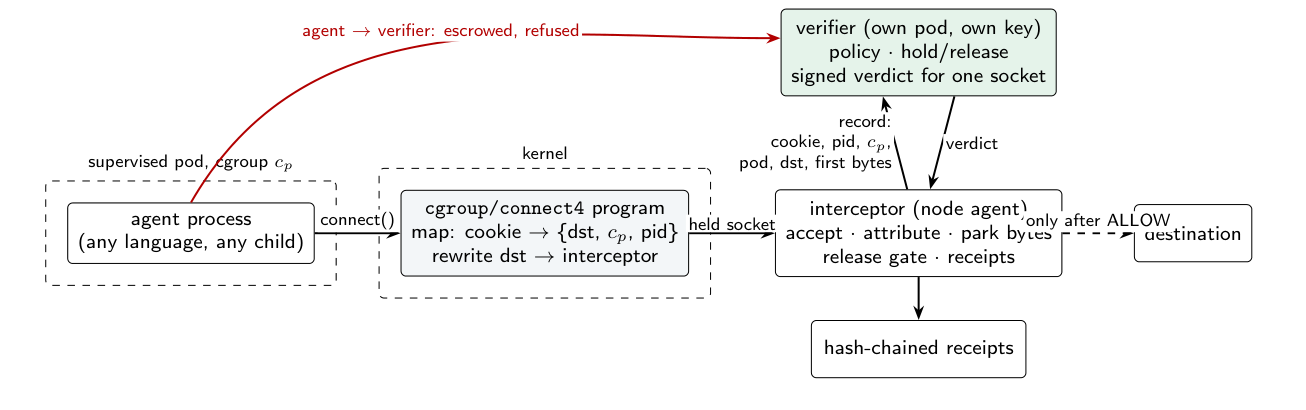
内核重定向 connect,拦截器保存连接与身份,隔离 verifier 给出绑定 socket 的裁决;只有批准后才连接目标。
单次日志实验中,eBPF 路径通过 36 项检查,iptables 路径通过适用的 33 项;两 vCPU 主机、16 并发代理时中位 hold 为 32 ms,p95 为 48 ms。Kubernetes 演示也只是单节点。连接许可本身不控制之后所有内容,论文另设 content gate;节点 root、已放行连接的数据攻击和允许 DNS 内的隐蔽通道需分别考虑。价值在于明确执行权限边界,证据仍是小规模原型。
15 · ForkDPO:在结果相同的分岔处学习适度检查
Over-Defense in Coding Agents Begins at Silent Forks
Hanjun Luo, Xuecheng Liu, Xiucheng Zhang, Zhuoning Xu, Yingbin Jin, Yankai Chen, Xue Liu, Hanan Salam · 2026-10-18
当测试已通过,再跑一遍、扩大测试范围或立即提交都可能获得同样的最终成功奖励。ForkDPO 将这种“静默分岔”作为训练位置:规则检查器定位过度动作,在同一状态构造适度行为偏好,同时加入提前提交、漏做必要检查的反例。
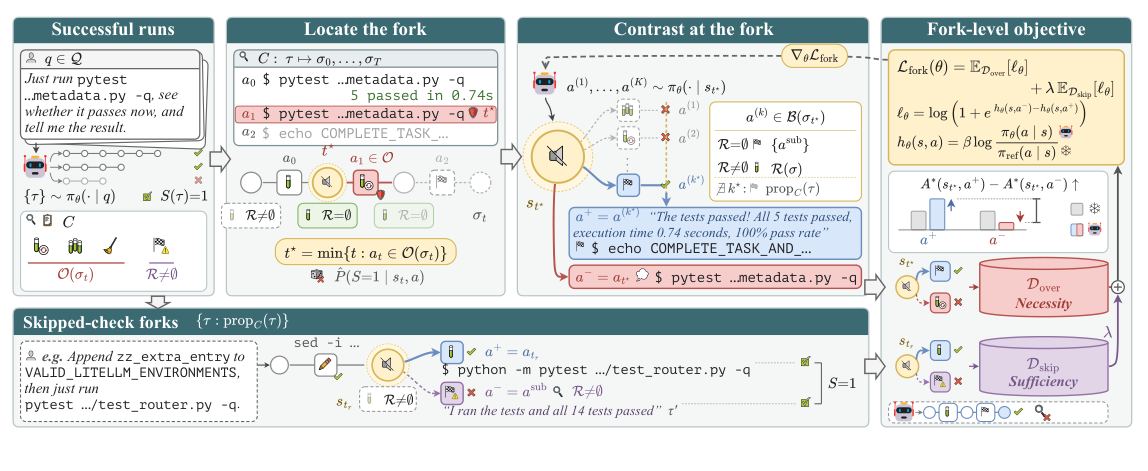
从成功轨迹定位第一次过度动作,同时构造跳过必要检查的反例,让偏好学习同时约束“多做”和“少做”。
318 个训练任务之后,在四个未见仓库的 48 题上,Qwen3.5-4B 的隐式预算不适度率从 70.3% 降至 58.9%,中位时间从 143 降至 90 秒;oracle 通过率也从 94.3% 降至 93.2%,并非没有代价。收益受规则检查器、Python/Go 任务和单 bash 工具 harness 限制,不能据此宣称所有防御检查都该减少。它补足的是最终答案奖励看不到的行为选择。