本期优先看两种“预算如何落到系统里”的进展:FLINT 同时限制查询与文档的向量数,把长查询的搜索成本压下来;Token-Energy Law 则把 decode 能耗拆成权重摊销、KV 历史和实际用时,解释为什么相同模型会有不同的每 token 成本。前者给出检索架构与效率实验,后者给出有明确计量边界的经验模型。
另一条线是有状态智能体:AKV 管缓存操作历史,ClawMMU 管记忆权限,HarnessAdapt-RL 把工具与模型一起训练。可靠性方向则从事故后的配置演化延伸到告警归因、异步异常检测和执行前许可失效。阅读时尤其值得区分:哪些已有系统测量,哪些依赖模拟或脚本案例,哪些仍是保护机制提案。
FLINT:给长查询的多向量匹配设定固定预算
FLINT: Fixed-budget Late Interaction
Himank Handa, Negar Arabzadeh, Matei Zaharia · arXiv · 首发 2026-10-19
长查询正在暴露多向量检索的一处成本缺口。ColBERT 保留逐 token 表示,细粒度匹配往往有效,却使索引和搜索随输入增长。最接近的 ConstBERT 已把文档压成固定数量向量,但查询仍逐 token 展开。FLINT 值得优先读,因为它把预算同时施加到两端,让复杂问题保留多个语义视角,又不必为每个查询 token 启动一组检索比较。
方法在共享编码器之后加入交叉注意力池化:一组可学习 latent 作为 Query,完整 token 序列作为 Key 和 Value,聚合后再经过前馈层与投影。查询与文档共享主干、池化和投影参数,仅 latent 集合各自学习。两端最终都输出固定的 V 个向量,再沿用 MaxSim:每个查询向量取最相似文档向量的分数,最后求和。这里压缩的是编码后的表示,没有把长问题截断成 V 个 token。
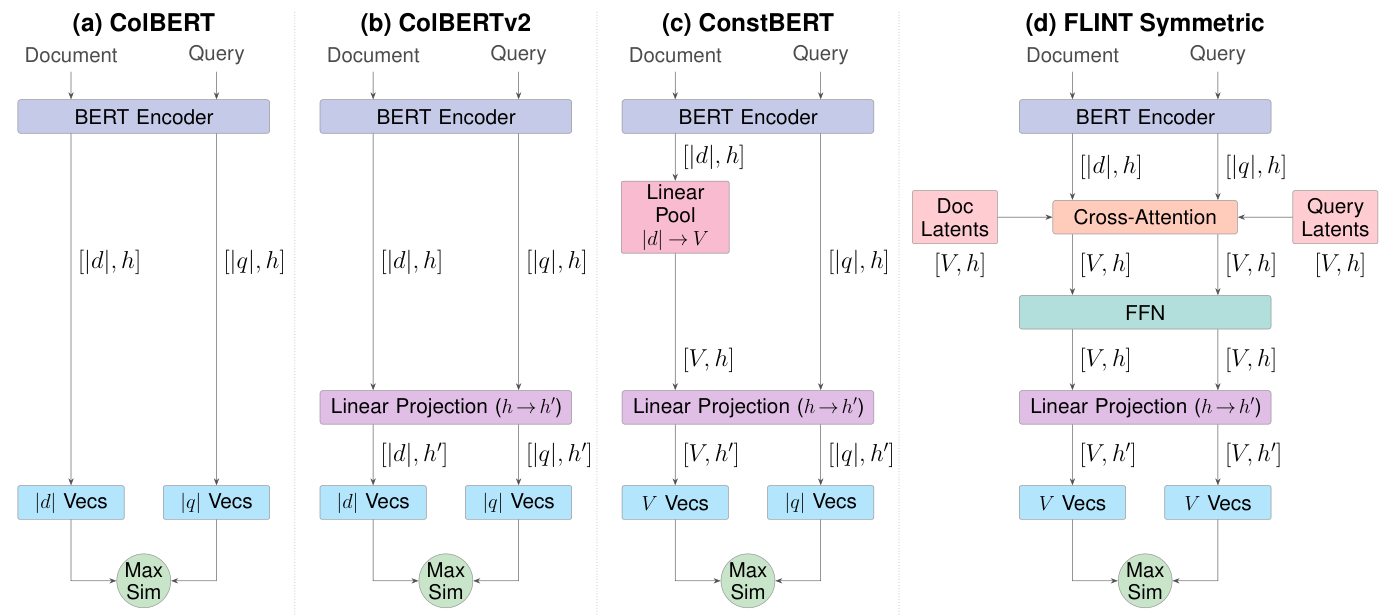
从左向右比较四种架构:FLINT 在查询和文档两侧都加入池化,最后仍用多向量 MaxSim 匹配。
预算影响两个层面。每篇文档固定存 V 个向量,控制索引体积;每个查询固定用 V 个向量探测 PLAID 的聚类单元,减少候选文档及其匹配工作。完整输入仍须经过 Transformer,所以“搜索成本近乎不随查询长度增长”不等于编码免费,也不等于整个请求耗时严格恒定。
作者在 MS MARCO 上训练,并在 BEIR、CRUMB、TREC Tip-of-the-Tongue 2025 和 BrowseComp+ 上测试。以 V=32、BERT 主干为例,TREC 长查询的平均响应时间从 ConstBERT 的 74.3 ms 降到 26.1 ms,其中搜索从 62.4 ms 降到 13.5 ms;编码仍约 12 ms。三个长查询语料上的端到端收益为 BERT 1.6–2.8 倍、ModernBERT 1.5–2.7 倍。索引相对逐 token 的 ColBERTv2 缩小 5.3–9.3 倍,但与同样保存 32 个文档向量的 ConstBERT 基本相当。
效果取舍不能省略。BERT 版本的 BEIR 平均 NDCG@10 为 0.452,低于 ConstBERT 的 0.469 和 ColBERTv2 的 0.502;换成 ModernBERT 后,V=32 达到 0.530,接近 ColBERTv2 的 0.534,并在 CRUMB 超过它,但后者在另两个复杂查询套件仍领先。固定预算提供了可调折中,并非所有任务无损:V 从 32 增至 64 能改善复杂查询,却明显增加搜索时间,BEIR 平均收益则很小。
对需要长描述、多约束检索的研究助手,这项工作的意义是把表示预算变成明确的系统接口。优先读对称池化及编码/搜索分解,再按自己的查询长度、召回要求选择 V;短查询、小语料未必有同样收益,单向量方法也仍有更低延迟。它尚不能直接证明下游问答正确率提升,但为保留细粒度检索与限制成本提供了可检验的设计。
效率实验统一使用单张 A100 80GB,所有多向量模型采用 PLAID 的 2-bit 残差压缩与相同检索参数;每条查询预热后计时三次取中位数,再汇总响应时间。这个控制使比较更接近架构差异,但仍不是与所有独立调优检索系统的竞赛。另一个阅读重点是训练分布:池化模块只见过 MS MARCO 的短查询,长查询成绩属于零样本迁移;预算扫描也只在 ModernBERT 上覆盖 16、32、64。查询和文档使用不同预算是否更好,论文尚未回答。
Token-Energy Law:把权重摊销、KV 历史和执行时间分开
The Token-Energy Law of LLM Decode: Active Bytes and Realized Time Account for Joules per Token
Chenxu Niu, Batuhan Sencer, Wei Zhang, Yong Chen · arXiv · 首发 2026-10-20
同一个模型,每 token 的能耗会随 batch、上下文和执行路径变化。只看参数量或平均功率,很难说明省下的焦耳来自哪里。这篇论文把 decode 的能量账拆成三个可观测坐标:每个输出分摊的权重字节、它需要读取和更新的 KV 字节,以及每个有效输出对应的实际执行时间。值得注意的是,这是经本地校准的加和模型,字节与时间是独立解释变量,而非相乘的能耗定律。
权重在一次迭代内由多个请求共享,因此有效 batch 越大,每个输出分摊越少;KV 历史属于各请求,长上下文不会因合批而同样摊薄。作者用逐迭代轨迹计算有效 batch 和按输出加权的历史长度,而不是直接代入服务配置里的最大并发或最大上下文。这样,请求提前完成、batch 成员改变时,计量仍对应实际产出的 token。
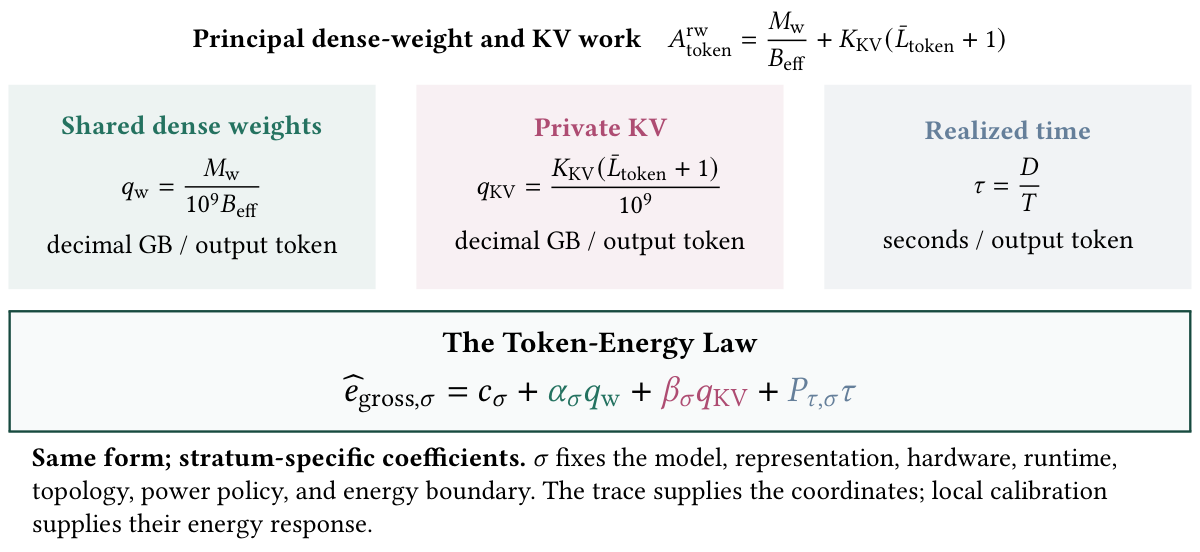
上方将工作拆为共享权重与私有 KV,中间加入每个输出的实际用时,底部用本地校准系数组合能耗。
核心关系可以写成:
这里 e 是每个有效输出 token 的 GPU 板级焦耳数,q_w 与 q_KV 分别是权重和 KV 的逻辑字节需求,D 是 decode 时长,T 是有效输出数。系数随模型、精度、硬件、运行时和计量边界校准;时间项也不是独立测得的空闲功率。缓存命中、内核行为和辅助计算都会影响这些有效响应系数,不能把逻辑字节直接当成真实 HBM 流量。
实验覆盖 Qwen2.5-7B、Qwen2.5-14B 和 Mistral-7B,采用 BF16 权重及 KV、全历史注意力,在 GH200 与 GB300 上运行,并包含 GH200 双 GPU 张量并行。作者关闭前缀缓存、推测解码、chunked prefill、offload 和抢占;每次正式能量测量累计至少 30 秒 decode,排除准备阶段。374 次留出能量执行中,各条件的均值估计误差最多为 3.73%;另有 177 次独立 HBM profiling 检查字节坐标与物理访问的联系。这不是“每次请求误差都低于 3.73%”。
最实用的发现是,时间信息不能被带宽直觉替代。运行时切换图执行或 eager 路径,会改变完成相同逻辑工作所需的时间;只以权重和上下文估能耗会漏掉这部分。反过来,论文使用的是已经观察到的 decode 时长,若要在部署前预测能耗,仍须有经过验证的性能模型提供 D。复用的是模型形式,而非一套跨所有 GPU 的通用系数。
边界同样具体:这里测 GPU 板级 decode,不包括主机 CPU、prefill 和数据中心开销;双卡实验也不能替代多节点验证。MoE 中专家共享程度由路由决定,不能简单把激活参数量除以 batch,套用稠密权重项。对推理服务研究,这项工作给出的进展是可解释的能耗归因坐标,以及冻结系数后的跨负载检验;优先读计量边界、动态请求记账和留出实验,才能判断是否适用于目标服务。
能量实验还把训练和留出条件按 batch—历史组合分开,而不是只对同一个配置重复计时。动态退出测试进一步保持已识别的模型系数,不因每种退出模式重新拟合。这种设计检验的是工作负载改变后解释关系能否延续。它仍不同于突发到达、混合 prefill 与 decode 的完整在线调度,因而适合先用作能耗分析基线,再验证更复杂的服务条件。
ClawMMU:记忆可以变换,权限不能自我升级
ClawMMU: Protection-Coherent Virtual Memory for Stateful LLM Agents
Jinhao Hu, Bardia Mohammadi, Mofasshara Binte Rafique, Lars Henning Klein, Akhil Arora, Ashvin Goel, Laurent Bindschaedler · arXiv · 首发 2026-10-20
外部文本被摘要、存储再召回后,容易看起来像智能体自己的可靠记忆。ClawMMU 给每份表示附加 owner、scope、origins 和 authority,在进入上下文、派生存储、重新加载与工具授权四个边界检查。摘要继承最低输入权限,模型生成内容默认仍是 Evidence;只有所有者授权才能提升权限。撤销计数保存在检查点之外,防止恢复旧状态使已撤销来源重新有效。
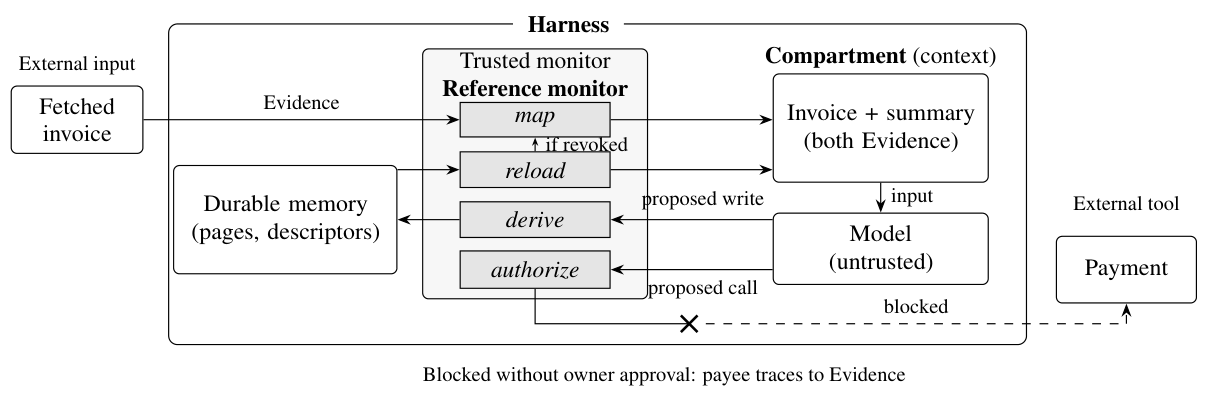
四个检查点围住上下文边界;即使模型提出付款,来自低权限发票的收款人仍需所有者批准。
关键边界是参数完整性:付款收款人等值必须能追溯到有足够权限的来源。它不保证模型选择正确行动,也不保证有权读取的内容不会泄露。这是一篇机制与愿景论文,AgentDojo 等攻击测试、检查延迟和审批频率仍是未来工作。价值在于把记忆污染转为 harness 可检查的保护问题,而非提供已经测得的防御成功率。
AKV:删去注意力状态,也要记住操作历史
Cache Engineering for Agents
Tianyu Fu, Ruoxi Wang, Zihan Min, Zhongqi Ren, Zhihao Li, Tengxuan Liu, Shengxu Mu, Hanling Zhang, Yu Wang · arXiv · 首发 2026-10-20
AKV 把上下文管理从改写文本推进到直接操作 KV:drop 让选定状态不再参与后续注意力,repos 用 RoPE 旋转调整保留 Key 的位置,避免重算完整前缀。难点在于先删 A 再生成 C,与先生成 C 再删 A,会留下不同的 C;仅靠 token 前缀不能判定缓存相同。扩展 radix tree 因此记录操作历史,缺失状态用分段批量注意力恢复。
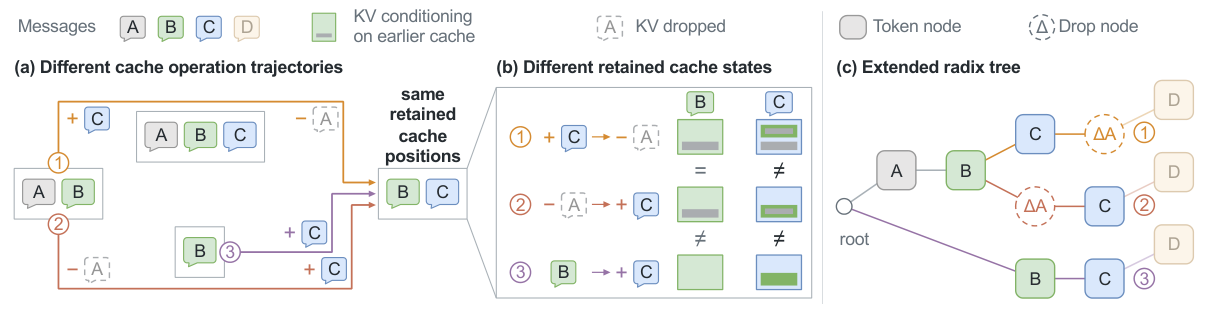
三条轨迹最后都保留 B、C,却因删 A 的时机不同而产生不同状态;右侧树把这些历史分开。
三个模型、四个 Agent 基准上,保留最近 12 次工具响应的策略相对高阈值摘要平均提高约 1.7 个百分点、降低估算成本 27.7%。8 张 A800、prefill/decode 各 4 张的 GPT-OSS-120B 服务测试中,比较各自峰值吞吐并发,P95 请求延迟加速 1.51 倍。成本按 token 价表估算;保留状态含已删历史的影响,不能把 drop 当成信息遗忘或隐私删除。
事故后演化:配置改进需要持续协作
Characterizing Post-Incident Software Evolution
Matt Pope, Jonathan Sillito · arXiv · 首发 2026-10-19
复盘提出行动项,不等于系统已经完成改进。研究沿 Wikimedia 2015–2025 年公开事故报告,关联任务、代码评审和提交,并与同期抽样的一般变更比较。完整研究数据共含 1,302 个任务和 2,203 个评审,包含事故后与比较组,不能全部称为事故修复。
结果显示,事故后变更针对服务器配置的可能性是一般变更的 4.6 倍;已解决任务的活动次数中位数为 19 对 11,说明工作不仅涉及代码,还涉及讨论、证据核对和协调。作者也发现仓库分布解释了部分差异。它为 SRE 的改进闭环补上了“行动项后来发生什么”的实证视角,但单一组织、公开链接和活动量代理不能证明投入带来多少故障减少。原文没有方法架构图,阅读重点宜放在数据关联流程与仓库分层比较。
S4-RCA:解释告警变化,区分机制与外生扰动
What Moved the Alarm Score? Causal Attribution with Exact Computation and Scarce-Incident Estimation
Masaaki Takada, Ryusei Shingaki · arXiv · 首发 2026-10-20
告警分数升高,最大的指标偏移未必是最该修复的原因。S4-RCA 把结构函数变化与外生分布变化拆成独立 Shapley 玩家,在参考和事故 SCM 之间构造混合系统,归因它们传播到分数的贡献。对已知因果顺序的线性 SCM 与二次评分,一、二阶矩递推配合求积可精确计算完整归因,避免枚举全部联盟;事故样本少时,以参考模型为锚估计变化量。
在 30 组、每组 100 变量的合成 SCM 中,最大事故样本量下,函数变化 Recall@5 为 0.687,对比仅看参数变化的 0.460。计算还扩展至 1,000 个函数/分布组件,约 11 分钟。这里“精确”指给定模型的计算,不代表估计出的因果模型正确;隐藏混杂、错误顺序或非线性会改变适用性。原文以公式和实验图为主,最值得读的是归因目标与识别假设。
BEACON:让日志、指标与延迟传播一起参与检测
BEACON: Bridging Multimodal Semantics and Asynchronous Propagation for Cloud System Anomaly Detection
Zhe Li, Tengxue Zhang, Yang Shu, Tung Kieu, Lunting Fan, Yingying Zhang, Bin Yang · arXiv · 首发 2026-10-20
BEACON 针对多模态信号的语义错位和故障传播时滞:信息瓶颈选择器结合指标名称与时间统计抑制冗余,语义原型将日志和指标映射到共享空间,再沿依赖图用多尺度时间衰减聚合邻居历史。LLM 用于训练阶段的原型初始化,并非每次检测都重新生成诊断。
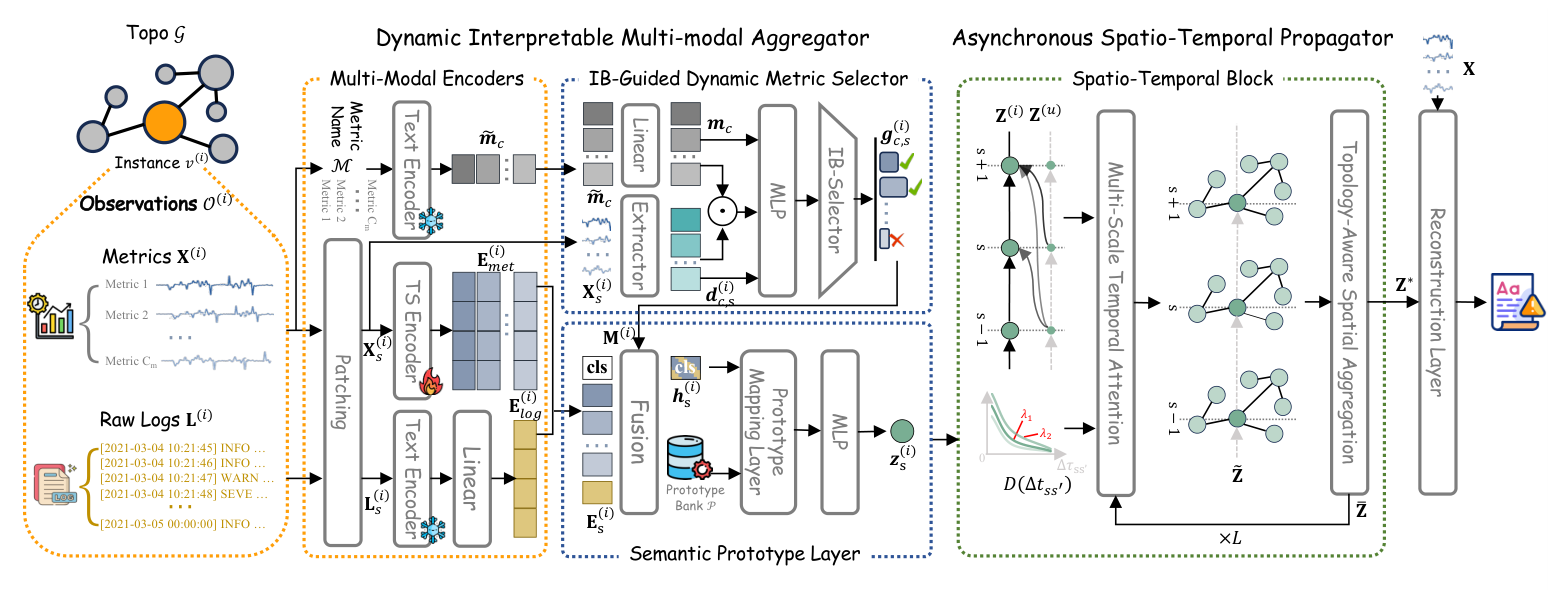
先筛选指标、融合日志语义,再在依赖图上聚合不同时滞的信号,最终用重构误差形成异常分数。
作者在 AIOps2021、Train-Ticket 和匿名生产数据 D1 上报告 F1 为 0.6688、0.6292、0.8723,相对各自最强基线约提高 5.9%、9.0%、7.9%,不是提高相同数量的百分点。D1 结合运行遥测与受控故障注入,三套数据分别含 18、94、14 个实例。结果支持融合与异步建模,但依赖拓扑、训练标签和验证集阈值;异常定位到实例也不等于识别真实根因。
推理配置实证:常用选项少,组合却很分散
How Developers Configure LLM Inference: A Large-Scale Study of Real-World Practices
Nada Zine, Matias Martinez, Romain Rouvoy, Clément Quinton · arXiv · 首发 2026-10-20
这项研究从 2026 年 9 月的 GitHub 快照中筛出 5,398 个使用 Transformers、vLLM 或 OpenAI API 的仓库,静态提取 345,117 次显式选项配置。流水线识别调用接口、选项和值,再以仓库为单位统计,避免把大量重复调用直接当作广泛采用。
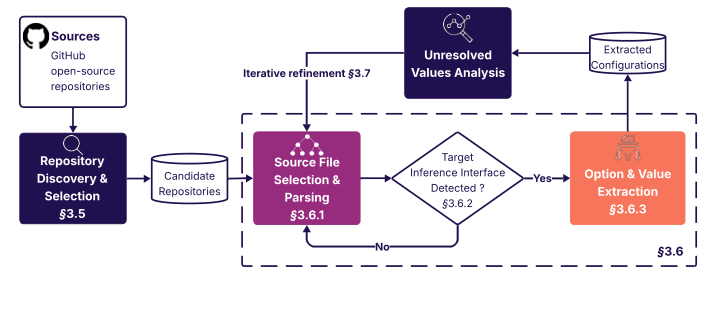
流水线从候选仓库识别真实推理接口,再提取配置;未解析的值反馈到分析改进环节。
331 个文档化选项中有 98.8% 至少出现一次,但 78.9% 只在对应后端至多 10% 的仓库中配置;仓库级配置大小中位数为 2、4、4,多选项组合有 56.8–61.6% 只出现于单个仓库。这说明工具支持需要同时照顾小型常见配置与分散长尾。样本限于活跃、至少 50 星的公开 Python 仓库,静态分析看不到所有动态值,也不衡量默认配置是否合理;流行频率不能当作最佳性能建议。
CPU 三值解码:NUMA 本地化之后仍要减少等待
Weight Placement Is Not Enough: Synchronization in Multi-Node CPU Decoding of Ternary LLMs
Runguo Li, Dezhen Lu · arXiv · 首发 2026-10-20 · 阅读 v2(2026-10-21)
这里的“多节点”是双路服务器内的 NUMA 节点。作者复用 ik llama.cpp 内核和权重,在 Ice Lake、Emerald Rapids 上比较按行分配与 Megatron 式列划分。权重已经本地化后,线程仍有每 token 20–48% 的时间等待同步,其中多数在等迟到线程,并非 barrier 指令本身。
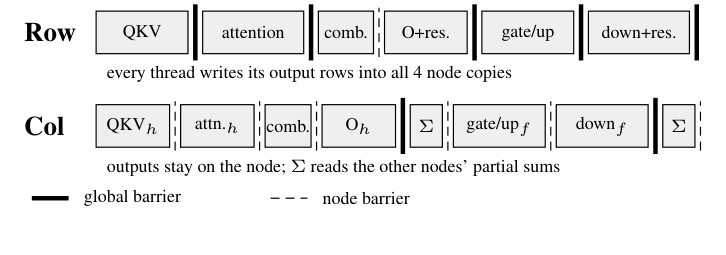
实线是全局 barrier、虚线是节点内 barrier;列划分保留局部输出,再读取其他节点的部分和。
列划分让注意力头、KV 与部分输出留在本地,即使需要跨节点归约,在全部 24 个比较配置中仍优于无归约的按行方案。DRAM 受限时,相对 ik 的最优线程数配置达到 1.5–1.9 倍加速。研究没有定位所有线程迟到的根因,且部分机器有共享负载干扰;准确性也不是逐 token 恒等。价值在于用等待分解解释为何“减少通信次数”并不足以预测低比特推理速度。
KPage:不改变稀疏图,压紧物理计算块
KPage: Cross-Block Page Compaction for Hardware-Efficient Sparse Attention
Junwei Feng, Qiaorui Chen, Chenyu Liang, Zhen Guo, Jingyi Yang, Xiaoling Zhou, Jiahao Zhang, Dongliang Huang, Yiqiao Liao, Chengru Song · arXiv · 首发 2026-10-20
稀疏注意力选中了逻辑块,也可能因块内填充而浪费 Tensor Core 工作。KPage 将选中的 128 行 K/V 块拆成 16 行页,跨逻辑块填满物理 tile;加载时直接拼到共享内存,不先在 HBM 生成压紧副本。查询端按有效行数选择两种 tile,反向则围绕 K/V 所有者组织,并保留原始页对邻接关系。
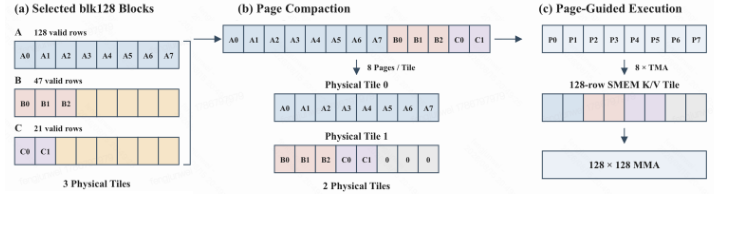
把不满的逻辑块拆为小页后,多个块可以共用一个物理 tile;有效稀疏连接保持不变。
五个代表性工作负载中,单 GPU、BF16、头维 128 的裸前向内核相对 NVIDIA BSA 几何平均加速 1.77 倍;无填充对照仅约 1.03 倍,说明收益主要来自碎片。页面表、稀疏图和反向布局构造通常未计入计时,不能直接换算为模型端到端加速。它保持所给稀疏模式的语义,但不负责证明该模式相对稠密注意力的模型质量。
3D-MoE:用专家负载互补缓解近存热点
3D-MoE: Complementarity-Guided Hardware-Software Co-Design for MoE Decode on 3D-Stacked NMP
Yudong Pan, Lian Liu, Shixin Zhao, Yintao He, Kaiyan Chang, Tianhua Han, Chenyang Ai, Haonan Zhu, Mengdi Wang, Yinhe Han, Ying Wang · arXiv · 首发 2026-10-19
把热门专家搬近内存仍不足以消除负载倾斜。3D-MoE 利用不同专家随请求领域变化出现的负载互补,离线分组并就近映射;组内临时热点则由 CMN 广播路径把权重 tile 从宿主通道一次送给多个协作核,长期漂移再触发考虑成本的重映射。
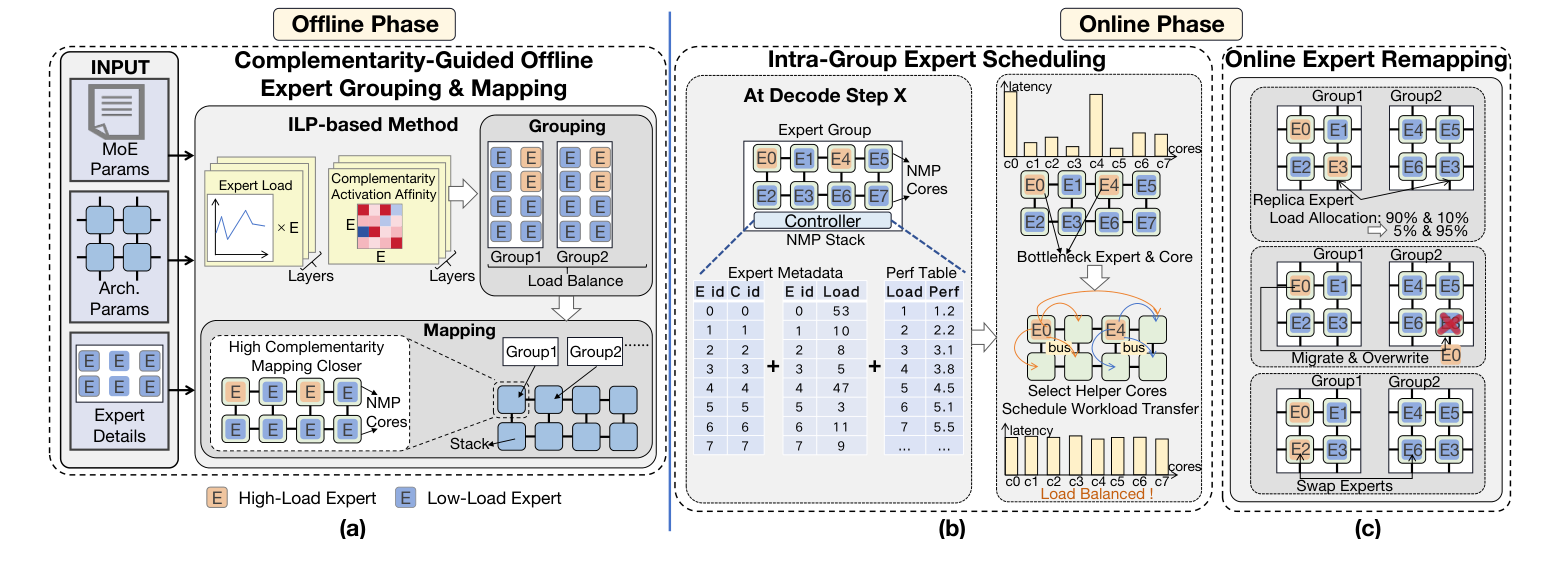
左侧离线确定互补分组与位置,中间调度组内协作核,右侧处理负载漂移后的重映射。
在 DeepSeek-V2-Lite、Qwen3-30B-A3B、GLM-4.5-Air 上,Ramulator 2.0 与 BookSim 周期级模拟结合 GPU 实测稠密算子延迟,得到相对 EP 平均 4.63 倍 MoE 层加速、相对最强 NMP 基线 1.58–1.86 倍端到端吞吐;额外逻辑芯片面积估算为 2.11%。这是一项软硬件协同设计,收益依赖专用互连、专家互补稳定性和一次性离线优化,不能作为现成 GPU 部署的加速承诺。
尤其应区分专家层速度与完整请求吞吐,后者还受非专家算子影响。
运行时控制:批准也需要失效机制
Runtime Control for AI Agents: Closing the Evaluation–Execution Gap in Operational Workflows
Jayesh Bhadane, Ramachandra Yerramsetti, Rajesh Gupta, Sumit Kumar · arXiv · 首发 2026-10-20
批准与执行之间,金额、证据或授权范围可能已经改变。论文提出把 allowance 绑定到决策读取的事实及规则版本,用追加事件日志重建状态;相关变化使旧许可永久失效,实际工具调用前再检查,并将最终检查与事件写入串行化。
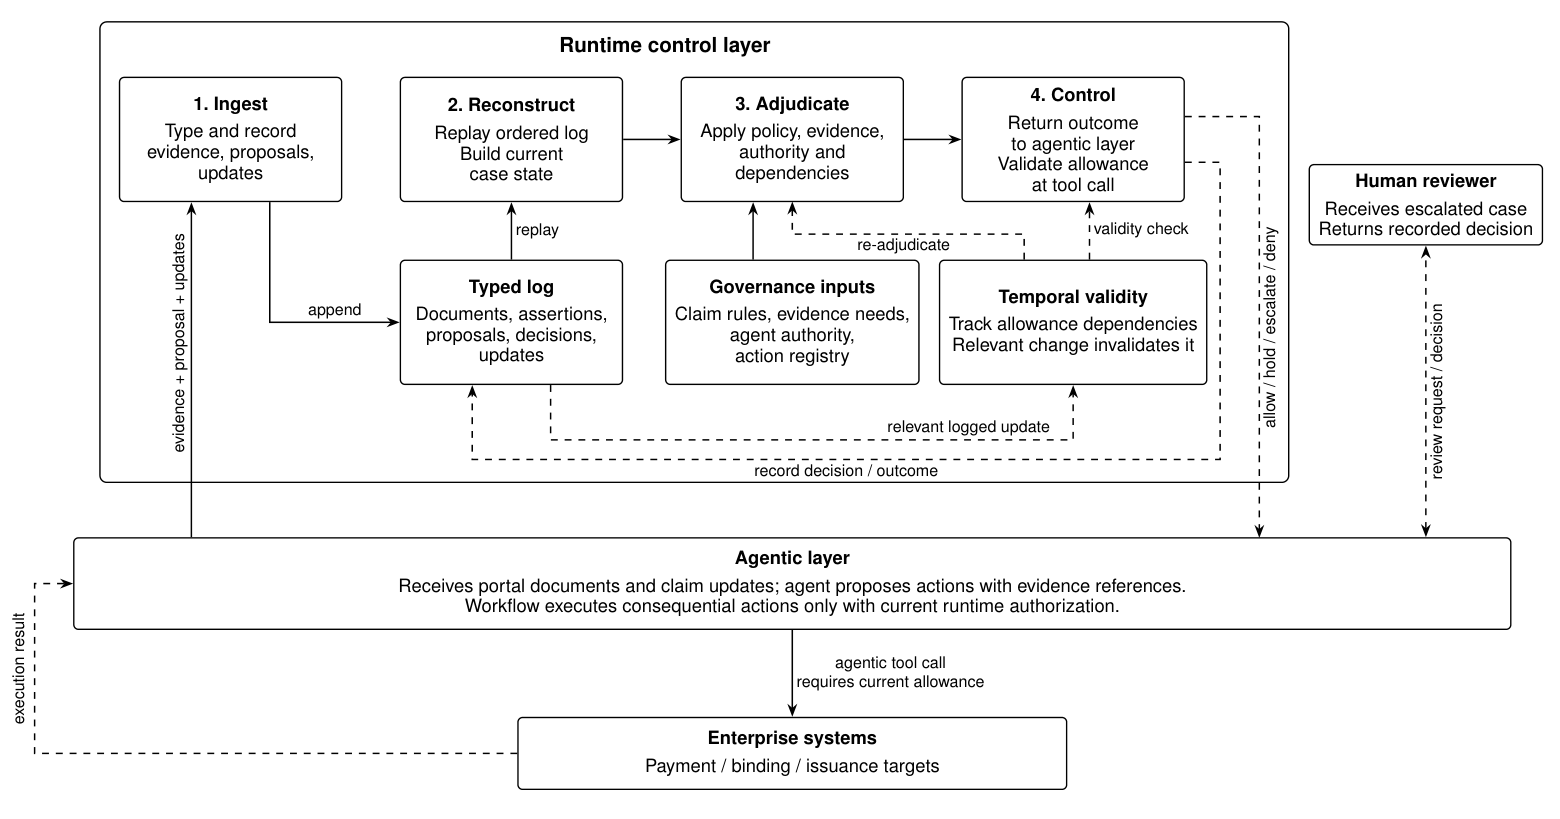
控制层重建当前状态并返回许可,真正的工具调用仍由智能体工作流发起,且必须再次核验许可有效。
42 个作者编写的确定性回放案例中,系统识别出 15 个后来失效的批准,执行前暂缓 14 个行动,并对一个已经发生的效果补偿。对照被刻意设为不再检查的时点评估;人工升级从 43 个提议中的 5 次增至 14 次。结果展示了时效性机制和代价,并非生产可靠性证明,也未击败所有执行时策略引擎。保证依赖完整拦截、及时事件摄取与完整依赖记录,不能自动保证外部效果恰好发生一次。
TraceLite:旧观察变图片,近期证据保留文本
TraceLite: Efficient Trace Reduction for SWE Agents via Optical Compression and Redundancy Removal
Jingyu Xiao, Qianxi Liu, Yintong Huo, Yuan Jiang, Michael R. Lyu · arXiv · 首发 2026-10-20
TraceLite 在 mini-SWE-agent 中保留最近三条观察的文本,将更旧观察按 4 倍目标压缩率渲染为图片,再删除跨步重复内容,并在代码编辑后清理此前观察载荷。它不训练压缩器,也不额外调用摘要模型,但依赖多模态模型识别历史图片。
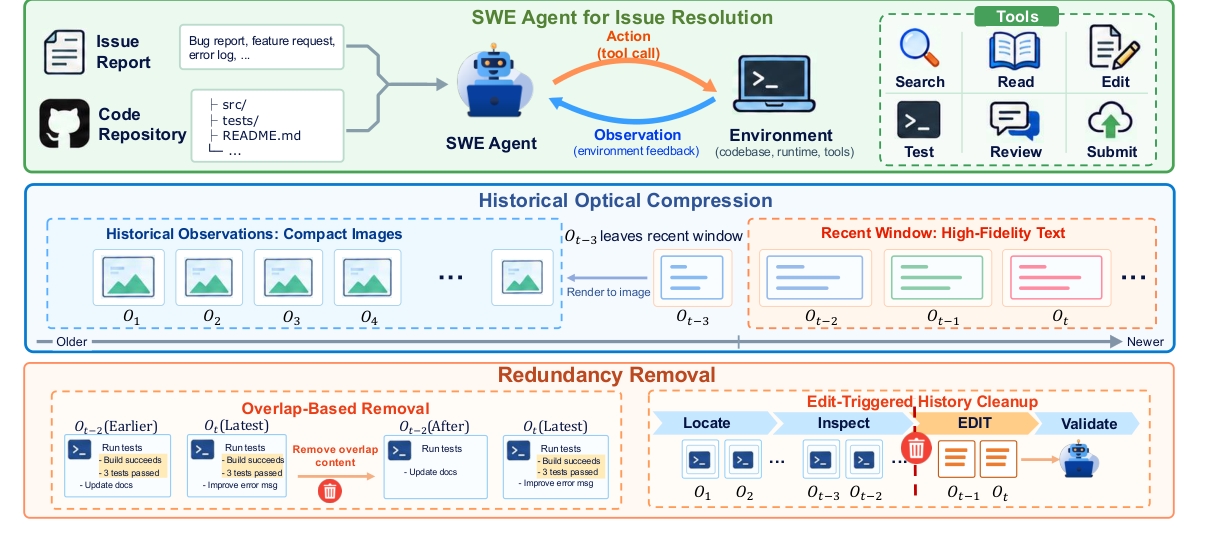
近期观察留在文本窗口,历史观察转为图片;底部两条路径分别清理重复内容与编辑前的旧载荷。
主实验把 SWE-bench Verified 的 500 题分为 100 题调参、400 题测试。GPT-5.6-Luna、high、温度 0、最多 250 步下,解决 313/400 题(78.25%),与全文基线 78.00% 无显著差异;平均输入 token 减少 33.05%、API 成本减少 21.30%,每条观察压缩耗时 0.438 秒。意义在于保持任务表现时减少输入成本,不能把 0.25 个百分点写成能力提升。路径、符号和错误文本在图像压缩下可能损失细节,编辑后清理也有重新取证成本。
HarnessAdapt-RL:训练产物是模型与工具的组合
Training the Whole Agent, Not Just the Model
Lingxiao Tang, Wei Tao, Yiwen Guo, Lingfeng Bao · arXiv · 首发 2026-10-20
HarnessAdapt-RL 同时改变策略与运行环境:一位冻结教师根据任务轨迹提供机制级修复提示,另一位教师针对跨任务交互问题修改工具和 hooks。候选 harness 只有在观察到的通过率或可训练 rollout 比例提高、另一项不下降时才接受,再用新轨迹做 GRPO。验收依据是有限样本比例,并非统计显著性检验。
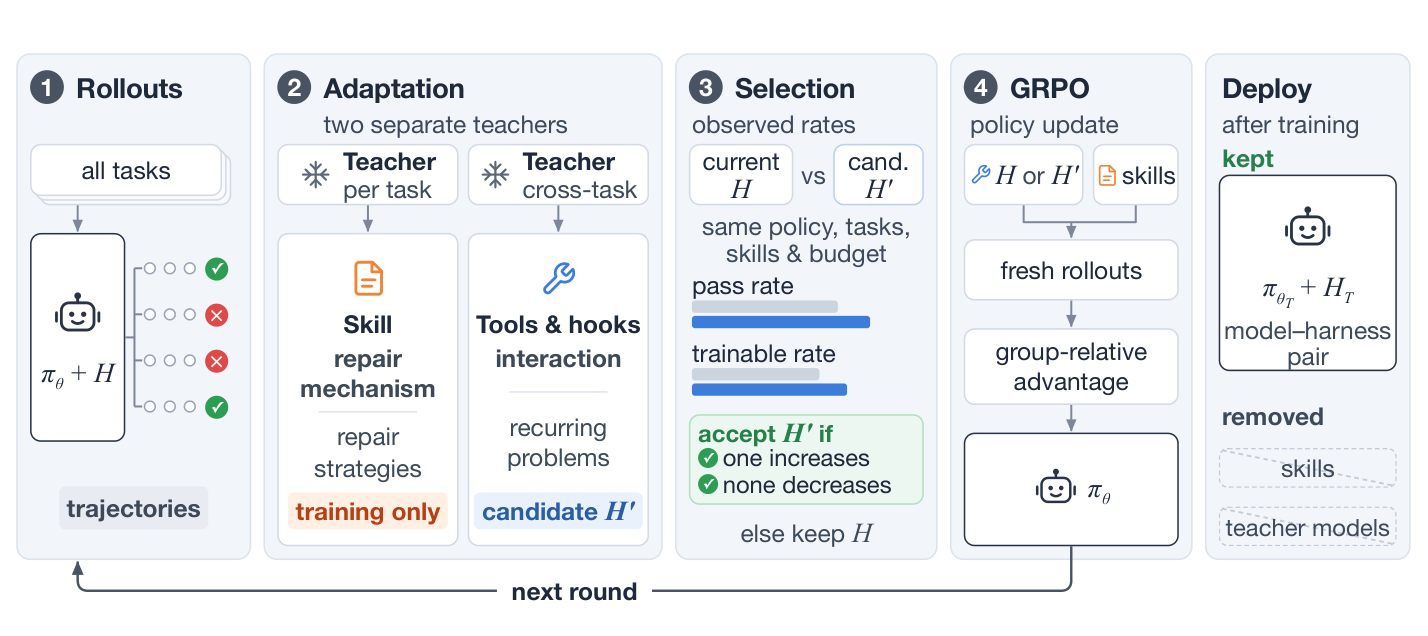
先采轨迹,再分别生成技能和工具改动;筛选后更新策略,部署保留工具与模型,移除训练提示和教师。
Qwen3.5-9B 上,部署时去除技能和教师、保留最终工具,Verified/Multilingual/Pro 的 pass@1 为 57.6/37.3/39.7%,较 GRPO 提高 9.8/12.6/6.4 个百分点。若部署退回初始 harness,性能最多下降 7.7 个百分点。更有启发的是,复用已发现的最终 harness 重新训练能接近完整方法:发现过程重要,但未必每轮新训练都需重复。收益和教师、比较 rollout 的额外成本应一起看。
D-PAL:用分布重叠训练草稿模型
Beyond the Point Mass: Acceptance-Derived Weights and Distributional Losses for Speculative Decoding
Tianyu Wu, Zhuohan Wang, Jonathan Geuter, Yu Yao, Weifan Jiang, Chengxi Zhang, Ju Li, Minlan Yu · arXiv · 首发 2026-10-20
D-PAL 把推测解码草稿的训练信号从“记录 token 的概率”推进到目标与草稿的分布重叠,即 1−TV。接受前缀的期望长度导出位置权重,局部损失可用 KL 或 Rényi-1/2;平滑分布损失避免仅拟合一个样本标签,也与接受率上下界相连。
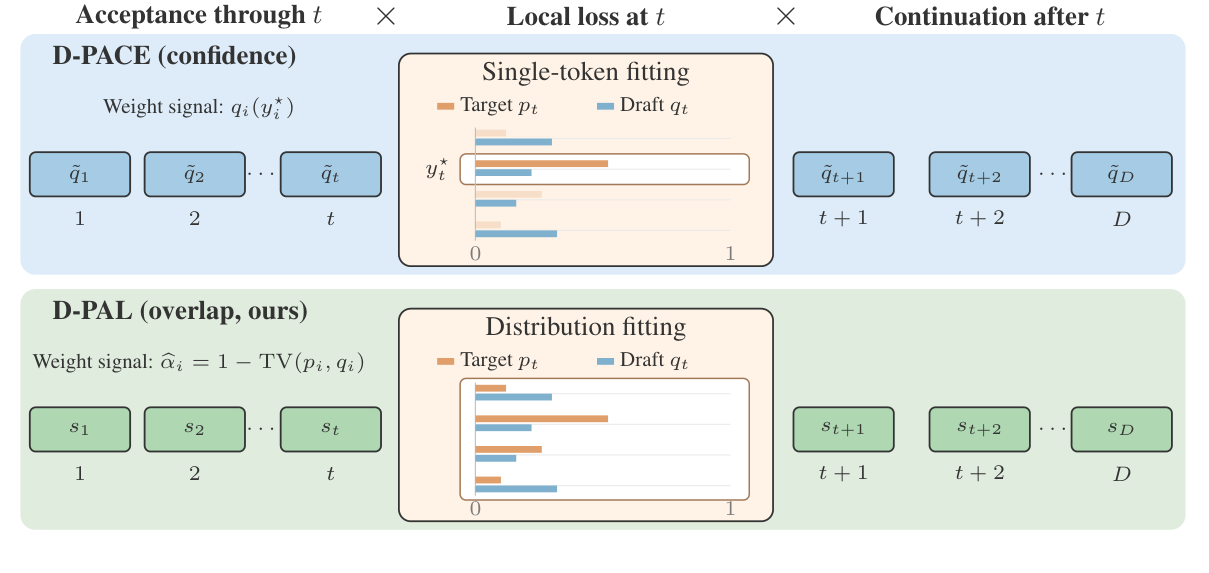
上方按单个记录 token 拟合,下方使用完整分布;每个位置还按前缀存活和后续收益加权。
Qwen3-4B、三层草稿、块长 16、单 L40S 单请求、六基准下,默认 Rényi 版在温度 0 时接受长度由 D-PACE 的 4.50 到 4.56,吞吐加速比由 3.11 到 3.14;温度 1 时分别从 4.20 到 4.28、2.79 到 2.85。改进较小但方向一致,摘要中的 4.57 对应 KL 版本。理论从拒绝采样推导,而所用 SGLang 后端实际采用 argmax 草稿及目标侧验证,不能直接把训练重叠量等同于运行时接受概率。
原文的同权重损失消融,更适合判断收益究竟来自权重还是分布拟合。
KNOX:可验证执行记录不等于语义判断无误
KNOX: Hardware-assisted Regulatory Sandbox for Generative Models
Vasisht Duddu, Adam Caulfield, Xi He · arXiv · 首发 2026-10-20
KNOX 在 Intel TDX 与 H100 可信环境内组织策略清单、参考监控器和带证明的执行图:工具调用先对照允许轨迹和 guard,记录通过或拒绝,再用哈希链及拓扑承诺供验证方检查。系统调用还需要 seccomp-BPF、Landlock 等 OS 层约束,监控器看不到工具内部所有调用。
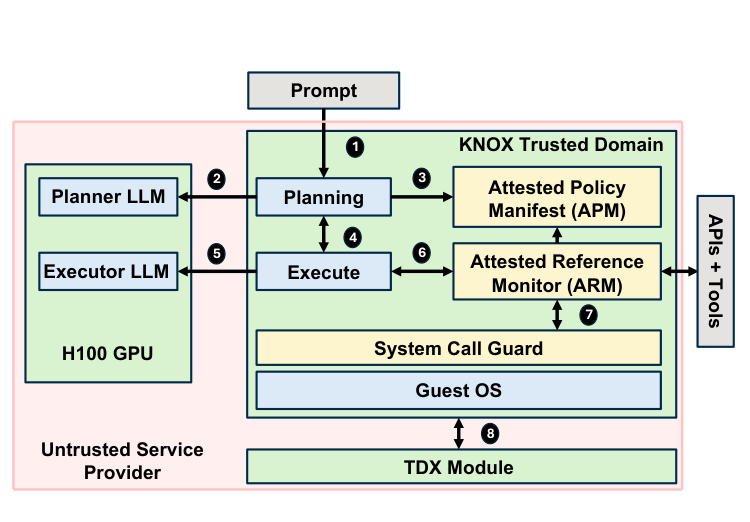
规划生成策略清单,执行动作经过参考监控器与系统调用 guard;证明保护执行记录,法规判断仍有模型误差。
100 个系统调用偏离案例中,监控器单独阻止 74%,加入 OS 沙箱后为 100%。但法规 guard 依赖模型判断,Gemma-3-12B 执行流上的违规拦截率为 81.8%,不能概括成全部违规均被阻止。论文还承认当前硬件证明没有直接绑定每次安装的 BPF/Landlock 规则。阅读价值在于区分“执行与证据未被篡改”和“政策语义判断正确”,以及识别它们各自依赖的可信边界。
社区动态:DeepInfer 的开源边界
ReignSwords 的讨论(2026-10-21)把关注点从“推理引擎开源”转向完整服务还缺什么。DeepSeek-AI 的项目说明明确列出已提供的调度、DSpark、SWA bounded replay 和结构化输出,也列出未包含的 KV cache 系统、VE/Prefill/Decode 解耦部署与跨副本负载均衡。对服务工程而言,算子与执行引擎之外仍有独立的状态和流量管理工作;帖文中的行数、热度和最小 GPU 规模不足以成为部署结论,这里不据此展开。