本期看点
本期最值得关注的是“分数究竟证明了什么”。FrontierCS 2 要求研发补丁在每个指标和保留工作负载上达标,CloudIR-Bench 则展示:诊断文字与参考答案相似,也可能根因错误。两篇分别从系统研发和事故分析切入,把最终交付能力与表面得分分开,适合优先精读。
其余进展沿着证据与状态两条线展开:失败归因研究尝试读出模型内部线索,配对崩溃测试检验真实执行理解,审批和独立验证工作追问证据是否共享同一盲点。系统侧,KVLearn、UlaCache、HAWK 与 RISK-KV 分别处理保留、寻址、传输和重建;Koala 把状态所有权交接从大规模搬运中拆出来。阅读时应留意,容量、吞吐、质量与可靠性各有不同分母。
01 · FrontierCS 2:让研发补丁逐项越过人类参考线
FrontierCS 2: A Benchmark for Computer Science R&D
Mang, Qiuyang 等 · 2026-10-21
计算机科学研发的难点,常常藏在一个已经能运行的系统里:改进关键组件,同时保住其他性能和质量要求。FrontierCS 2 把这种情境做成 48 项、覆盖 13 个领域的基准。多数任务从论文作者公开的代码出发,删除核心贡献,让 Agent 接手剩下的仓库;被删除的实现成为人类参考。它改变了“给一道题、交一个程序”的评测单位,把仓库探索、反复试验和最终方案选择纳入同一次研发过程。
反馈可以看,判卷依据不能拿走
任务构建先定位贡献代码,保留依赖及函数接口,并限制可编辑文件。参考实现用于测定各指标门槛;最终测试额外加入未公开的种子、查询或输入图。并非所有门槛都要求严格提高每个原始数值:例如视频稀疏注意力任务要求延迟不高于参考的 0.96 倍,同时给 PSNR、SSIM、LPIPS 留出明确质量容差。因此,“通过”应理解为全部条件达标。
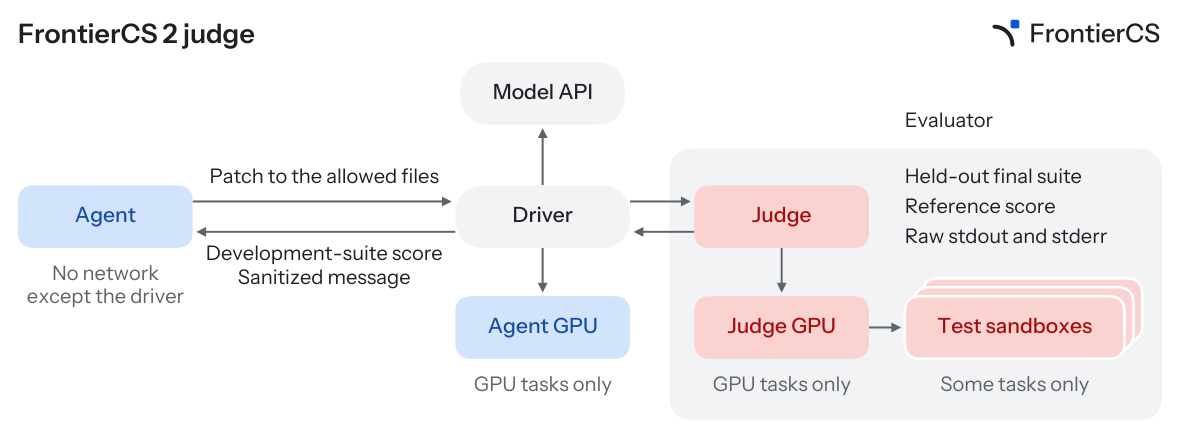
读图:Agent 通过 Driver 交补丁、接收开发集分数;评测器、最终测试和参考成绩留在右侧独立环境。开发 GPU 与判卷 GPU 分开,避免把自己的测量环境当作最终裁判。
每次运行最多五小时。Agent 可随时提交补丁,收到开发集分数和经过清理的反馈,却看不到原始评测输出或作者代码;沙箱网络只通向 Driver。最后必须自行指定一个最终补丁,评测方不会替它挑开发集最优版本。这一点很接近实际研发:有过一次好结果,并不代表能可靠选择可交付方案。
58% 的含义比一个榜单名次更重要
作者评估 12 个“模型+harness”组合,每个组合在每项任务上运行一次。Claude Opus 5.5 配合 Claude Code 的通过率为 58%,仍有 16 项任务没有任何运行通过。这里测的是整套 Agent,不能把差异全部归因于基础模型;单次运行也不足以估计每项任务的随机波动。
更值得关注的是,综合最终分数高于人类参考的运行,多数仍会在某个指标或工作负载上失守。平均收益能掩盖局部退化,延迟与质量混合成一个分数后尤其如此。论文同时报告逐项通过率、相对参考的分差,以及把任务难度和 Agent 能力放在同一尺度上的 FCI;这几个量回答不同问题,不能互换。
优先读任务构建和 Judge 设计。 对系统优化、研发型 Agent 和软件可靠性评测,它提供了更贴近交付的检查方式:既允许开放探索,也要求最终补丁守住多项约束。不过,重建已发表贡献仍不同于提出全新问题;公开论文可能带来预训练记忆,网络隔离不能排除这一点。文中另有超过 100 项私有任务的后续计划,它们不属于这次 48 项结果的分母。
02 · CloudIR-Bench:诊断文字相似,不等于根因正确
CloudIR-Bench: A Benchmark for Root Cause Analysis and Mitigation of Cloud Incidents
Tran, Hoang、Ha, Huong、Dang, Tri、Chan, Jeffrey、Zhang, Hongyu · 2026-10-21
云事故复盘包含症状、影响范围、服务关系和处置经过,适合研究模型如何从文字判断根因与缓解方案。但大量既有研究依赖公司内部报告,外部很难比较方法。CloudIR-Bench 的价值,是把公开事故报告整理成可复用的数据和评估框架,并直接展示自动文本指标与诊断正确性之间的距离。
先把事后答案从输入里分离
作者筛选 Azure、Google Cloud、Google Workspace、GitHub 和 Atlassian 五个平台,最终保留 950 份报告,其中有 911 条根因和 832 条缓解信息。字段数并不相等,不能把 950 当成两项任务都完整标注的样本数。采集后经过去重、关键词筛选、人工标注和共识核验;每份报告由两名具软件工程背景的作者独立处理。
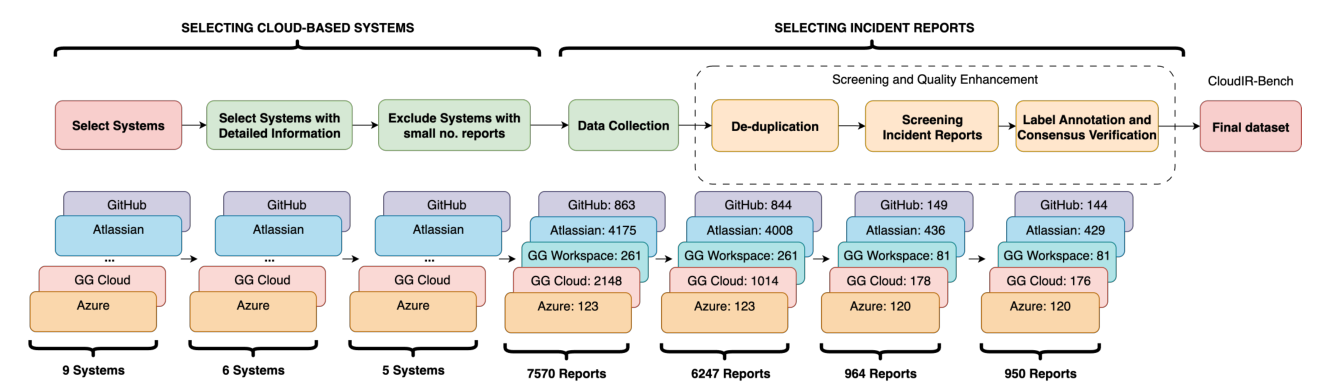
读图:先选取公开信息足够的平台,再对报告去重、筛选和核验标签;最右端的数据集来自逐层收缩的候选集合。
一个关键处理是清除事故摘要中泄露根因或处置结果的句子,尽量保留初报时能获得的信息。评估流程还用 GPT-4.1 压缩报告内容,再让模型根据标题与摘要预测。这样的设计把“读完复盘后抄答案”和“根据早期现象提出解释”分开,但也使结果依赖摘要是否保留了真正有诊断价值的细节。
模型会复述故障,却未必解释故障
框架比较八个 LLM 基线,以 BLEU-4、ROUGE-L、METEOR 和 BERTScore 衡量输出;每起事故生成十个候选以考察多样性。上下文示例对缓解预测的改善更稳定,对 RCA 的效果则随平台和指标变化。历史案例能提供常见动作,但动作听起来合理仍不代表适合当前事故。
人工分析尤其值得读。论文表格汇总的三个模型预测中,根因正确率为 26.4%,缓解正确率约 25.87%;这对应抽样分析,并非整个数据集的统一准确率。大量“正确”回答也只是大体对上,缺少技术细节。一个文件上传故障案例里,模型说出受影响功能,却把实际的负载均衡配置变更泛化成后端、API 或数据库问题。共享词汇和症状叙述仍可让自动指标给出较高分。
这使基准的启示超出模型排行榜:RCA 要判断的是因果解释能否支撑具体处置,仅检查答案是否像工程师写的报告会低估失败。公开报告也只记录组织愿意披露的原因,标签作者不是原事故处理者,部分案例可能本就缺少唯一确定根因所需的证据。
适合优先关注诊断评估的人阅读。 先看泄漏清理、模型输入和人工错误分类,再看自动分数。它提供的是文本事故诊断基准,不能直接代表接入日志、指标、追踪和执行工具后的线上 RCA 水平;公开材料的潜在预训练污染也仍未排除。
03 · 失败归因:把隐藏状态里的线索送到答案端
A Mechanistic Study of Automated Failure Attribution in LLM-based Agentic Systems
Zheng, Wendy 等 · 2026-10-20
直接提示模型定位 Agent 失败步骤,可能低估其内部表征包含的信息。作者在 Who&When 上训练线性探针,再以 grafting 连接关注故障步骤的 locator heads 与影响答案的 writer heads:训练时选头,推理时由定位头投票,向输出头注入对应步骤方向。
在 Algo 子集,Qwen 0.5B 的步骤准确率从最强提示基线 23.81% 升至 38.10%,探针为 36.51%。这里展示的是可读出信息与生成行为之间的差距,并不证明模型具备完整因果理解。选头仍依赖训练标签,运行时需访问内部激活;“推理不需标签”不能扩写成全流程无监督。适合结合方法和逐模型表格阅读,尤其注意长轨迹上改善并不一致。
04 · CATS:用个体归因压缩多 Agent 团队
Credit Where Credit Is Due: Contrastive Attribution Topology Search for Multi-Agent Systems
Tritthart, Fabian、Zehle, Tom · 2026-10-21
CATS 从人工设计的 Agent 超图中抽样团队,让归因模型比较同题轨迹、分配个体贡献,再更新连边概率、剪除弱边及不可达节点。角色、模型和工具保持固定,最终交付一个静态团队。
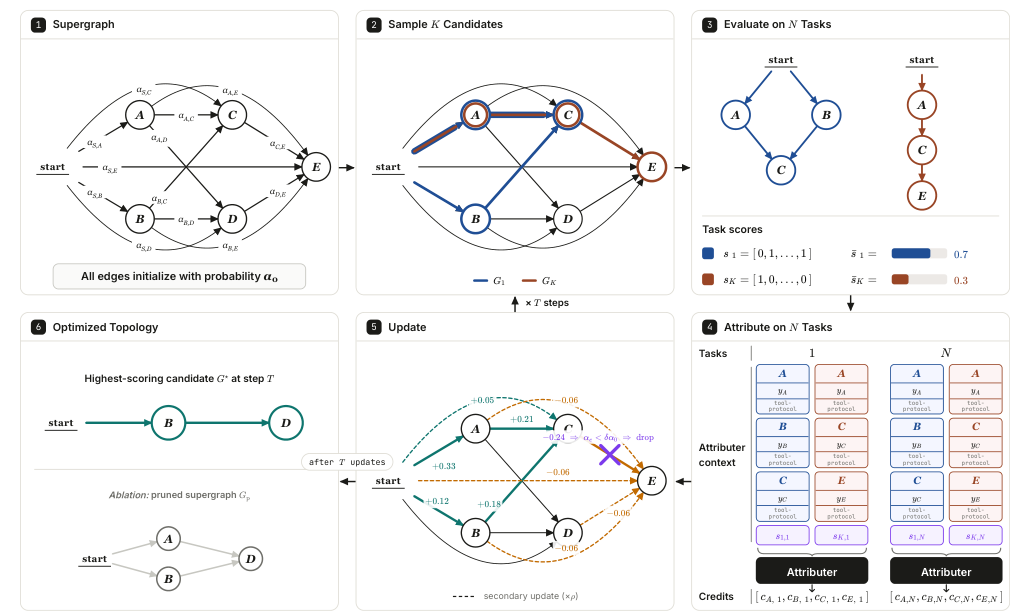
读图:超图生成候选,执行结果进入对比归因,贡献分数反馈到剪枝;最后选择最终轮次的最佳候选。
Gemma 4 12B 执行、31B 归因,三个种子和每项 100 道测试题下,BigCodeBench 得分为 48.0%,对照仅分数搜索为 42.7%,部署 token 少 54%。候选评估次数相同不等于算力相同,标准差也有重叠。HotpotQA 固定投毒测试中三次均排除了恶意提示 Agent,但这只是优化结果;信用分未经因果验证,也不能替代工具权限控制。
05 · 电信告警生成器:把不会告警的根因留在候选里
Every Alarm Has a Cause: An Open Generator of Telecom Alarm Storms with Exact Root Causes, Bound to NORIA-O, RFC 8632 and TMF642
Mandarapu, Madhulatha、Kunkunuru, Sandeep · 2026-10-21
这项工作从真实骨干网拓扑生成合成设备、服务、故障传播与告警,同时记录精确根因和传播路径。字段绑定 NORIA-O、RFC 8632、RFC 8345 与 TMF642,未知术语会使生成失败;丢失、重复、时钟偏移及重叠故障都由配置控制。
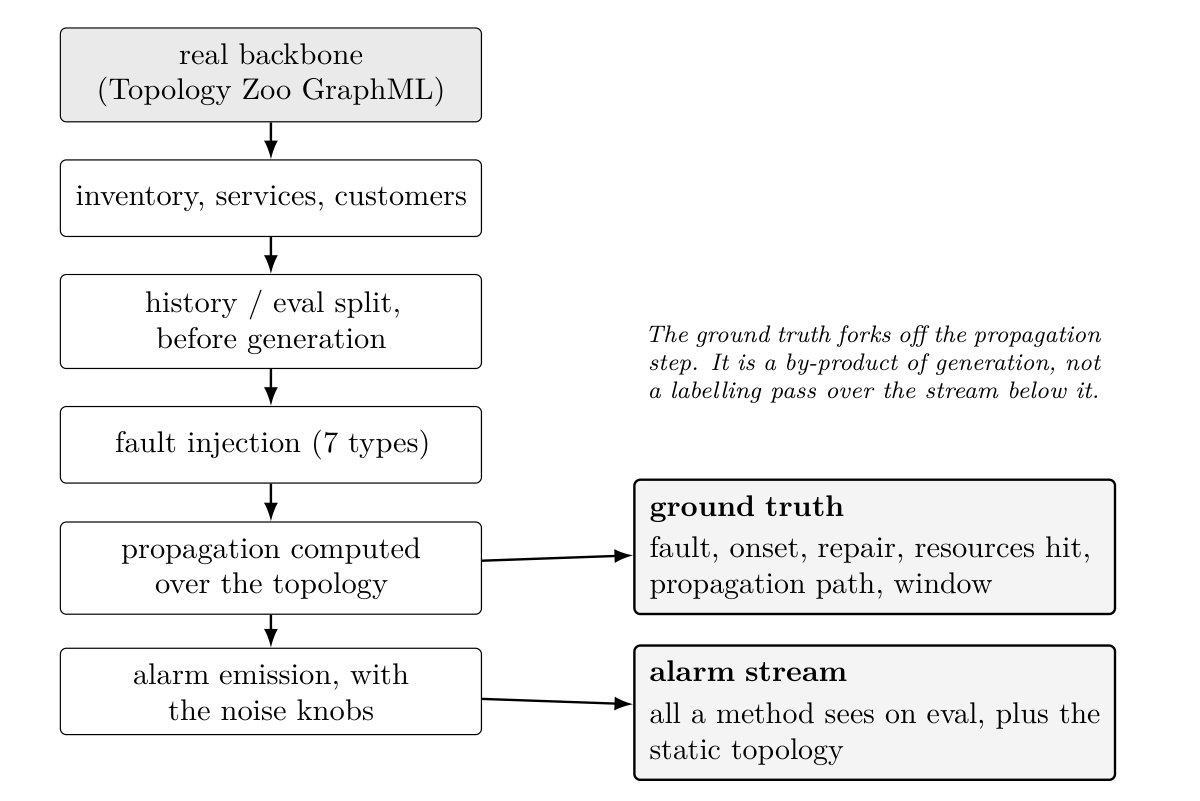
读图:真实拓扑向下生成合成资产和故障;传播阶段同时分出真值与告警流,评估方法只读取允许的观测。
值得关注的不是复杂模型必胜,而是候选集合。站点断电时,根因本身无法上报告警,只给“已告警设备”排序会系统性漏诊;沿拓扑寻找沉默节点才有机会定位。简单的最早严重告警规则在多个生成配置中也很强。真实 PCIC 对照使用从类型级因果图推导的标签,与合成设备级任务不同,不能直接比较准确率。适合用来研究信息缺失与评测偏差,尚不能把生成器的精确标签等同于生产真实性。
06 · KVLearn:缓存保留要同时算复用与资源成本
To Keep or Not to Keep: Learning KV Cache Retention in Disaggregated LLM Serving Systems
Liu, Dong、Yu, Yanxuan、Jiang, Eric、Wang, Shu、Wu, Ying Nian · 2026-08-10
KVLearn 为 prefill/decode 分离系统增加缓存保留控制面:小型 MLP 预测前缀复用,成本分数结合重算、传输和占用,反馈控制器随池压力调整准入阈值。它把“值不值得存”与“满了淘汰谁”放在一起,避免短而低价值的前缀挤走昂贵状态。
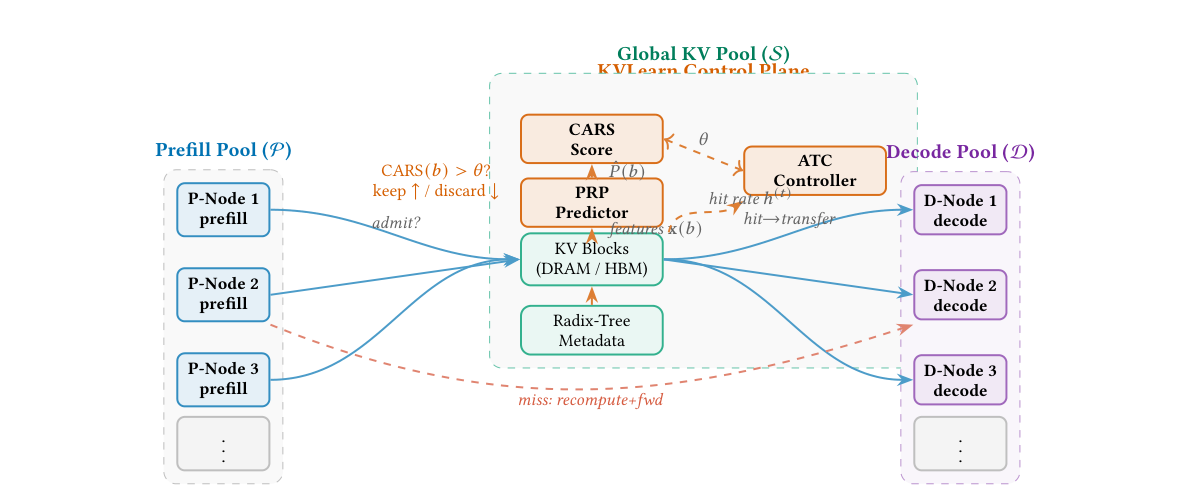
读图:左侧计算 KV,中间控制面决定保留,右侧 decode 取用;命中率与池压力反馈到后续决策。
论文 Small 配置为 8 张 A100、256 GB 池、200 Gbps 网络,MM-Session 表格中 TTFT 为 38.2 ms,Mooncake-LRU 为 52.5 ms。数字只适用于所列回放条件;正文与表格的部分负载规模、传输口径并不一致,成本推导中的链路抵消也有解释张力,暂不据此推广最优性结论。原文首版标为 8 月 10 日,不是本期新首发。
07 · SYSRB:同一输入,也要测不会崩溃的版本
Do Coding Agents Understand Why Systems Crash—and Why They Don’t?
Huang, Chenxi 等 · 2026-10-21
SYSRB 用 Linux 与 OSS-Fuzz 的 934 对源码树测试执行推理:每对只差一个提交,同一输入在其中一边崩溃、另一边正常。Agent 可以搜索源码,却不能编译或运行复现输入;评估比较两边预测崩溃的概率,避免只认出可疑代码就拿高分。
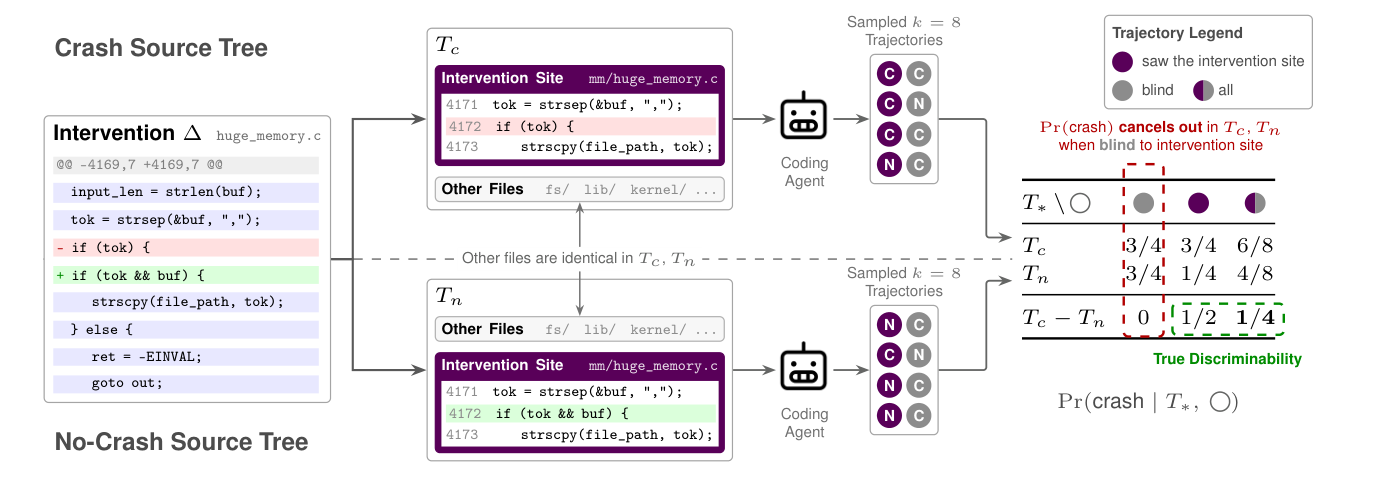
读图:同一输入分别进入仅差一个提交的两棵源码树,对比预测差异,排除只认出可疑代码的偏差。
每个版本采样八次、单次最多两小时,最强组合的真阳性率为 72.5%、假阳性率 4.8%,仍漏掉超过四分之一真实崩溃。找到决定性代码也不保证理解它如何影响远端崩溃点。它适合衡量纯源码推理与检索的差别,不应当作允许动态调试时的完整修复能力。
08 · MicroPerf-Bench:优化必须改善整套服务
Benchmarking Coding Agents for System-Level Performance Optimization
Zhang, Yanze 等 · 2026-10-21
MicroPerf-Bench 在七个微服务应用中构造 65 个性能优化实例,用受控反模式注入建立可归因的退化,再重建容器、检查功能和运行混合负载。评分衡量恢复了多少注入的延迟损失;增加硬件、关闭追踪或放松事务安全都不能算有效优化。
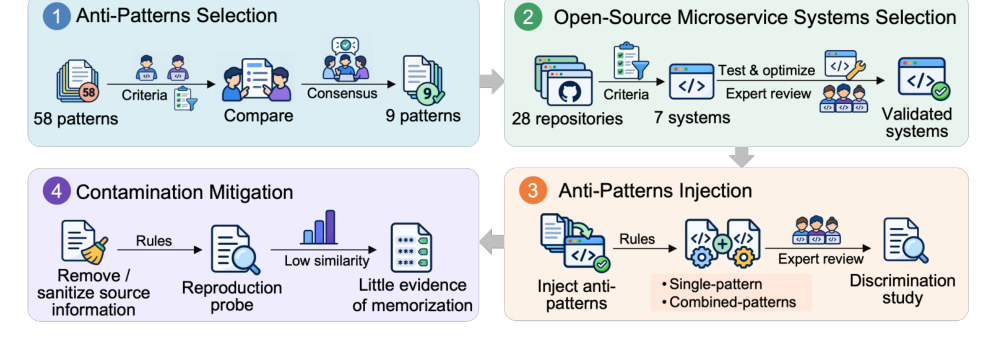
读图:选择反模式和应用,再注入、验证和清理泄漏线索;功能检查与性能测量共同约束实例。
九种模型与 harness 组合各运行三遍,共 1,755 次试验。平均恢复分为 34.8/100,完全恢复占 16.7%;许多零分补丁能编译且功能正确,却没有降低端到端延迟。它把瓶颈识别与代码生成分开,是这项工作的主要价值。结果受注入模式和固定负载约束;额外 profiling 实验仅单次,不能与三次均值视作同等证据。
09 · D-Pingmesh:让探测跟着网络重配置变化
D-Pingmesh: Dynamic Probing and Fault Localization for Reconfigurable Datacenter Networks
Wei, Yunze 等 · 2026-10-21
可重构网络里,相同探测流在控制面更新前后可能走不同路径。D-Pingmesh 读取拓扑、转发权重和哈希信息,优先选择能补足接口覆盖的探测;配置变化后重放旧列表、修补缺口,而非全部重算。Rho-EM 再同时估计新旧路径混合比例与故障集合。
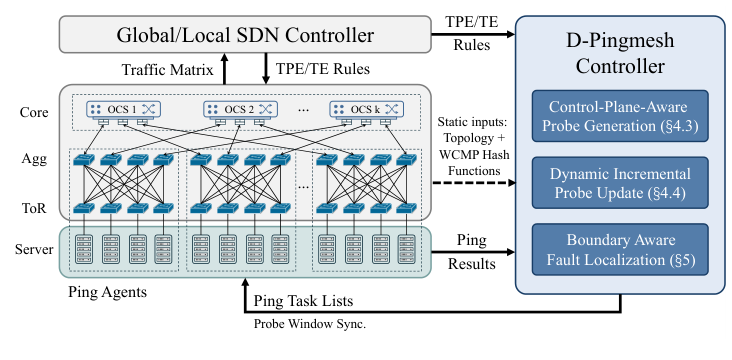
读图:控制面规则进入探测生成、增量更新与边界定位,主机返回探测结果形成反馈。
八 pod 拓扑、0.99 覆盖目标下,作者报告所需探测任务数约为 Pingmesh 的 1/17.7;ns-3 边界窗口实验中 micro F1 从 deTector PLL 的 0.871 提高到 0.953。核心收益来自正确解释跨更新窗口的证据,而非简单多发 ping。部署需要可信的控制面快照和路径解析,模拟精度不能直接视为生产定位率。
10 · UlaCache:减少稀疏 KV 历史的重复占用
UlaCache: Unified Logical Addressing for Sparse LLM Serving
Zhu, Isaac 等 · 2026-10-21
稀疏注意力每步只读少数 KV,却仍须保留可能再次被选中的历史。UlaCache 用稳定逻辑地址连接 GPU 与 CPU 存储,在 TP 下跨卡分散历史,在 DP 下管理本地共享池;PB-LRU 用桶与位图批量更新近期访问,搬完数据才更新映射。
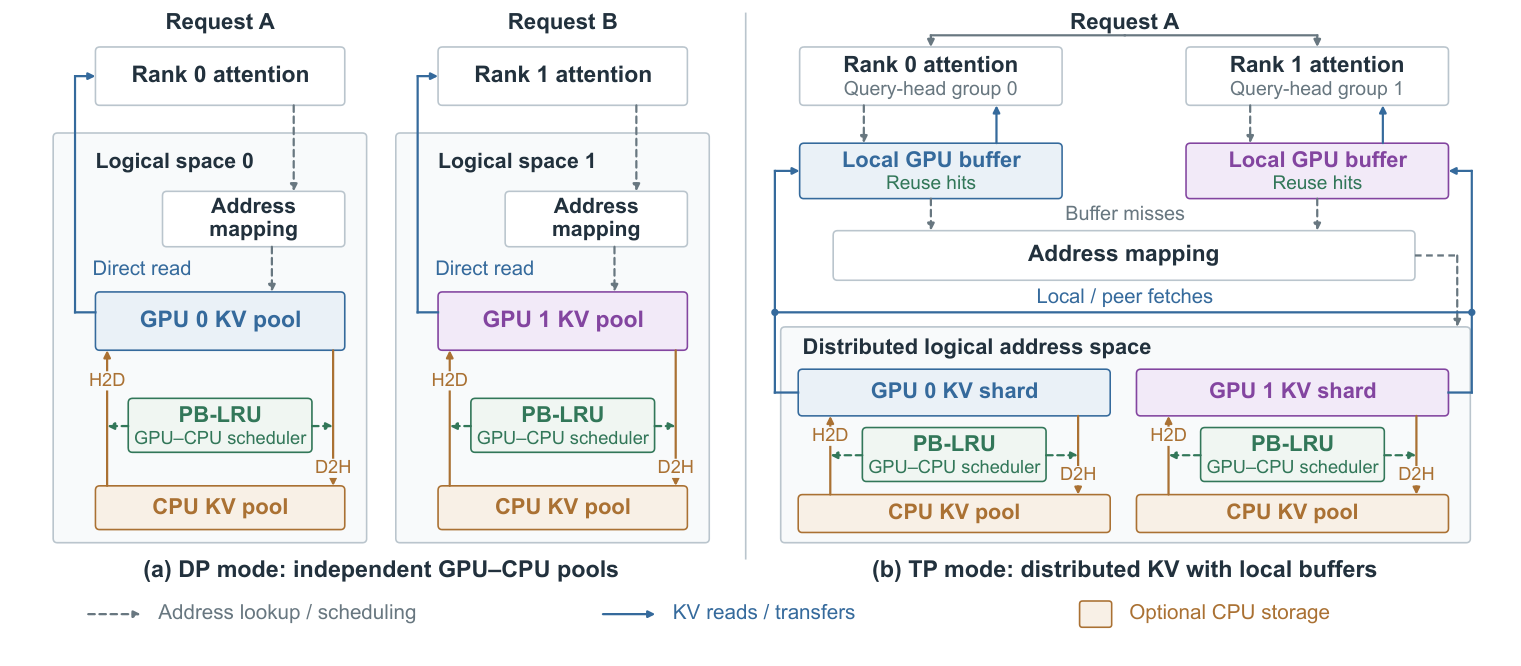
读图:左侧 DP 管理本地 GPU/CPU 池,右侧 TP 聚合跨卡历史;映射与缓存缓冲把逻辑引用连接到实际位置。
GLM-5.3、64K–128K 输入的 decode 实验中,8×B300、TP、关闭推测解码时,峰值吞吐为 SGLang 的 3.51 倍。比较取各方案各自峰值,且先完成所有 prefill,不能解释为同批大小或整请求加速。单请求时仍慢于纯 GPU SGLang,体现地址查询、调度与通信换取容量的代价。
11 · HAWK:异构 KV 传输要理解目标内存布局
HAWK: Heterogeneity-Aware KV Cache Transfer for Efficient GPU-NPU Phase-Disaggregated LLM Inference
Park, Junhyeok 等 · 2026-10-21
HAWK 将 prefill 放在 GPU、decode 放在 NPU,难点在于双方 KV 张量布局和直接通信接口不同。它在 NPU 按 DRAM 通道分配符合张量布局的 RDMA 缓冲区,再组织 GPU 侧变换与传输,减少主机中转及到达后的跨通道重排。
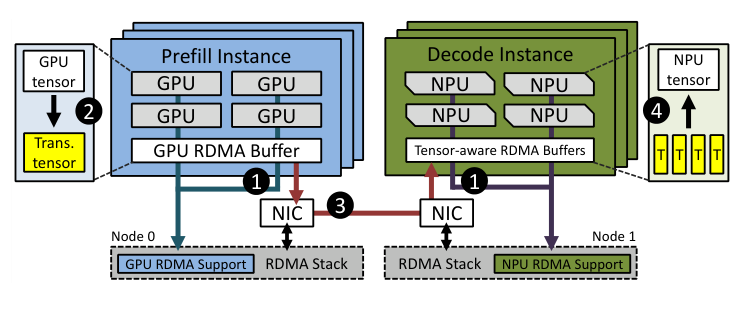
读图:GPU prefill 产生 KV,经布局处理和直接传输送到 NPU decode;两端仍保留各自适合计算的布局。
作者在 A100 与 Tenstorrent p150a 系统上比较在线服务;聊天和摘要负载以 90% SLO 达成为边界时,TTFT 可支撑请求率与 GPU 直接传输方案相差 2.90% 和 5.90%。这是指定硬件和延迟目标下的效率折中,不能推广为任意 NPU 都更快。功耗分析使用设备 ASIC 功率,也不能替代整机能耗或完整拥有成本。
12 · RISK-KV:按恢复后的质量决定哪些状态可省
RISK-KV: Quality-Aware Selective KV Cache Reconstruction for Distributed LLM Inference
Yuekai, Wang · 2026-10-21
RISK-KV 保留目标层两侧的精确 KV,用离线训练的岭回归预测中间层隐藏表示,再接原模型投影重建 KV。层选择依据实际恢复导致的 NLL 变化,而非仅按张量相似度或随机噪声敏感性排序。
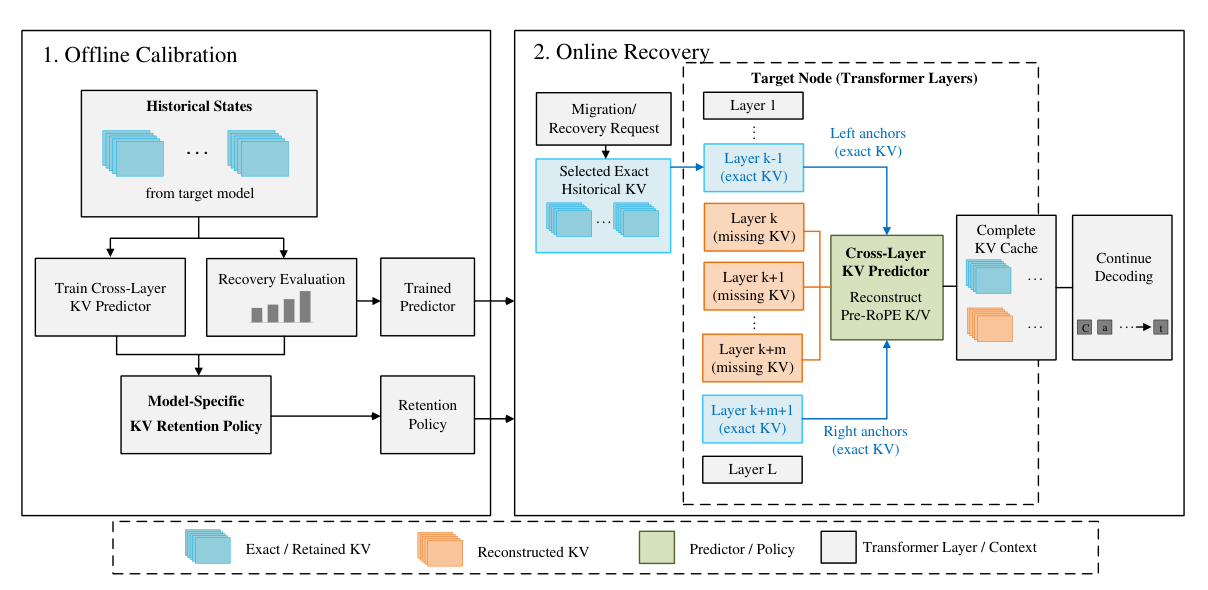
读图:左侧校准预测器和保留策略;右侧迁移时保留锚点,重建缺失层,再继续解码。
在三个 0.5B–1.5B 级模型、WikiText-2、512 token 历史及后续 512 token teacher forcing 下,质量预算 0.005 的独立评估报告历史 KV 节省 33.3%、33.3%、21.2%。这是原始缓存省略量,预测器和辅助状态会抵消净收益;小样本 NLL 也不足以证明长文本生成质量或分布式服务加速。
13 · Koala:先转移所有权,再按需搬状态
Koala: Non-disruptive Reconfiguration for Long-running Stateful Dataflows
Huang, Lei 等 · 2026-10-20
Koala 将键的逻辑所有权与状态位置分离。重配置先交接 Key Lookup Table,让新任务接手事件;首次访问才搬对应键值,冷状态留在原处。旧任务转发在途事件,上游用标记确认路由切换,水位线同时覆盖上游与临时 peer 通道。
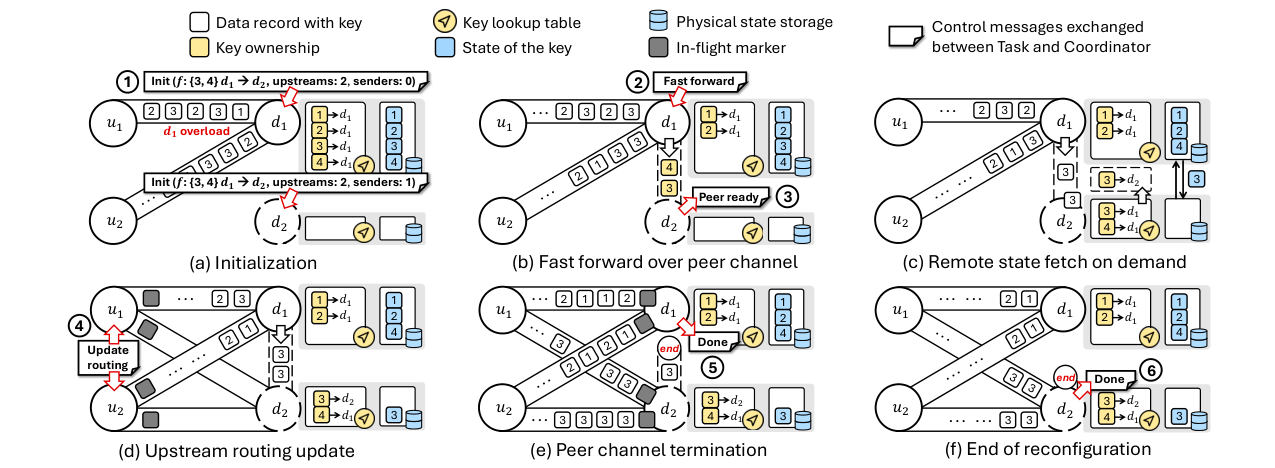
读图:先建立转发与所有权交接,再更新上游路由;访问热键才取状态,确认旧消息排空后结束临时通道。
扩容实验中,相比 DRRS,真实查询平均迁移状态少 8.7 倍;部分基线在十分钟窗口内仍未排空积压,因此约 23 倍的恢复差距带有下界含义。收益依赖冷热局部性,且协议假设重配置期间无故障,失败仍回退检查点。适合关注长期流作业弹性与状态语义的读者。
14 · 审批监控:共同读错来源,比票数更关键
Correlated Failures of AI Approval Monitors
Zanolini, Luca · 2026-10-21
多个监控器共享模型或被污染的数据源,错误就可能相关。论文用分布式系统中的共同失效集合描述审批规则,并区分“误批坏动作”和“误拒好动作”两种方向;安全与可用性取决于两类集合是否共同覆盖所有监控器。
支付审批实验中,按独立来源组合的规则在同等安全水平下,将正确支付的拒绝率从最佳计票规则的 7.4% 降到 0.9%。但预注册最坏情形测试失败:一次攻击让剩余批准者都只读同一来源,十二个语言模型监控器无法共同保证安全与可用。加入不可被语言说服的规则引擎才恢复所测条件。它支持来源多样化,不构成未知攻击下的保证;适用前提还包括请求本身合法、字段可由外部记录核验。
15 · 上下文压缩:来源类型丢失后,记忆会替外部文字背书
Compaction Laundering: Provenance Destruction in Context-Compacting Coding Agents
Dabirsiaghi, Arshan · 2026-10-21
这项安全研究定位到一个具体边界:把带角色类型的对话拍平成文本后,工具内容里的角色标签可能与真实用户消息混淆,摘要随后把外部文字写成用户授权。作者对五种拍平序列化和四种保留角色类型的方案进行受控比较,报告前者记忆洗白率 87%–100%,后者在所测攻击下为零。
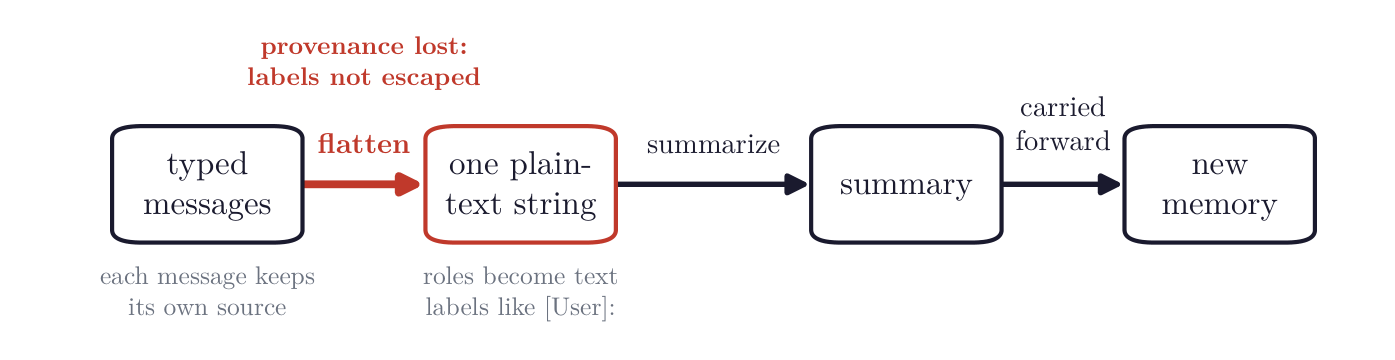
读图:先看 typed messages 到纯文本的边界:来源在这里丢失,之后摘要会把结果继续当作记忆。
这里大部分实验驱动的是固定版本的摘要提示与序列化组件,并非九个产品全部端到端运行;真实 pi TUI 的配对试验另行报告约 50% 指令发出率,干净对照为零。关键是保留不可由文档伪造的来源元数据,并在压缩后核对授权出处。零成功率仅限所测攻击,来源修复也不能替代运行时权限。
16 · 独立验证:测试证据也需要隔离上下文
Who Verifies the Builder? Toward Independent Assurance for Agent-Produced Software
Sion, Sion Israel、April, Alain · 2026-10-16
框架先让验证者仅按规格生成并冻结测试,再开放实现,结合变异测试等补强证据;构建者收到反例而非隐藏测试代码。三个有状态服务的研究中,46 个植入故障上,同模型新上下文的两阶段验证检测率为 95.4%,构建者自测为 85.1%。
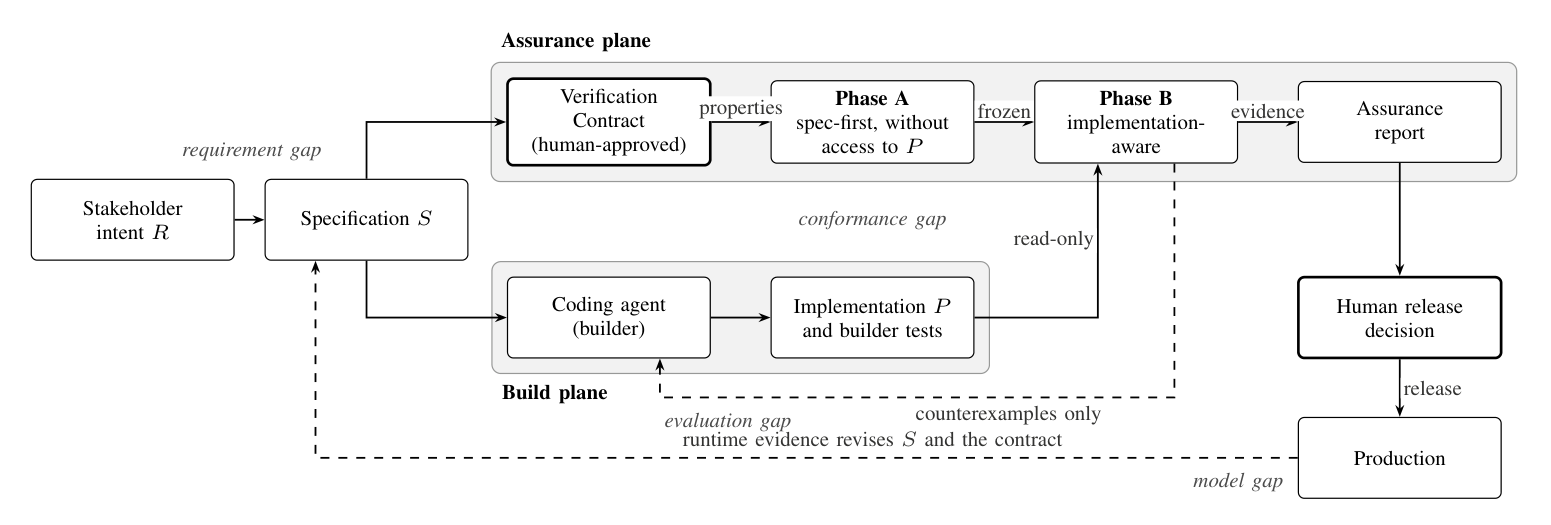
读图:规格先进入验证契约与独立证据生成,构建者接收反例,最终保证报告交给人工作发布决定。
但构建者最终程序本身全部通过隐藏测试,这证明的是自测证据不完整,而非观察到实际生成代码普遍有错。换另一供应商模型没有增加检测;验证 harness 还曾误执行参数化测试,制造大量假失败。阅读价值在于同时审查独立性、测试 oracle 和发布门禁,不能把多一个验证 Agent 当成自动质量保证。
17 · AI-GREEMENT:把协议知识、验证与实验接成研发循环
The End of Consensus Research?
Burgelin, Clément 等 · 2026-10-21
作者为共识研究构建专用 harness,将概念化知识库、模块化实现骨架、Lean 安全性验证和性能/故障反馈放进迭代过程,得到 A-GREEMENT:以租约支持本地读,根据键热度、拓扑及读等待代价选择不同写路径。
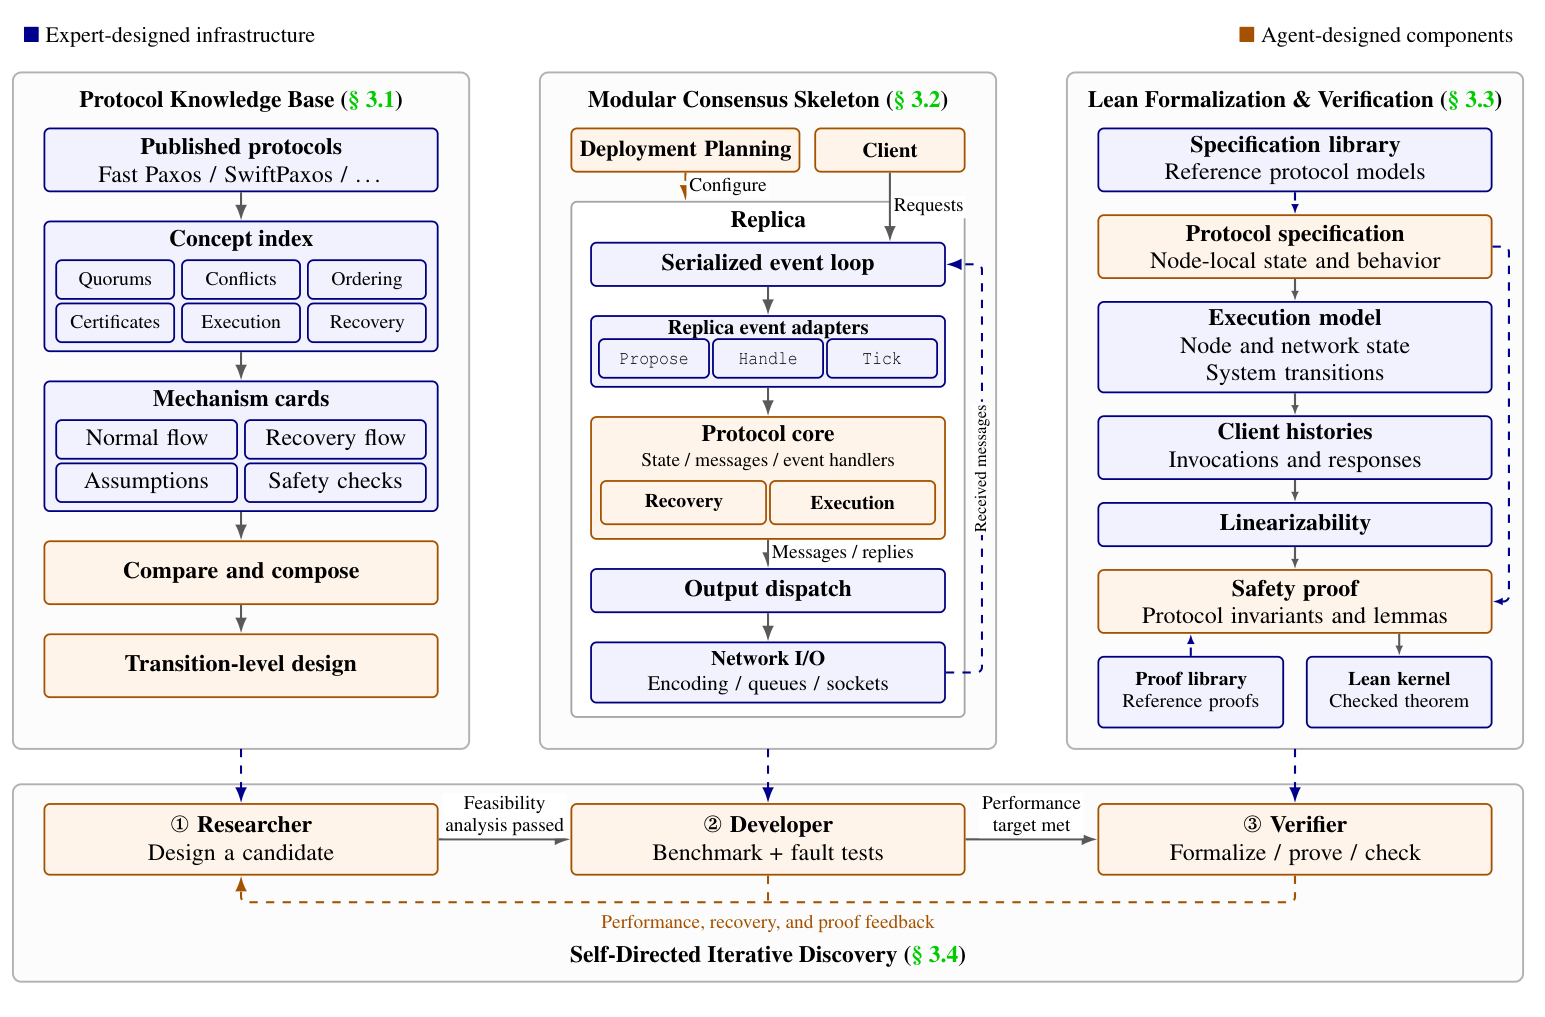
读图:三列提供协议知识、执行骨架和 Lean 验证,底部研究、开发与验证角色通过性能及故障反馈迭代。
在 CPU 集群上模拟网络条件、对六个 5 或 9 副本部署等权平均,50% 写与 5% 写负载的平均延迟分别比最快对照低 12.2% 和 33.3%,纯读相当。大副本配置没有混入该均值。形式化当前针对安全性,不含活性;通用 Agent 对照还缺少相同知识支持,不能把差距全部归于 harness。论文标题是反问,实质是专家约束下研发流程的改变。