本期看点
Agent 的可靠性正在被拆成更具体的系统问题:工具给错信息后,Agent 会怎样继续;执行框架有没有忠实传递错误;已经发生但尚未确认的外部动作,恢复时还能不能重试。本期重点读 MCP-Injector 与 TraceTrial-Bench,前者主动制造故障测韧性,后者用跨边界证据检查框架义务,两者共同说明最终答案不足以评价整个执行过程。
其余入选工作分别处理执行前环境检查、多 Agent 讨论中的纠错、授权变化下的恢复,以及 KV 缓存回读。社区动态补充 AKV 的缓存操作语义与 Resin 的运行时边界。它们提供了不同层次的干预点:让错误更早可见、让恢复有依据、让性能优化保留明确的适用条件。
01 · MCP-Injector:工具故障下,规模不能替代恢复机制
Tool-Calling LLM Agents Under Realistic MCP Faults: Scale Does Not Purchase Fault Tolerance
Antonio Ken Iannillo, Joshua Segun Owotogbe, Roberto Natella, Francesco Avallone, Kristina Kudryavtseva, Indika Kumara · 2026-10-23
把故障放进工具调用边界
一个 Agent 能在工具正常时完成任务,并不说明它能应对错误结果、类型变化或永不返回的调用。MCP-Injector 把这些外部故障变成可控制的实验条件:代理夹在 MCP 客户端与服务器之间,观察调用、决定是否注入、执行故障操作,再记录发生了什么。它既能修改真实返回值,也能制造延迟、显式错误或静默挂起,无需改写被测 Agent。
新意主要是故障画像与持续方式。作者从 1,774 个仓库的 57,240 条 issue/PR 线程中归纳故障,把六类表现与永久、瞬时、间歇三种持续模式组合。随机种子控制注入调度,空操作代理则用来检查代理本身是否影响结果。但这些比例描述的是公开报告里的故障构成,不能当作线上调用的故障概率;最终注入画像中约 91.3% 为永久故障,更适合解释为压力测试。
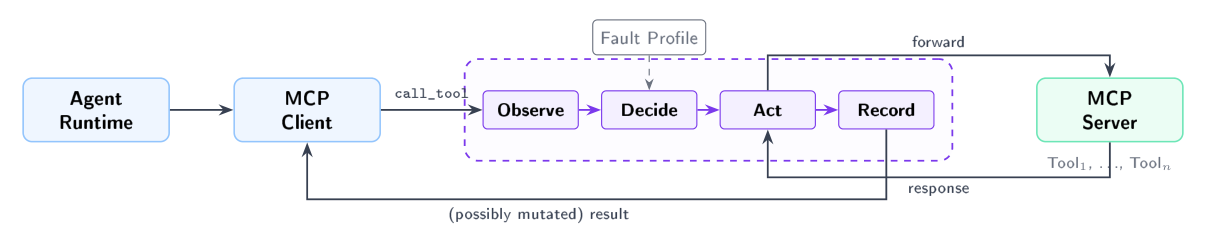
读图:调用依次经过观察、决策、执行和记录;返回路径可以携带被修改的工具结果。
“运行结束”和“任务做好”差得很远
实验在 25 个单服务器任务上,交叉比较 gpt-oss-20B/120B、三种 Agent 栈、三种代理条件与三个种子,共 1,350 个实验单元。模型在 Apple Silicon 上通过 LM Studio 以 MXFP4 运行,共用 16K 上下文;每任务有 3,000 秒超时,框架另有循环上限。任务质量由 LLM 裁判重复评分并取中位数。
注入故障后,汇总任务完成质量分从 8.08 降至 3.23,约下降 60%;即使只看两种条件下都正常结束的运行,降幅仍达 57%。因此,监控“进程没崩、Agent 给了答案”会漏掉大量质量损失。部分 Agent 甚至绕过工具,凭已有知识给出看似合理的回答,使完成分与工具依据进一步分离。
120B 相对于自身无故障基线的质量保留比例,没有显示出优于 20B 的证据(p=0.96)。它在故障下的正常完成率为 91.1%,20B 为 95.6%,但差值的 95% 置信区间跨过零,不能据此断言扩模降低可靠性。三种框架的表现也不同,不过调用次数与错误处理同时变化,框架效应仍是提示性证据。
随机种子还需要谨慎理解:它让给定调用历史下的注入决定可重放,却不能让整个 Agent 运行逐位一致。模型生成与裁判仍有随机性,Agent 改变工具调用顺序时,实际故障暴露也可能变化。把调度可控性与端到端确定性分开,才能合理设计后续对照实验。
优先读故障画像和结果分解。 对 AgentOps 的实际推进,是把返回内容、超时、重试与答案依据纳入同一个测试,而非只比较正常任务分数。研究仅覆盖同一模型家族、25 个单服务器任务,实际触发的瞬时与间歇事件很少;不能将结论推广为所有模型或所有故障下的规模定律。
02 · TraceTrial-Bench:成功答案也可能掩盖执行框架缺陷
Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
Zhiyong Cao, Hengjie Zhu, Yongxin Wang, Xuchen Li, Jintao Li, Shuxia Liu, Dunqiang Liu, Bo Wang, Kairan Zhang, Cong Lin, JiangDi Yu, Siyuan Liu, Sijia Yao, Yi-Liang Wei, Lingxu Ma, Aijia Wang, Anxin Chen, Zixian Wei, Xiang Ruan, Ruizhi Xu, Ruqian Shi, Baihua Xiao, Sicheng Zhou · 2026-10-23
为任务结果与框架义务分别记分
Agent 出错之后,换模型往往比定位执行框架更容易,但最终答案无法告诉我们工具退出码是否被保留、长输出是否被截断、子任务是否正确结束。TraceTrial-Bench 将 harness 作为被测系统,围绕上下文、执行、治理、生命周期、可观测性、工具和验证七个维度,构造 95 个有明确触发条件与外部真值的任务。
它保留框架原生的提示构造、权限和工具运行方式,通过适配器收集轨迹。每个任务分别检查 Agent 的动作与交付物,以及框架是否履行执行和信息传递义务。工具实际返回、模型看到的内容、会话日志和最终文件不一定相同;例如进程已超时,模型收到的结果却可能没有超时标记。只有跨边界对照,才能识别信息在哪一层丢失。
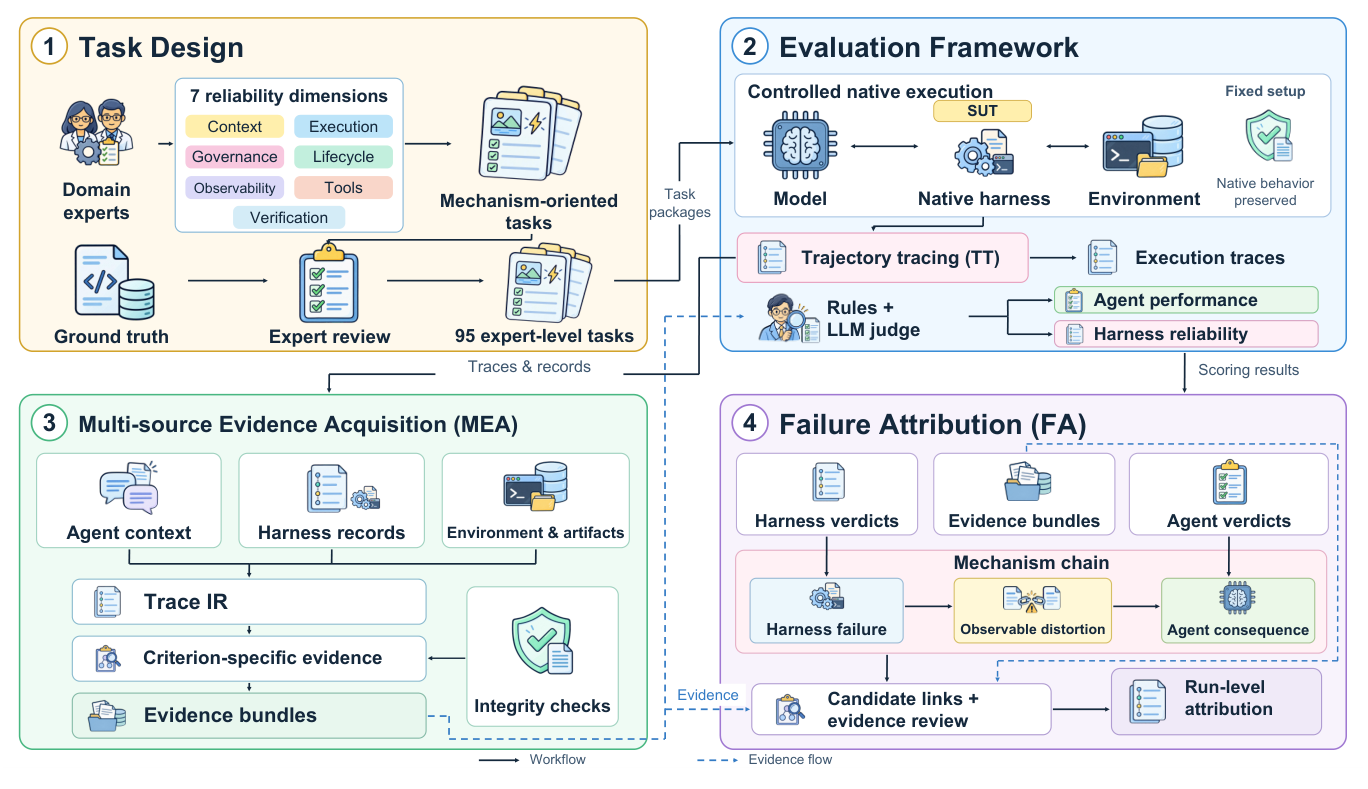
读图:任务驱动原生框架执行,多源证据分别支持两层评分,候选机制链还需证据审查。
归因需要中间证据
系统把原生记录规范化为统一事件序列,但保留原始来源;无法可靠对应的调用与结果不会被强行配对。评分根据预先声明的选择规则取得证据包,环境账本证明实际效果,模型侧记录证明当时可见的信息,文件差异证明最终交付状态。这使框架检查有机会摆脱 Agent 自己的成功宣言。
实验交叉四种框架、九组模型和 95 个任务,共保留 3,420 次执行。39.5% 满足全部 Agent 条件,只有 8.4% 同时满足 Agent 与框架的全部条件。两者分母相同,但衡量的问题不同;后一个数字不是“其余全部崩溃”。任务成功率最高的框架也不是框架条件通过率最高的框架,说明单一总榜会遮蔽系统取舍。
不过,两层同时失败仍不等于因果关系。论文将预先声明的端点和激活条件匹配称为候选机制链接;确认传播还需要核对两端判断、事件顺序、中间信息失真与替代解释。它也没有把每个不通过的评分项都直接称为已确认的软件缺陷。
另有 31.1% 的运行出现框架评分项不通过,却满足全部 Agent 条件。这类结果说明应用层可能吸收某些问题,也说明只保留最终成功样本会遗漏框架薄弱点;它本身不证明这些问题在别的任务里同样无害。
值得借鉴的是证据契约,而非直接照搬名次。 每个组合只有一次选定执行,部分来自恢复替换;任务预算和裁判输出预算并不完全一致,也没有估计组合内重复性。对平台团队,这套方法适合转成框架回归测试:独立保留外部真值与模型可见结果,分别检查任务完成和运行义务,再对失败建立可审查的解释链。
03 · StateMirror:先验证环境前提,再执行工具
StateMirror: Pre-Execution Detection of Hallucinated Tool Calls in Coding Agents
Shiwen Shan, Yintong Huo, Zhiying Wu, Yuxin Su · 2026-10-23
工具调用语法正确,引用的文件、模块或导出符号却可能不存在。StateMirror 在执行前规范化动作,通过命令分析与 Python AST 提取前提,再对当前工作区做只读探测;无法静态确定的值不提取,无法可靠判断的条件保守放行。因此它检查的是动作可执行性,不负责证明补丁语义正确。
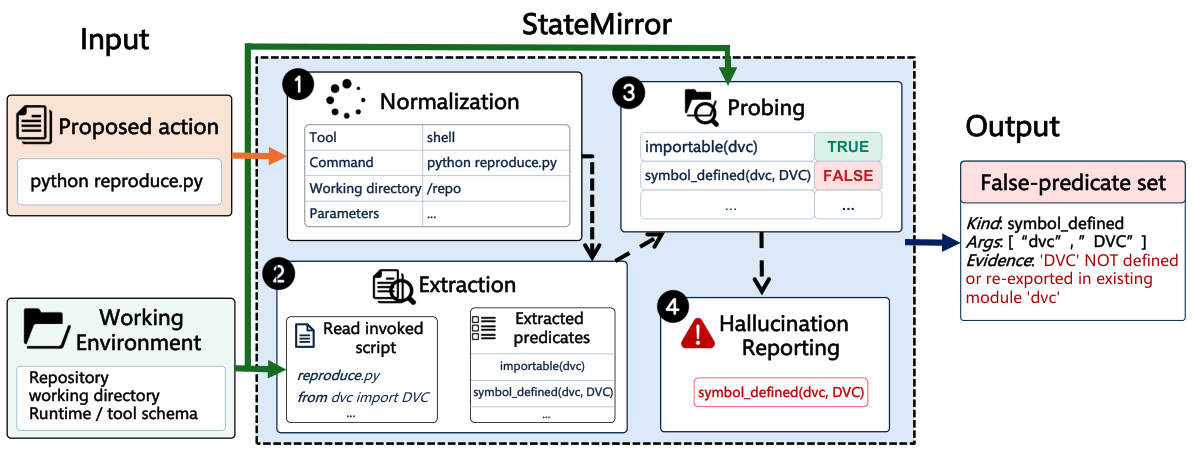
读图:动作规范化后提取谓词,环境探测把确认不成立的条件交给报告阶段。
在四种 Agent 来源的 2,508 个动作上,精确率为 0.940、召回率 0.722、F1 为 0.817;检测不使用 LLM token。Apple M4 Max、36 GB 内存的实验中,中位延迟 1.50 毫秒,但 p95 为 306.66 毫秒,不能只用中位数估计所有动作的开销。主要漏检来自前提提取与状态重建,成功轨迹子集的召回率也更低。它为编码 Agent 提供了具体的执行门禁思路,边界在于可提取、可检查的环境事实。
04 · 多 Agent 通信:正确的少数意见如何在讨论中消失
Understanding Communication Failures in Multi-Agent LLM Systems
Priya Pitre, Jun Hou, Yi Fang, Naren Ramakrishnan, Xuan Wang · 2026-10-23
这项研究从 7,300 次任务运行中取出 3,211 条失败的多轮轨迹,将行为压缩为带证据的卡片,再通过标签映射、聚类与分类扩展建立通信故障体系;200 条失败轨迹接受人工标注核验,另用 500 条成功轨迹作对照。
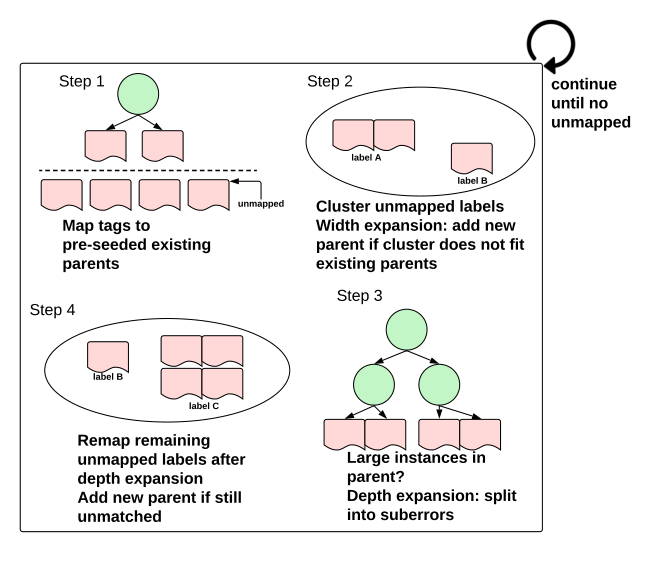
读图:先映射已有类别,再对未覆盖标签聚类,扩展类别和细分错误后重新映射。
值得关注的是讨论的时间结构:第一次看到同伴回答后,共识问题增加,后续轮次更多表现为纠错失败。研究建议保留分歧和纠正信号,而非只增加参与 Agent 的数量。HotpotQA 与 MuSiQue 的对照中,检索使总体失败率从 74.6% 降至 36.4%,但这是特定问答任务的结果。分类主要来自失败样本,且包含 LLM 标注;它适合作为通信诊断词表,不能据类别占比推算线上故障率,也未充分覆盖文件协作和长程工具工作流。
05 · Permission to Retry:恢复进度之前,先保留外部效果的不确定性
Permission to Retry: A Study of Authorization and Recovery in AI Agent Workflows
Deekshith Marla, Kushagra Bhatnagar · 2026-10-22
请求可能已经产生效果,却丢失确认;恢复时权限也可能已被撤销。论文把检查点、当前发送权限、外部效果证据与对账权限分开,在 LangGraph、Temporal 上交叉 14 种调度、三类提供方契约和四种应用策略,得到 336 条有限测试历史。
保留账本的对账策略在每种宿主的 42 条历史中全部满足声明的契约,但其中只有 21 条确认完成,另有 15 条拒绝、六条保持未知并保留预留。这个分解比“100% 通过”更重要:安全恢复有时意味着不重新发送,也不假定旧请求失败。两种宿主的配对结果一致,不代表框架所有行为等价。研究使用脚本化提供方和特定权限契约,不能据此宣称真实 IAM 与外部系统间的原子性。原文没有独立方法架构图,本节用文字说明恢复边界。
06 · KVStream:让空闲存储带宽分担 KV 回读
KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving
Avinash Maurya, Jaiaid Mobin, Jie Ye, M. Mustafa Rafique, Franck Cappello, Bogdan Nicolae · 2026-10-22
当复用前缀超出 GPU 与主机内存,存储回读会阻塞推理。KVStream 把一步中的读取合并成池,将每块 KV 复制到各存储层,哪个层先读完就领取下一批;写入则推迟到前向计算期间。收益来自按完成进度分配读取,代价是额外副本与写带宽。
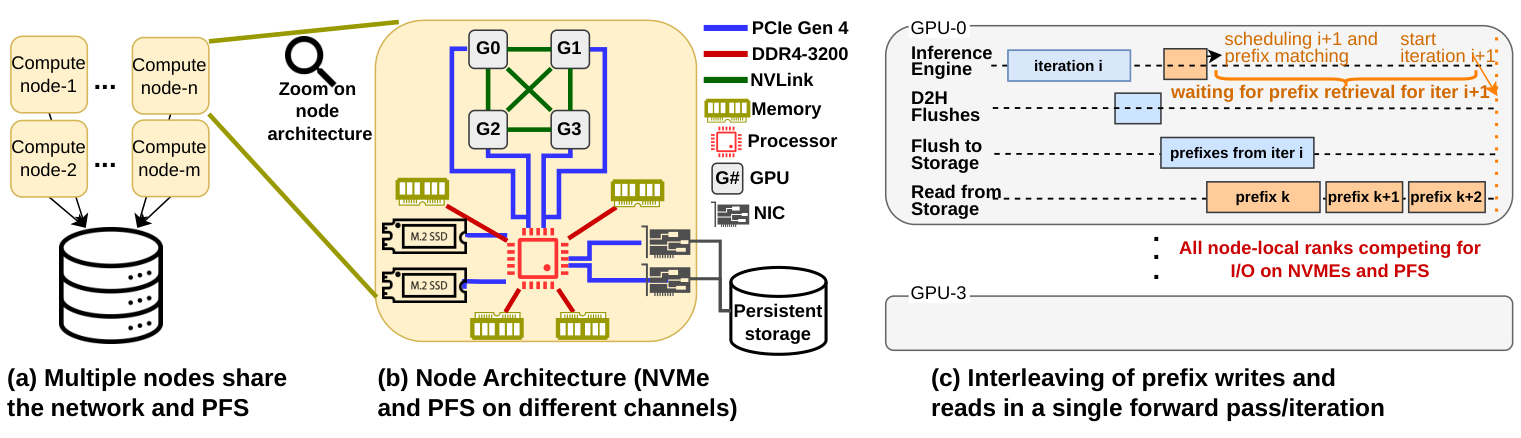
读图:左侧为共享文件系统,中间是节点内两条存储路径,右侧展示优化前读取和写入的竞争。
在四模型、六工作负载的评估中,单节点 H100 离线吞吐相对 LMCache 最高为 1.49 倍。单节点 A100 上的 SWE-bench Agent 请求流,在到达变异系数为 4 时平均首 token 延迟改善 6.07 倍,包含排队缩短的收益;不能把它理解为磁盘读取快了六倍。当前缀复用降至 4%,速度比只有 0.81,反而更慢。适用判断应先看缓存未命中量和读写比例:工作集留在内存,或新写入占主导时,多层复制很难获益。
社区与项目动态
AKV:缓存复用还必须匹配操作历史
AKV 的缓存操作历史与复用条件已在 10 月 22 日论文解读中展开,可与本期 KVStream 的存储回读机制对照阅读。
Resin:把调度与模型执行的责任分开
Resin 将请求、批处理与缓存所有权交给 Rust 核心,模型 runner 接收冻结的执行计划并负责权重与内核。值得注意的是故障边界:若执行可能已修改状态,系统隔离资源,不能因设备同步成功就假设可安全重试。这使运行时复用与可靠性契约成为同一设计问题。项目明确处于实验阶段,当前架构不支持多节点 serving 或 prefill/decode 分离;它适合作为研究基础设施观察,不据社交帖中的行数或图表宣称生产性能优势。