本期看点
发现一条编码智能体轨迹可能失败,不等于应该立刻重启:原来的执行可能稍后完成,而新执行只能使用剩余预算。两项研究从不同角度检查这一决策。一项比较同一任务的多次尝试,发现早期信号难以区分成功和失败;另一项提出决策价值与置信审计,说明准确率和实际重启收益之间还隔着什么。
继续还是重启:早期轨迹预测的边界
Continue or Restart? The Limits of Early Failure Prediction in Coding Agents
Srinath Srinivasan, Lunxiao Li, Tim Menzies, Wesley Assunção · 2026-10-26
编码智能体运行一段时间后,监控器可能想根据工具调用、文件编辑和测试记录判断它是否值得继续。但一个预测器可能只是识别了任务难度:它能把简单问题与困难问题区分开,却不能在同一个问题的多次尝试中识别哪次即将失败。只有后者才直接支撑对某次运行的选择性干预。
作者分析两个公开语料中的 147,002 条轨迹,覆盖四种模型与框架组合;分别测试计数特征、初始文本嵌入、针对任务训练的排序器以及微调的 Qwen3-0.6B 监控器。评估同时报告总体排序和同一任务内的成功、失败尝试排序。20k token 时,神经监控器在 32,406 次尝试上的三种随机种子结果,同任务 AUC 均值为 0.50,区间为 0.48–0.51:在该设置下接近随机排序,而不是证明所有可能的监控信号都无效。
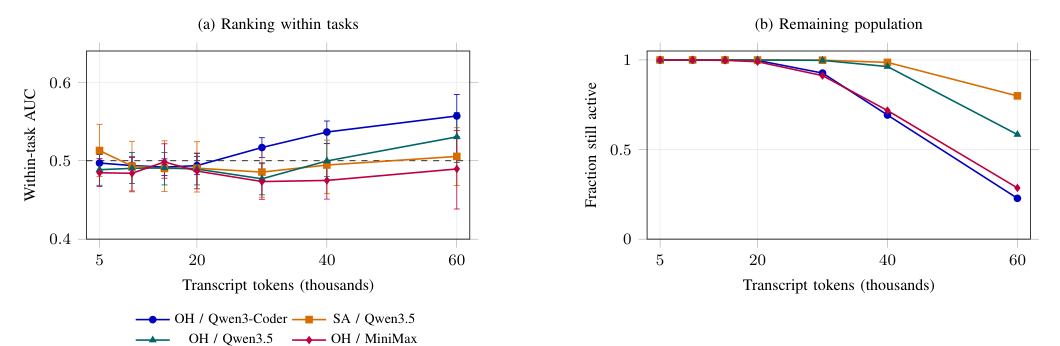
读图:左侧比较不同时间点的同任务排序能力;右侧显示到该时间点仍未结束的轨迹比例。越晚的判断所覆盖的运行越少。
接下来作者在共享 token 上限下回放策略:继续原尝试、按分数重启,或以相同停止比例随机重启。在 75k 上限下,学习型重启比随机重启最多高 1.98 个百分点;但分解显示收益主要来自跨任务的停止分配,即较少停止容易的问题,同一任务内部挑选尝试的贡献接近零。四种设置在 75k 上限下,以及全部 224 种预算与阈值组合中的 216 种,继续运行都比两种重启策略获得更高解决率且平均 token 成本更低。
这个负面结果提醒我们把预测能力、干预方式和预算一起评估。它针对记录轨迹的冷重启回放;保留已有编辑、使用更丰富的监控信号或其他工作负载,可能改变结论。阅读时尤其值得关注同任务评估和共享预算的策略比较,而不是只看总体 AUC。
监控准确率之外:衡量重启决策的价值
Monitor Accuracy Isn’t the Answer: A Decision-Value Framework for Evaluating AI Agent Restart Monitors
Siddharth Jain, Venkat N Vedam · 2026-10-27
这篇工作把问题向前推进一步:即使监控器准确,重启也未必有利。决策取决于原执行继续完成的机会,以及独立的新尝试能否在剩余预算内成功。作者给出一个数学对照:在独立干净重启、监控无额外开销等假设下,固定 90% 准确率,仅改变新尝试的成功概率,成功率变化就可从降低 5 个百分点变为提高 35 个百分点。这是分析例子,不是实际监控器的性能。
作者将轨迹压缩是否保留“继续或重启”的决策信息作为判断标准,并用同时二项置信区间构造审计:证据不足时可以弃权,而不是强行推荐动作。实证材料包括 SWE-bench Verified 中 19 个选定 SymPy 问题上的 194 次外部验证执行,其中 130 次用于回顾性审计。一个表面上 2.29 个百分点的重启收益来自单条仍在运行且最终失败的尝试;另一模型出现 42.29 个百分点的损失;103 个有存活轨迹的比较均未达到作者设定的认证门槛。
它与上一篇的共同点是将动作收益放在预测指标之前;不同之处是这里主要贡献决策恒等式和小样本、可弃权的审计,而非大规模训练失败预测器。样本局限于所选任务与运行配置,置信结论依赖独立性等假设;保留编辑的重启也不能直接套用干净重启的结果。原文没有适合解释核心机制的架构图,因此这里用文字呈现。