智能体故障修复不止要找到一条看似合理的替代动作,还要判断实际执行它的智能体能否从那里继续完成任务。另一篇工作把视角转向训练基础设施:当大量轨迹同时启动,沙箱的创建、状态和清理如何影响共享集群与训练节奏?
修复选择:让真正的执行者评价候选动作
原文: Repairs for Whom? Evaluator-Executor Mismatch in Selecting Repairs for Failed LLM Agents
作者: Yijun Liao, Fanwei Liang · 首发: 2026-10-28
修复失败轨迹时,常见做法是让更强模型、确定性重放或环境规划器为候选修复打分。但一个动作能否帮助后续执行,取决于执行者如何解读状态、采样以及使用剩余步数。评估者自己能够成功,不代表部署中的智能体也能沿同一路径成功。
作者固定失败轨迹和单步替换候选,让不同评估者选出修复,再用部署策略独立 rollout 衡量选择带来的净收益。净收益以替换原动作后的成功率减去原动作重新运行时的成功率;WebShop 使用奖励差。对照组使用部署者自身 rollout 选择,选择与最终评价使用分开的样本。这样既比较不同目标的偏差,也把使用较少样本造成的预算问题单独列出。
在未按修复价值预筛的 ALFWorld 与 WebShop 故障池上,相对于匹配执行者的选择,贪心重放分别损失 0.08–0.13 的预期净成功增益和 0.06–0.13 的净奖励。对 Qwen2.5-7B 的修复,使用 14B rollout 选择分别损失 0.25 和 0.07。数字是该实验中的选择损失,不代表所有强模型都更差。每个未筛选池各有 60 条失败轨迹;实验只替换一个动作,候选和可回放环境也受到实验设计约束。
这一结果提示,修复系统需要把模型、提示、历史协议和解码设置一起视作执行者,并用实际策略的后续表现验证选择;更强的代理可以帮助提出候选,但不能自动作为部署收益的替身。原文的实验设计和不同评估器比较适合用于设计干预验证。
Sandman:把突发的训练沙箱放进共享集群
原文: Sandman: Building and Operating Sandboxes for Agentic Reinforcement Learning on Shared Kubernetes
作者: Yiming Yan, Hongyang Wang, Wenbo Chen, Xuan Wang, Jingguo Liu, Xian Li, Chen Qi, Leo Fan, Siwei Li, Qianli Wu, Yichuan Li, Ruochen Wen, Qian Qu, Zheshen Wang, Benoit Dumoulin · 首发: 2026-10-29
智能体强化学习中的一次轨迹会反复调用工具,文件和进程必须在调用之间保留;训练又会成批发起环境请求。作者报告的一次突发达到每秒 132 次创建,而对应训练活动的平均速率为每秒 1.8 次。只按平均负载配置资源,容易忽略 Kubernetes 准入、调度和网络分配的瞬时压力。
Sandman 将每个沙箱作为普通 pod,向原任务镜像挂载小型守护进程。训练端获取沙箱后,交替进行模型推理和工具调用;结束后提取补丁,默认在独立、未使用过的评分 pod 中运行测试。provider 负责创建、节流、分散放置和删除;可选的 pool 可预热常用镜像。关键的生命周期细节是:即使调用方超时放弃,创建过程仍有明确的清理责任,避免遗留 pod 累积。
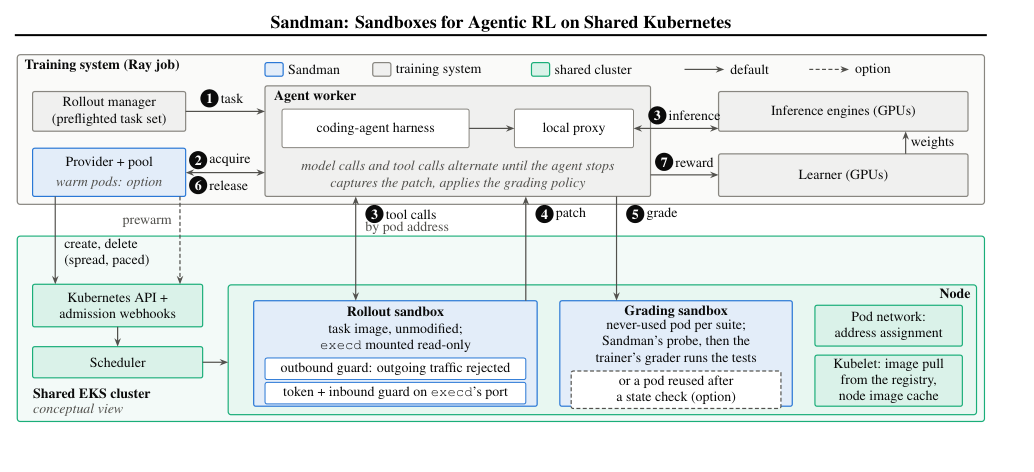
读图:训练端取得轨迹沙箱,模型与工具交替运行;补丁交给单独的评分沙箱,provider 管理 pod 生命周期。
作者在压力测试中维持了 11,858 个小型沙箱;四个内部 SWE-bench Verified 训练活动共创建约 313 万个沙箱。两者不是同一种负载:前者使用轻量 pod,不能视为真实任务镜像的容量承诺。预热可缩短获取时间,但空闲 pod 占用资源;论文还强调镜像拉取、网络地址分配和超时清理。其实验来自一个共享 EKS 集群,且部分机制晚于报告的生产活动。对 AgentOps 的启发是把创建尾延迟、泄漏回收和评分环境完整性一起纳入训练系统设计,而不只关注工具执行速度。