本期导读
25 篇论文、8 篇技术笔记。原文发表日期与本期阅读日期分别记录。
01 · LiquidCP: Decoupling Attention Tasks from Communication and Kernel Boundaries in Context Parallelism
LiquidCP: Decoupling Attention Tasks from Communication and Kernel Boundaries in Context Parallelism
Hongyu Chen、Yikang Ruan、Yuhai Long、Ziyu Huang、Yiyu Luo、Liukun Yu、Yangjie Zhou、Zihan Liu、Weihao Cui、Zijun Li、Anbang Wu、Yu Feng、Jing Yang、Jingwen Leng、Bingsheng He、Minyi Guo、Shixuan Sun
LiquidCP 将注意力拆成具有分块依赖的传输、计算和归约任务。MegaRing 平衡训练及预填充中的 token 与注意力负载,MegaDCP 根据后续归约规划历史 KV 切分,两者共用常驻 GPU 执行引擎。摘要报告八张 H100 上 Transformer 层加速 1.08–1.16 倍,带前缀缓存的 vLLM 平均首 token 延迟加速 1.22 倍;这些结果限于所测配置。
本简述依据原始摘要;未独立复现实验。
02 · Warpline:给 kernel agent 可查询、低扰动的性能证据
Warpline: Binary-Level Tracing and Unified Evidence for Agentic GPU Kernel Optimization
作者:Junyu Yin, Vinod Grover, Keren Zhou · 首次提交:2026-11-03
让代理写 GPU kernel 的困难,不只是生成合法代码,还包括判断下一轮应该改哪里。硬件 profiler 能说 tensor core 利用率下降,却未必能指出哪个 warp 的哪段工作导致下降;源码插桩则可能触发重新编译,改变寄存器分配和指令调度,让测量对象本身发生变化。Warpline 把二进制追踪、硬件计数器与程序结构放进同一条证据链。
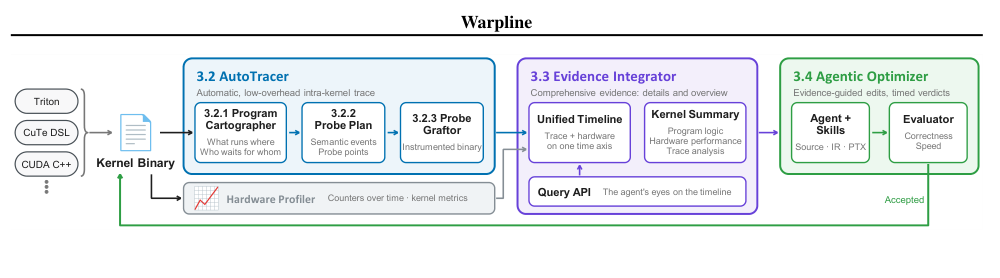
不同语言先汇入二进制接口;只有通过正确性与速度检查的候选才进入下一轮追踪。
输入是最终 kernel binary。AutoTracer 对 SASS 做静态与动态分析,识别 warp 分工、循环和 barrier 依赖,再自动选择语义事件与探针位置。探针直接插入二进制,不重新编译;通过合并记录、宽存储、选择空闲或已死寄存器,以及按 warp 配置缓冲区,压低观测开销。对动态捕获的信息,只有静态检查证明它只依赖 kernel 与启动配置时才复用。
硬件数据来自另一轮未插桩运行,因此还需要时间轴对齐。Evidence Integrator 将 warp 生命周期与 profiler 的 active-warp 序列拟合,再结合 barrier 关系形成摘要和查询 API。代理可以先读“谁在等谁”,再取对应时间段的事件验证假设。候选修改通过正确性检查和交错顺序计时后,才成为下一轮基线;证据随新 binary 重新生成,减少人工移动探针的工作。
在 NVIDIA B200 上,35 个 Triton、CuTe DSL 与 CUDA C++ kernel 的插桩开销中位数为 1.2%,原始执行指令保持编码与相对顺序的比例中位数为 99.9%。这是有限扰动,不是零扰动;每个 kernel 的离线分析与插桩还需 13–77 秒。另三个闭源库 kernel 也能追踪,说明 binary 接口确实绕开了源码可用性的限制。
优化实验对 10 个 SOL-ExecBench 问题给每种方法六轮、每轮最多 60 分钟。相对各自起始 kernel,Warpline、裸代理和 KDA 的几何平均加速分别为 7.69×、6.94×、6.13×;因此相对裸代理的额外收益约为 1.11×,不能写成 7.69×。Warpline 每轮平均 44 次模型请求,裸代理 54 次,KDA 含 reviewer 共 108 次。
性能门槛也明确考虑测量噪声:候选与父版本按 ABBA 顺序交错计时,预热后重复执行,每次先清理 L2,再比较批次中位数的几何平均。只有正确且改善超过父版本波动门槛的候选才接受。这个判定器与追踪接口同样关键,因为更丰富的解释不能替代可信的计时裁决。
一个案例说明证据整合为何重要:tensor core 利用率周期性下降看似加载不足,增加缓冲深度却无效;时间轴显示大量 CTA 同时进入 epilogue、集中写回,调整释放与写回节奏才改善延迟。另一个案例定位到源码里看不到的编译器插入 barrier。该工具目前验证于 sm_100a,跨架构仍是后续工作;有限输入上的正确性测试也不等于形式化证明。它的主要新意是让代理持续获得更接近原始执行的诊断证据,而不只是增加搜索轮数。
03 · ForgeKernel: Self-Evolving Kernels Catching and Surpassing Experts and Agents
ForgeKernel: Self-Evolving Kernels Catching and Surpassing Experts and Agents
Yaojian Chen、Dazhi Peng、Yiyun Zheng、Zhui Zhu、Shengye Xiang、Leshan Li、Zhen Li、Xianglong Deng、Haojun Sun、Qingfeng He、Shangzhan Li、Yifei Shen、Lin Gan、Yuxuan Li、Xu Han、Zhiyuan Liu
ForgeKernel 在优化轮次之间积累经过验证的硬件知识,并将通过正确性和性能检查的 kernel 作为下一轮参考,使后续搜索能够重新选择架构。摘要报告在 NVIDIA 的 29 个输入配置中,25 个达到或超过专家参考,几何平均性能提升 10%。Ascend 实验采用不同算子和基线,不能混算;排行榜名次也仅对应报告时点。
本简述依据原始摘要;未独立复现实验。
04 · ModelBlaster: Closing the Performance Gap through Learning-Augmented Agents Across Models, Kernels and Hardware Backends
ModelBlaster: Closing the Performance Gap through Learning-Augmented Agents Across Models, Kernels and Hardware Backends
Shengjun Kris Dong、Dima Nikiforov、Sahil Modi、Sana Damani、Edward C Lin、Siva Kumar Sastry Hari、Christos Kozyrakis
ModelBlaster 用推理阶段持续更新的知识库存储性能状态、优化动作、结果和约束,通过文本 actor–critic 更新支持 kernel 与整模型优化。统一循环覆盖 CUDA、OpenCL 和 RISC-V 向量目标,但各平台仍需专用代码生成、测量和正确性检查。文中性能收益对应不同基线和负载,不能视为跨硬件通用加速比。
本简述依据原始摘要;未独立复现实验。
05 · GC-MoE: Overlapping Expert-Parallel Token Dispatch with FP8/FP4 Grouped GEMM via CUDA Green Contexts
GC-MoE: Overlapping Expert-Parallel Token Dispatch with FP8/FP4 Grouped GEMM via CUDA Green Contexts
Yong Li、Kan Liu、Tao Lan
GC-MoE 通过 CUDA Green Contexts 分离 token 分发与 grouped GEMM 的 GPU 资源预算。token 环握手让计算在全部传输结束前启动,双缓冲计数器去掉重放末尾的跨 rank 屏障。摘要报告在 H20 与 B300 配置中、精度匹配条件下优于 Mega MoE;这是特定 MoE 算子的结果,并非所有模型端到端收益。
本简述依据原始摘要;未独立复现实验。
06 · BADC:投机解码的保证,依赖处理器看到正确的历史
Testing Processor Contracts in Speculative Decoding Engines
作者:Tianyu Ding, Yaocheng Tong, Muzhi Yang, Lei Yang, Fei Jiang · 首次提交:2026-11-02
投机解码通常被描述为“不改变目标分布的加速”,但这个保证并不只取决于接受/拒绝公式。实际引擎还会施加最短长度、重复惩罚、语法约束和引导等 logits processor。如果模型按正确前缀算出了 logits,处理器却读到尚未确认的草稿,最终采样的分布仍可能改变。这篇工作的价值在于把算法保证落到了组件接口,而非仅比较两次输出是否相同。
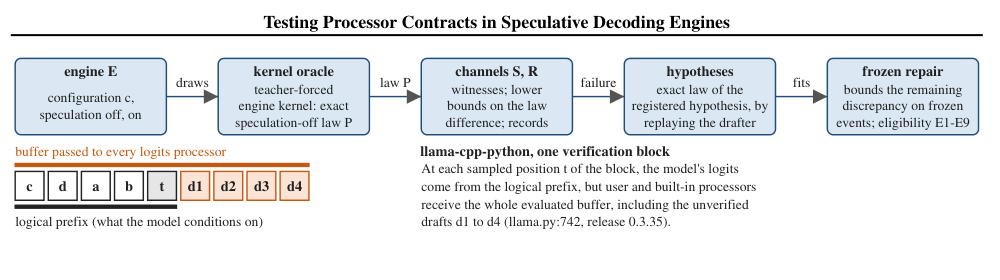
上方从引擎采样走向机制假设与干预确认;下方橙色草稿说明物理缓冲区为何不等于当前逻辑前缀。
作者定义了 processor-prefix contract:每个验证位置的处理器必须看到该位置的逻辑前缀;有状态处理器还要处于与顺序解码等价的状态。草稿被拒绝后,只回退模型 KV cache 并不能自动回退处理器。llama-cpp-python 的一个具体案例是回调收到包含未验证草稿的整个缓冲区,让最短长度处理器误以为已生成足够多 token,提前释放结束符限制。Transformers 的另一类问题则来自候选处理提前推进了状态,随后没有恢复。
BADC 把这两个层次分开测试。在词表仅 7–10 个 token、生成长度 3–4 的随机小模型上,枚举顺序解码作为参考,再对开启和关闭投机的引擎采样。它既检查违反明确约束的输出,也为预先固定的输出事件构造同时置信界。随后把疑似原因写成可执行假设,冻结最小干预,再用新样本检查干预后差异是否缩小。这种流程把“观察到不同”推进到有源代码位置和干预支持的机制解释。
主研究覆盖 5 个固定构建、26 种配置,包括 Transformers 5.17.0 与 llama-cpp-python 0.3.19/0.3.35,最终确认两类原因。训练过的 SmolLM2-135M-Instruct 后续实验中,作者在一个预先选定的提示上,每组重新采集 1,024 次请求:某个固定首 token 事件的概率,在普通解码与原生 prompt lookup 下分别为 80.37% 和 14.16%。在组内独立同分布假设下,名义同时 95% 置信界给出的差距下界为 60.26 个百分点。这个数字描述特定提示、检查点、处理器与事件,不是生产请求的错误发生率。
同样值得关注的是负面结果:定向挑选配置没有显示出比随机选择更强的原因恢复能力,置换检验在各受测家族中至少同样容易检测出差异。作者没有证明 BADC 的检测优越性;它提供的是契约、事件界与干预证据。历史 vLLM 测试也不能推出当前版本仍有同样缺陷。
实验还专门检查投机路径是否真的执行:某个参数组合没有提出任何草稿,因此标记为无法判定,而不是正确性通过。类似地,有限事件上没有拒绝分布相同的假设,也不等于证明整个引擎符合契约。这样的非结论记录,对回归测试同样重要。
对于推理可靠性,最可迁移的启示是将前缀视图、处理器状态、停止规则和概率记录一起纳入验证。阅读原文时,优先看契约定义、两种源代码机制和修复确认条件;它们比单个巨大差距更能帮助判断一个加速路径是否保留了原本承诺的语义。
07 · ROCm InferaSim: Cut LLM Serving Trial Costs and Deploy the Best Configuration
ROCm InferaSim: Cut LLM Serving Trial Costs and Deploy the Best Configuration
Anshu Raina、Yao Fu、Zhang Jiejing、Peyman Razaghi、Shiksha Patel、Ravi Gupta、Deval Shah、Adeem Jassani、Subhajit Dutta Chowdhury、Lorri Rao、Kailash Gogineni、Zhenyu Gu、Onil Gunawardana、Emad Barsoum
ROCm InferaSim 对代表性 kernel 集合测量一次,再用解析规律将这些锚点迁移到相关服务配置,结合流量回放和搜索筛选部署方案。摘要报告 11 个锚点耗费 9.1 GPU 小时,而直接测量 226 个配置需 204 GPU 小时;172 个配置的输出 token 时间中位误差为 8.1%。节约依赖共享 kernel 行为与校准,最终候选仍需实测。
本简述依据原始摘要;未独立复现实验。
08 · Beyond Compression Ratio: High-Throughput KV Compression for Disaggregated LLM Serving
Beyond Compression Ratio: High-Throughput KV Compression for Disaggregated LLM Serving
Junhong Wu、Zedong Liu、Xinyang Ma、Yuhan Chen、Guangming Tan、Dingwen Tao
该工作关注 KV 压缩流水线的执行成本,而不只看压缩率。它融合分布变换与低比特量化以避免中间张量,并采用可搜索、可扩展的无损压缩后端。摘要报告所测负载任务完成时间最高加速 2.04 倍。kernel 与后端峰值速率属于不同指标;网络越快,压缩本身的开销越不能忽略。
本简述依据原始摘要;未独立复现实验。
09 · LeanSparse: Memory-Efficient Serving for Native Sparse-Attention LLMs
LeanSparse: Memory-Efficient Serving for Native Sparse-Attention LLMs
Zaifeng Pan、Chris Wu、Xinwei Qiang、Zhengding Hu、Zhongkai Yu、Yufei Ding
LeanSparse 同时减少预填充临时空间和解码常驻状态:逐层历史数据通过两个 GPU 缓冲区流入,解码先在紧凑表示中粗筛,再取原始索引键细化,并分开缓存索引键和 KV。摘要报告 SGLang 上 DeepSeek-V4-Flash 的 950K 上下文测试相对 HiSparse 支持 2.95 倍并发、2.14 倍解码吞吐。多轮任务另以 ECHO 为基线,不能将两组结果混合。
本简述依据原始摘要;未独立复现实验。
10 · Silent Degradation during Auto-Vectorization of bf16/fp16 on RISC-V Under LLVM
Silent Degradation during Auto-Vectorization of bf16/fp16 on RISC-V Under LLVM
Vaishnavi Kouru、Robert Chun
该研究比较 RISC-V 上 LLVM 对 fp32、int8、bf16 和 fp16 乘加循环的自动向量化。缺少相关目标扩展时,低精度浮点会退化为标量运算或软件转换。QEMU 中 bf16、fp16 的动态指令数分别是启用扩展版本的 17.0、75.9 倍。这是仿真指令数量,不是实机延迟;诊断文字也未清晰区分可由编译参数解决的限制与固有转换成本。
本简述依据原始摘要;未独立复现实验。
11 · An Investigation on Numerical Bugs in GPU Programs Towards Automated Bug Detection
An Investigation on Numerical Bugs in GPU Programs Towards Automated Bug Detection
Ravishka Rathnasuriya、Nidhi Majoju、Zihe Song、Wei Yang
作者对 397 个 GPU 数值缺陷的根因、症状、触发输入、测试判据和修复方式进行分类。初步工具 GPU-NBDetect 覆盖六类缺陷,报告在四个库的 186 个数学函数中检测到 226 个问题,其中 60 个获开发者确认。检测报告数与确认数必须区分;该研究支持有针对性的数值测试,不代表完整缺陷覆盖。
本简述依据原始摘要;未独立复现实验。
12 · Look Before You Launch: Learned Throughput Prediction for Hardware Selection in a Production Training Fleet
Look Before You Launch: Learned Throughput Prediction for Hardware Selection in a Production Training Fleet
Hossein Askari、Wei Sun、Chenguang Zhu、Bin Zan、Sreen Tallam、Keyu Man
LEAP 根据提交时配置及任务历史吞吐预测训练性能,再按单位成本吞吐排序硬件。生产报告覆盖数百种模型与二十多种硬件,估算计算成本节约约 3%。摘要中的 77% 准确率采用论文自己的预测判据,并非通用硬件选择成功率,也不能保证未见负载的效果。
本简述依据原始摘要;未独立复现实验。
13 · TapeSAC: Automated, Pareto-Optimal Fine-Grained Memory Management for Large Model Training
TapeSAC: Automated, Pareto-Optimal Fine-Grained Memory Management for Large Model Training
Kaihui Ren、Yifan Zhao、Zejian Wang、Yingtong Xiong、Xiaoling Zhou、Daohong Xu、Chenhao Guan、Zhikang Mo、Jihu Guo、Zhuoru Ma、Yufeng Li、Lin Zhang、Yiqiao Liao、Chengru Song
TapeSAC 在 PyTorch dispatcher 记录前向操作,反向时仅重放所需值的生产操作;规划器根据实测重计算成本和峰值内存预算选择保存张量。摘要报告真实数据上 500 步训练时间减少 8–11%;另一个 397B 模型比较中运行快 2.7%、内存少 14%。收益取决于 kernel、batch 大小和原检查点策略。
本简述依据原始摘要;未独立复现实验。
14 · Near-Zero Token Embeddings Silently Stall Training in Gated Sequence Models
Near-Zero Token Embeddings Silently Stall Training in Gated Sequence Models
Xin Liu、Boyuan Sun、Yuxin Wang、Haoran Song、Mingjian Zhao、Mengyu Liu
接近零的非共享输入嵌入可能抑制门控模型读出,经多层归一化放大梯度,使 FP32 全局范数裁剪溢出并清零一次更新。论文区分检查点调查与 Telugu 持续预训练实验,后者约 20% 步骤丢失更新。GroupClip 改造已发布模型的裁剪过程,GateFloor 则改变预训练门函数;两者针对特定故障链,不能解决所有训练不稳定。
本简述依据原始摘要;未独立复现实验。
15 · INSIGHT-HPC:结合负载与物理一致性解释异常
INSIGHT-HPC: An Interpretable System Intelligence for Global HPC Telemetry
作者:Rupak Kadel, Jie Li, Yong Chen · 首次提交:2026-11-02
INSIGHT-HPC 将 BMC、Slurm 与 PDU 遥测按节点和分钟对齐,融合统计异常、作业分段与同伴比较、功耗/温度残差及物理约束,再以监督式梯度提升模型输出事件级告警。负载启动造成的功耗上升因此有机会被解释为正常,而非直接升级成故障。
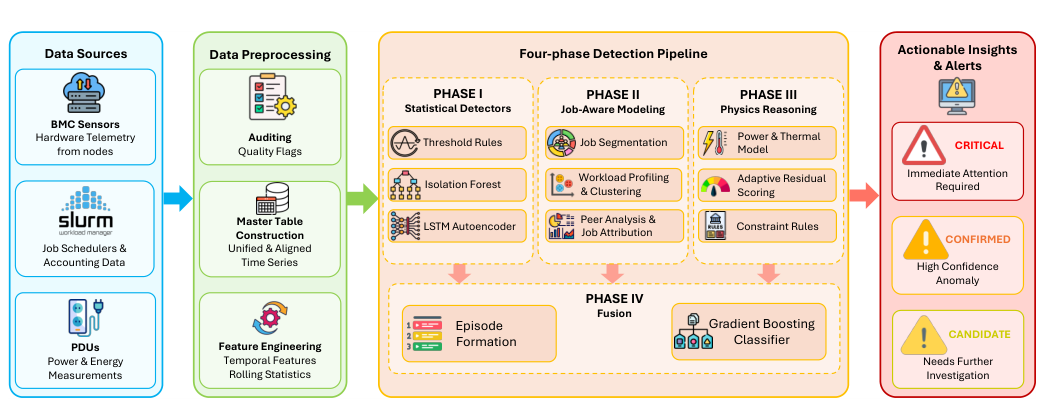
前三路产生互补证据,最后按事件融合;告警等级来自验证集选定阈值。
作者回放 118 个计算节点的 79 天遥测,按时间划分训练、验证与测试。测试含 29 个运维记录故障和 140 个注入事件,主阈值下 precision 为 0.913、F1 为 0.862,独立报告的事件召回率为 0.805。这里是回顾性检测,并非已验证的实时预警;分类特征使用完整事件,主要结果也混合了真实与注入故障。不同方法的 AUROC 候选池不同,不能直接横比。可迁移价值在于把“异常但符合工作负载”与“违背物理或跨层关系”作为不同证据送入告警融合。
16 · RAGLog:答案正确,也可能需要定位上游故障
From Logs to Faults: Reference-Free Fault Localization for Retrieval-Augmented Generation Pipelines
作者:Hira Naveed, Scott Barnett, Stefanus Kurniawan, John Grundy, Chetan Arora, Hourieh Khalajzadeh, Omar Haggag · 首次提交:2026-11-01
RAG 的最终答案并不是完整的健康信号:检索器漏掉关键材料,生成器仍可能凭已有知识答对;重排器把证据移出上下文,表面上却像是生成器不会回答。RAGLog 因此把检测单位从答案改成管线阶段,用执行日志定位改写、嵌入、检索、重排和生成中的问题。它不要求线上请求自带参考答案,也不要求修改应用源码,但需要足够完整的调用输入与输出。
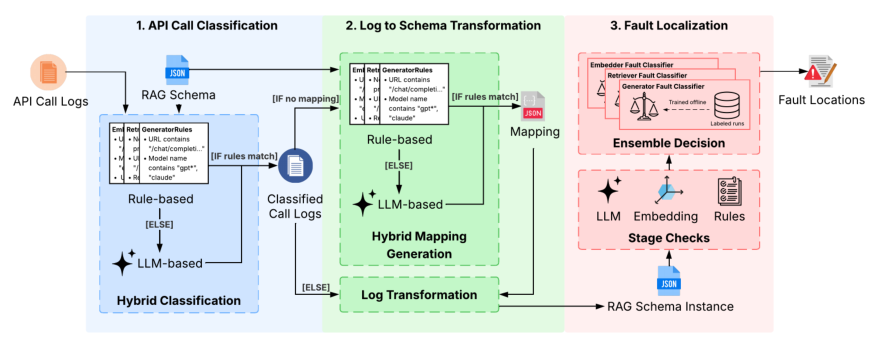
从左向右先统一日志,再组合规则、嵌入与 LLM 检查;最右侧分类器依赖离线标注训练。
方法首先解决日志格式。已知 API 用规则判别阶段,陌生格式由 LLM 补充;随后生成一次可复用的字段映射,把异构日志转成共同的 RAG schema。在这个结构上,规则检查实体、数字和日期是否丢失,嵌入相似度衡量查询漂移,五类并行 LLM 检查判断信息是否被检索、是否被重排丢弃,以及答案是否真正使用了证据。阶段分类器再融合这些信号,而不是把一次自由式 LLM 诊断当最终结论。
一个关键区别是“无需参考答案”不等于“无需标注”。在线分析只读取轨迹,离线的各阶段分类器和阈值仍由带阶段标签的运行记录训练。数据集共有 3,134 次运行;主要测试分为五条开源管线、三个问答数据集上的 1,500 次自然运行与 480 次注入运行。注入通过代理修改真实调用,让后续阶段正常响应扰动,而不是事后给日志贴一个故障标签。
使用 Claude Haiku 5.5 时,RAGLog 在自然运行上的阶段级 pooled F1 为 0.73,Claude Code 和 Codex 分别为 0.58、0.52;注入运行则是 0.84、0.80、0.82,差距小得多。自然测试中 551 次运行含故障,其中 202 次仍答对,说明只看最终答案会遗漏相当一部分阶段问题。作者报告 Haiku 版本每次约 0.005 美元、约 4.6–4.7 秒,五类检查并行是控制延迟的主要原因。
收益有明确代价。按整次运行判断,RAGLog 的假阳性率为 13.6%,高于两种代理基线的 5.4% 和 4.0%;留出整条未见管线时,自然运行 pooled F1 从 0.73 降至 0.67。标签主要由 LLM 裁判产生,测试标签没有独立人工验证。当前方案也不支持动态重复阶段的 agentic RAG,不能直接推广到任意工具调用图。
消融也帮助定位增益来源:移除 LLM 检查对自然故障的影响最大;移除证据流检查的影响较小,但在自然与注入两组都显著。并非每个附加分类器或跨阶段特征都显示统计显著收益,因此不能把复杂组件数量当成必要性的证明。
对 AIOps 更有意义的部分,是把“扰动已注入”“阶段确实出错”“最终答案失败”拆开。许多注入会被下游吸收,自动把所有注入样本算成故障反而会污染评测。建议重点读证据流检查和注入后的阶段标注:它们为生成式系统的故障定位提供了比整体成功率更细的观测对象,也清楚暴露了误报与标签质量这两个部署成本。
17 · Signals:把跨运行的问题归成可处理的工程事项
Signals: Continuous Diagnostics of AI Agents
作者:Amey Rambatla, Vatsal Goel, Sagar Gaur, Siddhant Loya, Anurag Mishra, Asif Mohammad · 首次提交:2026-11-03
Signals 面向工具与基础设施正常、代理却决策错误或浪费资源的情况。它用八个家族、45 种问题定义检查轨迹,将单次出现的问题归并为工程事项,并分别记录已发生缺陷、可达风险和额外开销,附上证据、严重性与修复验证建议。相同标签并不自动表示相同根因。
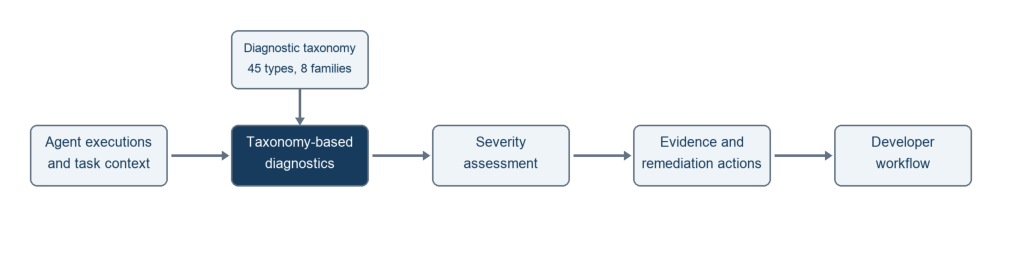
分类体系约束诊断,再把证据和建议交给开发流程;修复效果仍需后续验证。
在公开基准轨迹上,使用 GPT-6.1 Sol 的流程获得 91.43% Signal 匹配 F1,同模型、同分类体系的一次生成基线为 73.69%。但匹配依据是组件和问题类型,不验证描述、证据跨度、严重性或修复是否有效;参考标签由 LLM 在人工监督下建立。相较 RAGLog 的阶段判定,它强调跨运行的问题管理。值得读其证据边界与聚合单位,避免把工具拒绝、长轨迹或缺失遥测本身误当成已发生故障。
18 · 评测仪器审计:13 个百分点的差距,可能来自评分器没运行
Silent Instrument Errors Reorder Agent Leaderboards
作者:Yangze Liu · 首次提交:2026-11-03
排行榜分数往往被当成模型与 harness 能力的直接证据。这篇审计把注意力转向生成分数的基础设施:什么时候触发评分、哪些调用计入费用、轨迹是谁写的,以及旧轨迹能否由新版本正确回放。作者从 HAL 与 tau2-bench 的公开产物重新计算结果,没有重新运行代理,却发现四种会产生合理数字的测量错误。
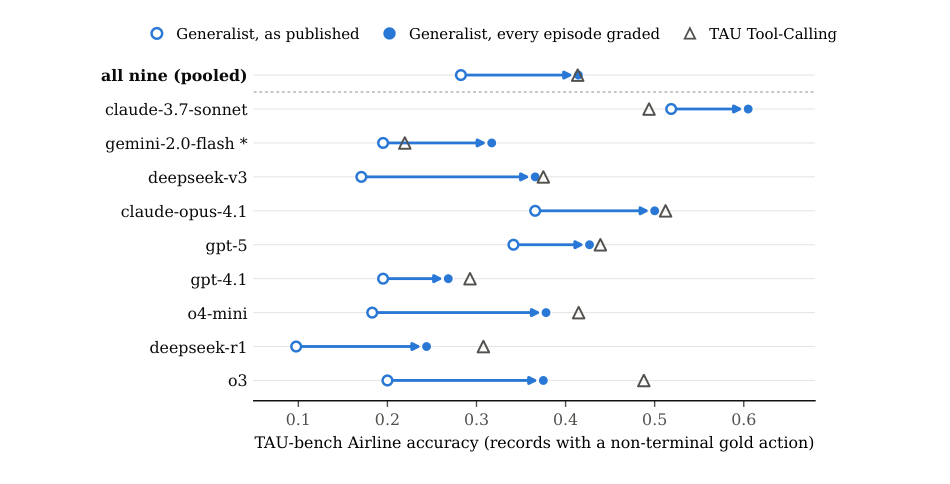
箭头表示使用同一奖励规则补评后的变化;顶部汇总行与三角标记重合,不表示每个模型的比较都反转。
最直观的例子来自 HAL 的航空客服任务。Generalist 按自己的循环结束对话,但不一定触发基准所期待的终止事件;未触发评分的记录随后被保存为失败。Tool-Calling 的评分覆盖率为 98%,Generalist 仅为 51%。作者使用固定环境和原有奖励规则,给那些未评分的记录补做评分后,九个模型合并、涉及非终止参考动作的 41 个任务上,Generalist 准确率从 0.30 升到 0.43,原先落后 13 个百分点的差距消失。
这不意味着所有模型之间都反转,也不等于代理无需行动就算完成。涉及真实数据库写入的任务上,Generalist 从 0.28 升到 0.33;23 条补评后成功的记录确实包含所需写入。两个 scaffold 的提示位置与步骤预算仍不同,修正后的比较只是消除了“一个评分、另一个不评分”的混杂因素。
另外两处问题与可观测性管线直接相关。费用聚合同时累加包装层和底层客户端 span,把同一次响应算了两遍,而且不同客户端路径受影响程度不一。轨迹存档则混入评分器为构造参考状态而执行的标准动作:2,334 条航空记录中,68% 含这类动作,有些还在轨迹中间,不能简单剪掉尾部。这样的日志若用于行为分析或训练,会把评分器的工作误认为代理能力。
第四类是版本化回放。一次公开说明过的评分修复仍然会重排榜单;另一条 telecom 回放路径误判 solo 模式,缺少用户侧工具,连续收到工具不存在的结果后仍输出一个分数,四份文件下降 59–82 个百分点。作者把正常修订标准与实现错误分开,强调重新评分本身就是一次新的测量。
修复代码之后,历史数字和下载出去的轨迹仍会继续流通。HAL 维护者确认三项问题并增加说明,但存档保持不变。论文因此建议把机器可读勘误附在数据集内部,让离开排行榜网页的副本仍能携带错误范围与修正规则。
这项研究没有估计所有榜单的错误比例,HAL 的补评也只覆盖数据库和输出标准。它提供的是可落地的仪器检查:公布实际评分比例;按根 span 或响应 ID 去重费用;给代理、用户模拟器与评分器动作标明来源;固定 evaluator 与任务版本,并展示逐任务重评分差异。做 AgentOps 时,值得先确认这些测量链路,再用几个百分点的分差决定换模型或换架构。
19 · ATC: Agent Trajectory Control for Role-Contract Enforcement in Black-Box Multi-Agent Systems
ATC: Agent Trajectory Control for Role-Contract Enforcement in Black-Box Multi-Agent Systems
Maisha Maliha、Vishal Pramanik、Sumit Kumar Jha
ATC 将角色漂移定义为违反显式角色契约。在消息进入多智能体共享对话前,它评估越权功能和言语行为,约束重新生成并复查修订。摘要报告所测团队的任务表现与角色一致性改善。消息层治理本身不能替代外部工具权限控制,也不构成语义正确性证明。
本简述依据原始摘要;未独立复现实验。
20 · Beyond Division of Labor: How Roles Shape Feedback and Recovery in Multi-Agent Systems
Beyond Division of Labor: How Roles Shape Feedback and Recovery in Multi-Agent Systems
Chih-Hsuan Yang、Xinyang Li、Rajeev Thakur、Feng Yan
这项控制角色提示的比较发现,审查者审批可能减少提交次数,从而减少纠错反馈。所测设置中去掉角色未降低首次准确率;匹配反馈次数后,恢复差异明显缩小。在 400 题干预中,保留角色但强制每轮提交使恢复率从 0.198 提升到 0.613。结论依赖可靠外部反馈,不能推广为所有系统都应取消分工。
本简述依据原始摘要;未独立复现实验。
21 · Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training
Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training
Kangning Zhang、Wenxiang Jiao、Bowen Fang、Shuai Shao、Jiachen Zhu、Rong Shan、Shijian Wang、Hao Wang、Yuan Lu、Weiwen Liu、Weinan Zhang
Harness-S 构建固定的互补 harness 池。当基础 harness 的尝试全部失败时,选择兄弟版本生成替代轨迹用于策略训练,并随策略变化更新路由画像。训练后在原始 harness 下通过 AppWorld、SWE-Gym 和 DBBench 评估。路由带来的额外收益与策略学到的能力应分开;相同执行轨迹数不代表总路由成本相同。
本简述依据原始摘要;未独立复现实验。
22 · Meta$^2$: Precomputing Reusable Knowledge for Online Harness Evolution in Long-Horizon Agents
Meta$^2$: Precomputing Reusable Knowledge for Online Harness Evolution in Long-Horizon Agents
Lingzhi Yuan、Yiguang Cai、Weize Liu、Siqi Yang、Feijiang Han、Yongkyun Lee、Udari Madhushani Sehwag、Furong Huang
Meta² 对比有无演化器、以及仅训练时可用的特权反馈下的轨迹,学习何时保留或修改 harness 的可复用指导。测试时冻结指导,结合当前轨迹进行任务内修改而不重置进度。摘要报告 GPT-5.6-Terra 上 Terminal-Bench 2.1 为 81.00%、DeepSWE 1.1 为 44.44%;结果限于所测设置,演化器在测试时不访问验证器反馈。
本简述依据原始摘要;未独立复现实验。
23 · Interpretable Early Termination of Web Navigation Agents via Closed Sequential Pattern Mining
Interpretable Early Termination of Web Navigation Agents via Closed Sequential Pattern Mining
Sergio Talavera、Magdalini Eirinaki
该方法从网页智能体轨迹中挖掘闭合序列模式,形成可解释的早期失败信号。三个开源权重模型的 1,544 条 MiniWoB++ 轨迹中,所报告策略在 92% 精确率下节约 26.3% token。评估剔除零步崩溃和易分离的成功轨迹以减少长度伪信号。提前终止仍可能误删可恢复运行,基准结果不等于生产节约。
本简述依据原始摘要;未独立复现实验。
24 · Formalizing PTX in Lean to Prove GPU Kernel Correctness
Formalizing PTX in Lean to Prove GPU Kernel Correctness
Luk Koska、Tom Koska、Ben Koska
该工作在 Lean 中形式化 PTX 的同步、异步操作、tensor core 和多 kernel 流水线等行为,并证明简单 WGMMA GEMM、FlashAttention 与三 kernel MoE 实现。摘要给出的是具体证明案例,不是完整 PTX 覆盖或任意 GPU 程序正确性;模型与硬件行为的一致性仍是独立前提。
本简述依据原始摘要;未独立复现实验。
25 · Proving the Wrong Program: Miscompilations as a Threat to zkVM Guarantees
Proving the Wrong Program: Miscompilations as a Threat to zkVM Guarantees
Hui Xuan Tan、Stefanos Chaliasos、Alastair F. Donaldson
zkVM 证明的是编译后二进制执行,编译器误编译仍可能破坏它与已验证源码的对应。研究收集 88 个带复现程序的 Rust/LLVM 缺陷,其中在 SP1、Jolt 上分别有 48、46 个导致提交错误输出。所测现有 guest 大多未偶然受影响,但保持源码语义的刻意补丁可触发已知缺陷。结论区分编译器信任与证明系统正确性,并非所有 guest 都有漏洞。
本简述依据原始摘要;未独立复现实验。