投机解码先让便宜的草稿模型提出多个 token,再由目标模型验证。草稿越长,一次可能前进越多,但被拒绝位置后面的验证也可能白做。vLLM 的 Adaptive Verification(AV)据接受概率裁掉不值得验证的尾部;本次变化是,让没有专用置信度头的现有草稿模型也能获得这种预算控制。
原文:Adaptive Verification Without a Confidence Head
Giancarlo Delfin(Inferact)· 发布:2026-10-14
从草稿自信到目标接受,中间缺了一层校准
原有 AV 使用 DSpark 的置信度头:一个从隐藏状态预测目标是否接受的分类器。EAGLE、MTP、DFlash 及部分 DSpark checkpoint 没有这个头,补上通常要重新训练。新方案从草稿分布直接取特征,用正常验证已经产生的接受/拒绝标签,在线拟合极小的逻辑回归。
草稿认为自己的答案概率高,并不保证目标模型同意。二者的关系还受模型组合、采样参数与内容分布影响。AV 不仅要把候选按好坏排序,还要把预计接受数量与测得的草拟、验证成本比较,选择单位时间收益较高的验证预算。因此,一个排序不错却普遍过度自信的分数,仍会导致预算过大。
一个共享斜率,加上每个位置的偏置
估计器采用草稿分布最大概率的 log-odds,而不是实际抽到那个 token 的概率。对第 i 个位置,关系可写为:
这里的估计量是接受概率,斜率在各位置共享,截距随位置变化;K 个草稿位置只需 K+1 个参数。越深的位置通常越难被接受,位置偏置可以吸收这种差异。AV 再计算沿草稿前缀的存活概率,而非假定后面的 token 能绕过前面拒绝的位置独立留下。
选特征时最关键的约束是采样正确性。若按实际采样 token 的概率决定是否验证,留下来的候选就不再服从原来的草稿分布,标准拒绝采样所依赖的条件被改变。作者试过这类特征,虽然 AUC 更高,仍因会引入偏差而放弃。使用分布最大概率可以避免这一特定选择偏差;吞吐优化仍需服从原有投机采样协议。
在线拟合并不保存所有历史样本
只有验证到第一次拒绝为止的 token 才有可用标签;拒绝后的草稿不能擅自标成负例。系统在固定轮次内累计梯度与 Hessian,用 IRLS 更新参数,而不是保存所有原始记录。累计空间约为 K 的平方,避免随轮次长度和 batch 大小一起增长。
深层位置很少获得标签,容易被少量数据带偏。共享斜率减少自由度;每个系数的更新再按有效样本数缩放,证据少时步子更小。这使拟合能跟随流量,又不把每一次稀疏反馈都放大成剧烈变化。它也解释了为什么“在线”不等于每条请求都重新训练一个模型。
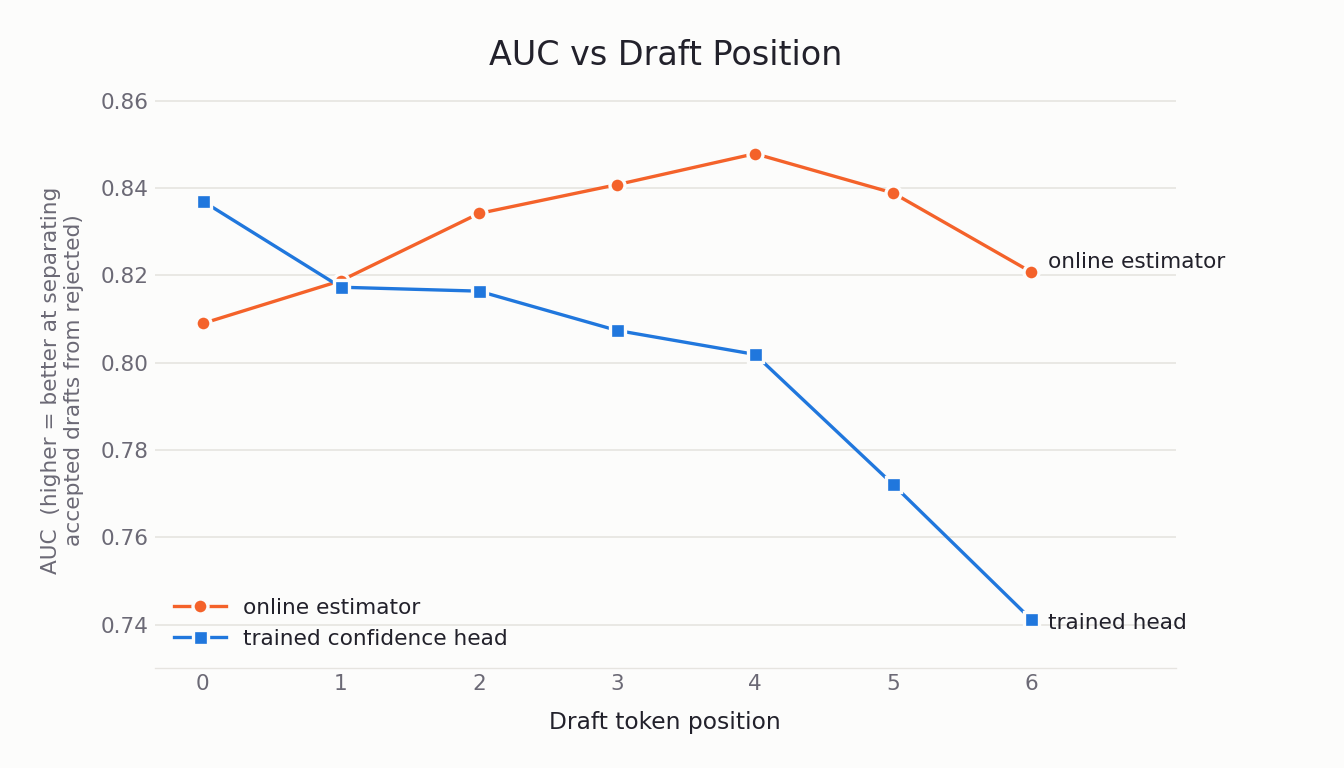
横轴为从零编号的七个草稿位置;橙色在线估计器从位置一开始领先蓝色置信度头,但 AUC 优势不等于校准或吞吐全面领先。
指标改善与服务提速要分开看
作者用 DeepSeek-V4-Flash + DSpark,在 temperature=1、top-p=0.95、并发 64、关闭 AV 的条件下收集约 450 万个带标签草稿,来自 SPEED-Bench 的低/高熵任务、GSM8K、HumanEval 和 MT-Bench。拟合后特征的 AUC 为 0.8336、log-loss 为 0.4284、ECE 为 0.0100;直接拿最大概率作接受率时,ECE 为 0.0736。后者平均预测 0.784,实际接受率为 0.723,展示了校准的必要性。
专用置信度头的 AUC 为 0.8191,但 ECE 为 0.0052,仍好于在线估计器。因而结论不是全面取代置信度头,而是提供可直接用于缺头模型的替代路径。按位置看,头在第一个位置占优,估计器从第二个开始占优;图中第五个位置之后二者都下降,作者将其与该 DSpark 训练块长为五联系起来。
服务实验覆盖 MiMo-V2.5-Pro-FP4 + DFlash、Inkling-NVFP4 + MTP、Muse-Glimmer-30B + DFlash2,以及 DSpark 的两类评分方式。在相同草稿长度下,在线 AV 对所测数据集均改善吞吐;但若允许固定方案重新挑选更短长度,比较就更严格。MiMo 的吞吐/交互性曲线中,AV 在七个并发设置中的五个处于前沿,说明它减少手工选择长度的压力,而非对所有并发都占优。
一个反例说明为什么不能只追求预测更准
原文用两个 token 的例子解释偏差。假设目标对 a、b 各给一半概率,草稿给 a 两成、b 八成;若抽到低于一半概率的 token 就取消验证,抽到 a 时改由目标重新采样,抽到 b 时则走通常的接受/拒绝过程。最后输出 a、b 的概率变成四成和六成,已经偏离目标。这说明看似合理的“低置信样本直接不要”,会改变抽样过程本身。
这里应区分两个问题:预测器能否区分会接受与会拒绝的草稿,以及使用预测器的决策是否保留正确分布。更高 AUC 只回答前一个问题。选择分布级特征,是把可使用的信息限制在不依赖当前抽样结果的范围内,再在这个约束下优化预测质量。
服务侧还有一个类似区分:预算控制要估计产出,也要估计花费。即使接受率完全准确,目标验证成本随 batch 变化,草拟成本也未必能被裁剪收回。控制器利用测得的成本表选择预算,正是把概率预测放进资源决策的原因。对工程读者而言,更有意义的观察是工作负载变化后,校准和成本估计是否一起跟上,而不是只在静态样本上追一个最好分数。原文跨数据集的斜率和截距分析提示两者承担不同角色,但还不能证明任何突发流量下都能立刻收敛。
适用边界与工程判断
目标模型的注意力后端必须支持变长验证。MTP、EAGLE 这类自回归草拟器生成将被裁掉的 token 已经花了较多成本,因此收益通常小于 DFlash、DSpark。高 batch、GPU 更接近计算瓶颈的场景,更有机会通过减少无效验证得益。
功能通过 enable_adaptive_verification 开启;无置信度头且满足后端条件时自动选择估计器。实际判断应同时看校准误差、吞吐和交互延迟,并与多个固定草稿长度比较。本文最值得读的是特征为何不能依赖采样结果,以及如何从自然产生的反馈学习预算:它把优化从“草稿多长”推进到“当前哪些验证计算值得做”,同时保留明确的采样约束。