Agent 没有报错,也可能正在批量抓取数据、越过权限边界或反复消耗资源。Google Cloud 的 Agent Anomaly Detection 把监控对象从响应状态扩展到会话里的工具调用与执行行为:先筛出异常,再异步推理其含义。10 月 22 日的预览更新将运行位置扩展到 GKE 与 Cloud Run,使这一审计路径更贴近实际部署。
原文:Agent Anomaly Detection overview · Google Cloud 文档,2026-10-22 功能更新
首发公告:Agent Anomaly Detection, now in Private Preview on the Gemini Enterprise Agent Platform · Achuth Narayan Rajagopal · 2026-09-16
为什么传统错误指标看不到这些行为
一个库存查询工具可以完全按 API 规范返回数据,但用户不断放大分页、跳转偏移量,最终可能导出整个目录。从单次调用看,参数合法、返回成功;从会话看,却出现了与正常浏览不同的使用模式。工具级成功与业务层可接受行为之间,正是这项功能试图观察的空间。
服务读取 OpenTelemetry traces 和日志,将会话中的推理记录、工具交互和执行流程作为分析输入。默认关注工具误用、身份和权限滥用、级联故障、偏离角色的行为,以及资源耗尽。这些类别让安全团队能把 Agent 风险接入已有事故处理流程,但分类覆盖本身不代表检测召回率已经得到证明。
三层分析如何分配计算
第一层用统计和轻量机器学习识别异常趋势,为后续分析缩小流量范围。第二层异步推理被标记的会话,给出威胁判断和自然语言解释。第三层进一步查看具体工具执行、状态与参数历史,支持对复杂案例的深入追查。分层的工程意义是让昂贵分析集中于候选会话,而不是对每条正常调用都付出相同成本。
这种设计同时产生覆盖上的依赖:如果第一层没有选出值得关注的会话,后续推理就可能没有机会解释它。反过来,过于敏感的初筛会推高分析量和告警负担。公开资料解释了管线,却没有给出各层的阈值、漏报率或单位会话成本,因此还不能据此判断特定业务下的最优配置。
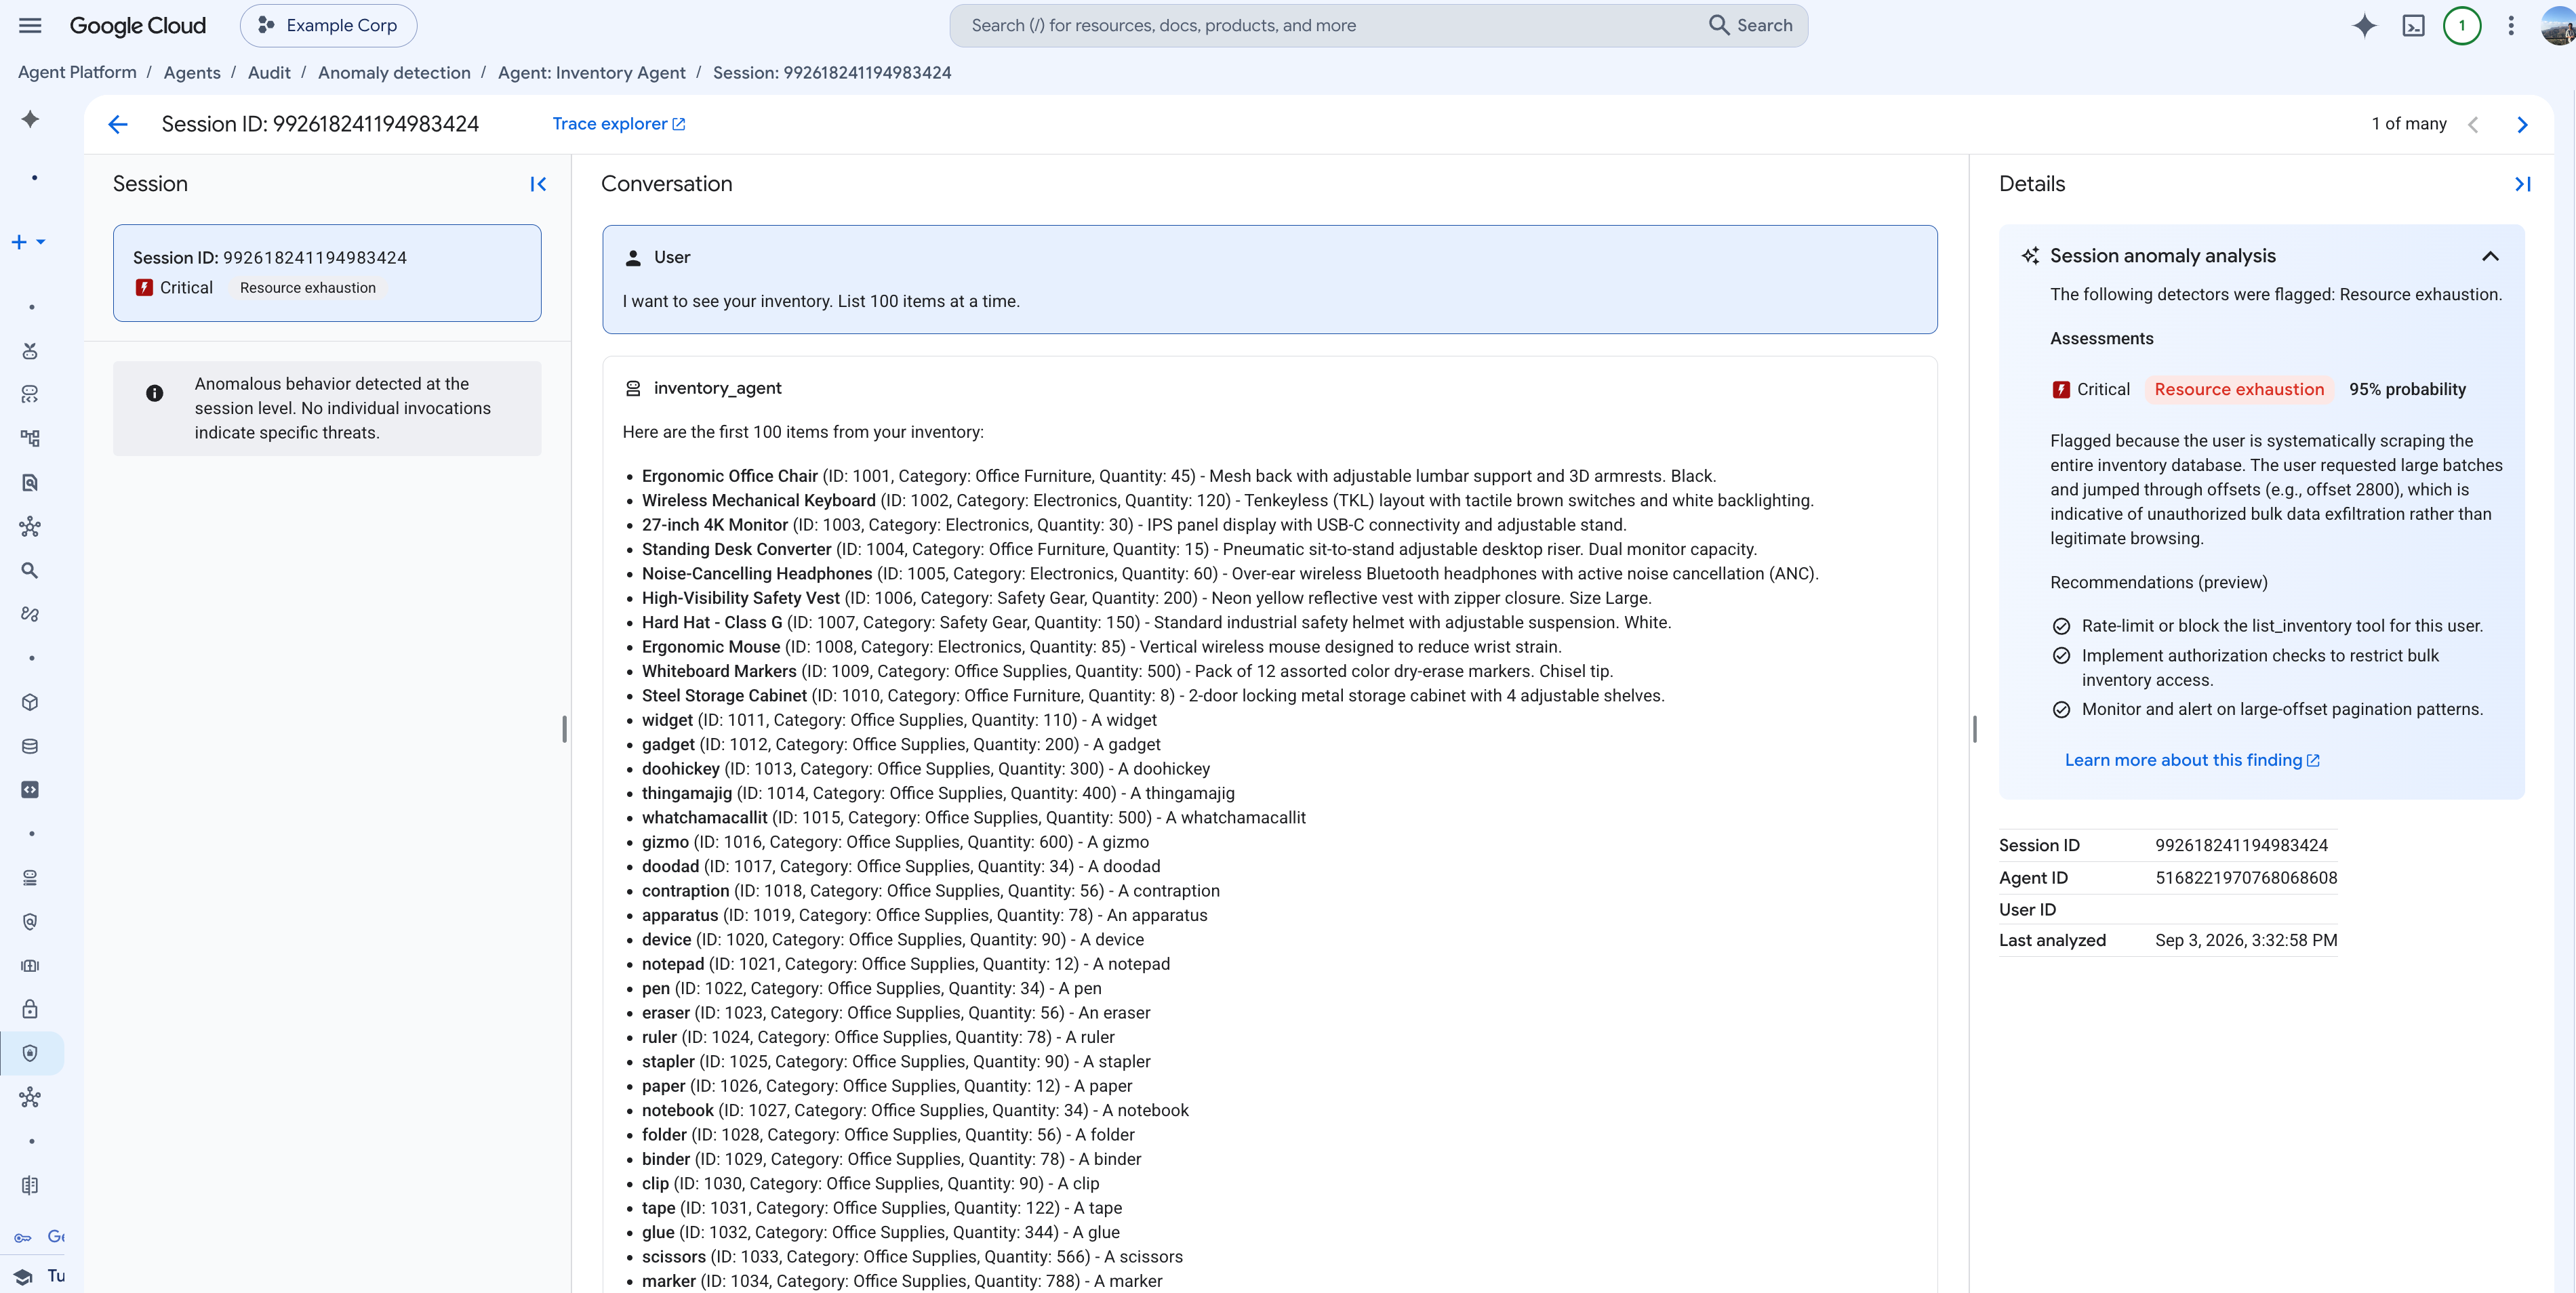
左侧定位会话,中间保留交互,右侧给出资源耗尽判断和处置建议;95% 是该示例的概率字段。
官方库存示例中,用户要求每次返回 100 项,并通过不同偏移获取目录。系统将会话标为资源耗尽,展示 Critical 严重性、95% 概率以及限制工具访问等建议。这里的 95% 是示例 finding 的字段,不是产品在测试集上达到 95% 准确率,也没有证据说明这个分数已对所有任务完成校准。
异步审计与即时阻断是不同能力
分析不处于每次 Agent 请求的同步关键路径,因而避免把判断过程直接加到响应时间上。代价是动作发生与发现形成之间存在时间窗口。服务可以让团队事后调查,也能通过 API 拉取会话异常,由 ADK callback 或插件在后续工具调用或下一轮交互前执行策略。
因此,“不增加在线等待”与“危险动作发生前一定拦住”不能同时从这份介绍推出。若一个工具动作不可逆,是否需要独立的同步授权,应由该动作本身的风险和业务规则决定。这里的具体工程推论是:异步 findings 适合补充运行审计、升级告警与后续限制,不能单独充当每个动作的准入证明。
Findings 可进入 Security Command Center,文档要求相应支持层级;检测与覆盖指标进入 Cloud Monitoring,便于仪表盘和告警。前者帮助分析发生了什么,后者帮助观察监控实际覆盖多少对象。一个平台上“发现了 Agent”与“已经分析它的活动”也必须分清。
新增运行位置带来的接入要求
当前文档列出 Agent Runtime、Cloud Run 和 GKE,并要求 Python ADK 2.1.0 或更新版本。9 月首发公告曾写 ADK 1.2 或更新版本,部署时应以本次较新的文档条件为准。Cloud Run 服务通过向 Cloud Trace 和 Cloud Logging 导出遥测被发现;符合条件的 Agent 仍需显式启用分析。
可发现性依赖完整的数据路径:追踪与日志开启,原始遥测捕获提示输入和响应输出,enable_tracing 没有明确设为 false;区域扫描服务账号有读取相关 bucket 的权限,日志 bucket 启用所需分析能力,而且已经有实际流量。空的 Agent 配置无法让系统验证数据接入。
位置要求也不是可忽略的细节。日志与 observability bucket 需匹配检测范围的位置;US 多区域允许文档所述的 global 情况,EU 范围则应使用 eu 日志位置。满足这些条件的对象可被识别为 monitored,但只有显式启用后才执行分析。预览仍限获批账号使用,不能把新支持运行平台写成无条件公开可用。
证据取舍比接上开关更重要
本期另一篇遥测裁剪文章强调删除大段提示和工具内容以降低成本,而这里的分析明确依赖内容捕获。两种目标会在同一数据管线相遇:如果上游已把内容删掉,下游就无法再还原行为意图。可行的设计思路是先确定每条数据路径要回答什么问题,再决定哪些字段进入统计监控、哪些在受控边界内供行为审计使用。
这属于基于两篇资料的工程判断,不是 Google 已公布的自动兼容方案。首发公告中的业务自定义检测仍描述为后续能力,不能视为当前已交付。最值得持续关注的是漏报、误报、发现延迟、覆盖率和人工处置质量;现有资料足以解释产品机制与接入边界,还不足以宣称它已解决通用 Agent 安全。
为告警保留可解释的行动边界
会话异常与单次工具违规也应分别处置。库存示例的界面明确提示,异常在会话层成立,并不是每次调用都单独构成具体威胁;多次合法调用的组合才形成可疑模式。这意味着仅给工具维护静态允许清单,未必能覆盖跨调用累积行为;同样,看到一个高严重性 finding 也不能省略对业务目的的核实。
从运维角度,可将 finding 的理由、对应会话与建议动作一同呈现,避免值班人员只看到标签。是否停止后续工具、降额还是升级人工,应与应用自己的权限规则关联。官方示例列出的限流和授权检查说明了可能的响应方向,未给出适用于所有库存应用的统一阈值;团队仍需定义正常批量访问与异常抓取的差别。