Agent 的计算需求很不均匀:模型思考或用户暂离时,代码执行环境可能长时间闲置;下一次工具调用到来,又希望文件、进程与依赖立即恢复。Google Cloud 的 Agent Compute Engine 把这种生命周期放进计算平台设计,同时把可运行不可信代码的沙箱与长期凭据分开。它提供的工程视角,是把隔离、空闲成本和持久状态当作同一个系统问题。原文:Inside Agent Compute Engine: Building the compute foundation for the agentic era。
Ramanathan Venkatapathy、Rohit Jnagal · Google Cloud · 2026-10-23
从一台常开 VM 到可暂停的会话
普通 VM 提供完整操作系统和强隔离,但启动、暂停与恢复通常比短工具调用慢;容器启动轻,却共享宿主内核。Agent 一方面可能需要 root、编译器和浏览器,另一方面又经常等待模型或人类。这使按整个会话持续预留 CPU 与内存的方式很浪费。
报告将 harness 与 sandbox 分开:前者决定下一步并调用模型,后者执行明确派发的命令并回传输出。每个会话使用单租户 microVM,宿主机采用无持久本地状态、只读根文件系统等控制,硬件信任根支撑节点与工作负载认证。这样的分层让“不可信代码执行了什么”可以与 harness 发出的工具请求对应。
长期凭据留在沙箱之外
平台的 zero-secrets 设计指向长期用户凭据、OAuth 刷新令牌和云服务账号密钥。沙箱不直接持有这些秘密,也不能通过常规实例元数据服务获取它们。它仍需要一个临时、会话范围的工作负载身份来标识请求,因此“零秘密”不能被误读为完全没有身份材料或认证过程。
出站请求先经过本地受限代理,再到节点之外的 Agent Gateway。网关验证用户委托、agent 身份和节点身份,检查出站及数据防泄漏策略,再在请求离开时换入后端需要的凭据。模型即使被恶意内容影响,也不能简单从自己的文件系统读取长期后端 token;但代理仍必须正确判断哪次操作获准,隔离凭据并不自动等价于阻止所有不当调用。
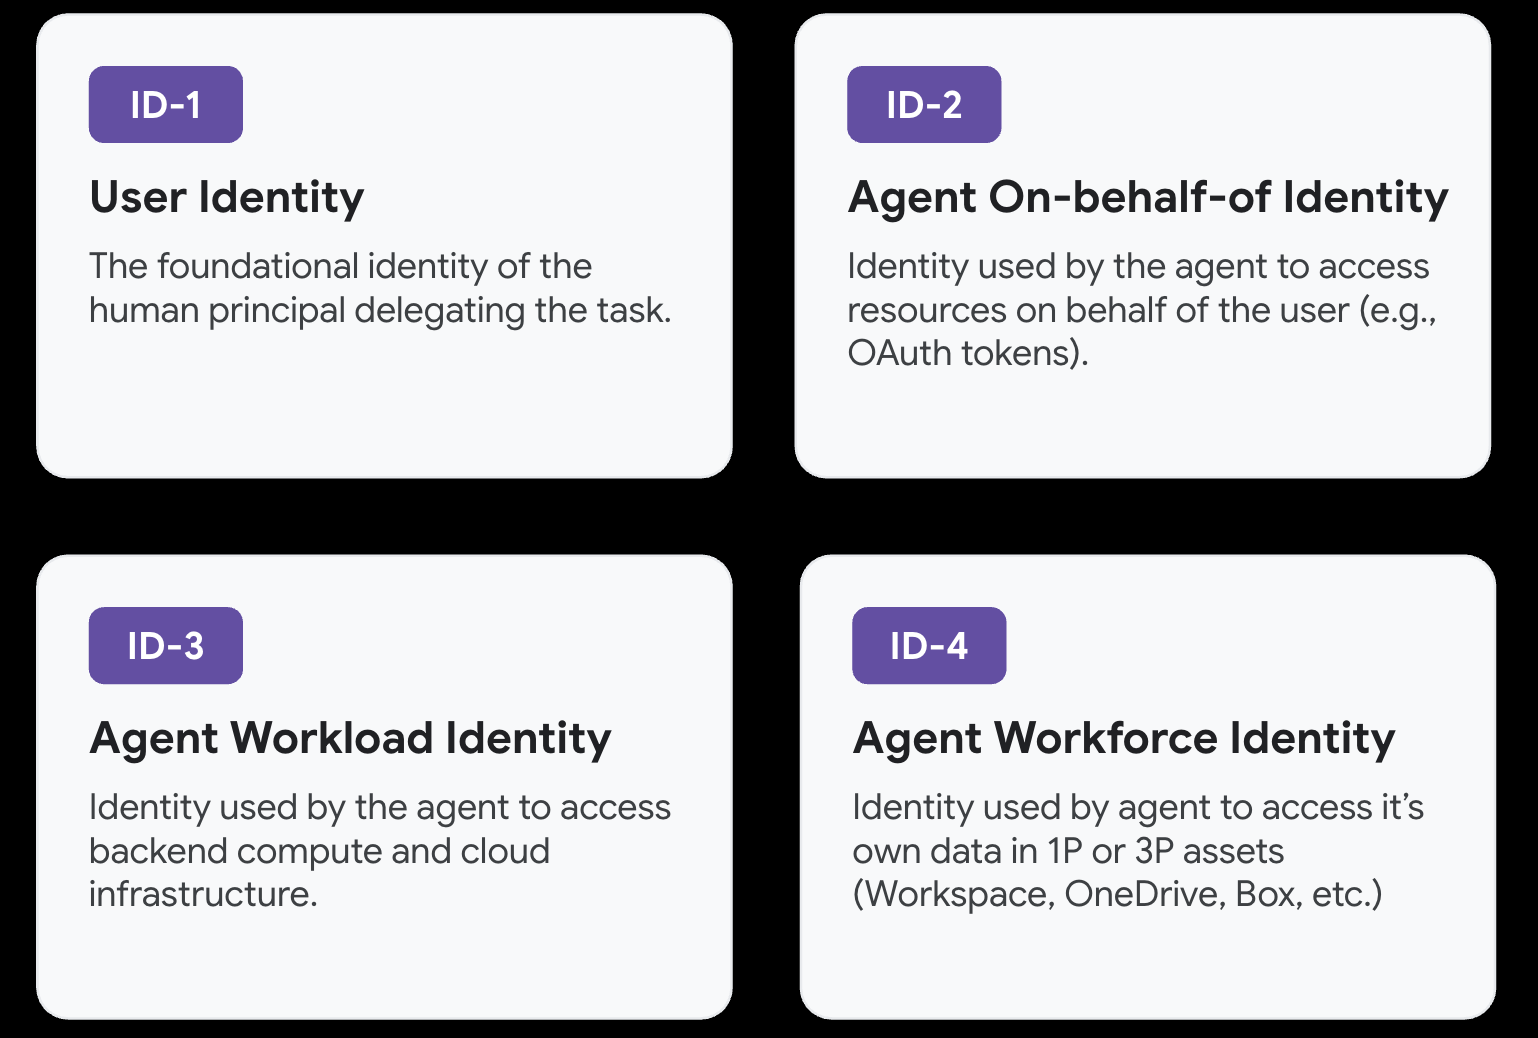
四种身份分别对应用户、授权委托、执行工作负载与 agent 自身账号;请求在网关处结合这些身份接受检查。
四种身份承担不同责任
用户身份说明谁发起或拥有工作;on-behalf-of 委托说明用户授予 harness 哪种工作权限;workload identity 标识哪台沙箱发起流量;workforce identity 支持 agent 以自己的账号与资源工作。把这四者拆开,能避免把“来自这个会话”直接当作“拥有用户全部权限”。
原文还强调网络路径受中介控制:microVM 没有普通外部网络接口、默认网关或直接 VPC 访问,通信走隔离的 virtio-vsock 边界和代理。对企业集成而言,范围限制在沙箱之外执行,Workspace 与私有网络访问可以沿同样的授权与审计路径处理。
空闲检测需要理解应用
平台与命令运行时协同设计,工具调用完成且没有后台任务时,由沙箱发出可空闲信号;宿主机随即检查点化,释放活跃资源,保留恢复需要的状态。关键不是看到 CPU 使用率低就随意休眠,而是知道当前会话是否仍有工作在执行。
这也提出可迁移的工程问题:用户启动的长任务、后台进程、未完成 I/O 和外部副作用怎样对应快照时刻。报告描述了快照、克隆、回退等原语,但没有给出每类应用副作用都可回滚的保证。恢复内存和文件状态不应被解释为撤销已经发送到外部服务的操作。
共享静态页面,持久化真正变化的部分
大量 agent 使用相同基础镜像、Python 和浏览器。平台预热初始化后的快照,通过 DAX 与写时复制共享静态内存页面,只为私有改动分配增量,再用回收与压缩归还资源。这样缩小的是重复环境的成本,而非用户工作数据天然消失。
存储也分三层:临时构建与日志进入可丢弃覆盖层;镜像、工具链和共享缓存只读复用;用户工作区和产物单独持久化。原文还描述共享卷用于协作。这个划分让会话跨轮、跨日保留成果,同时避免为每个 agent 复制完整环境;但具体持久化成本仍取决于工作区大小和写入模式。
用时间差填平资源需求
交互式个人会话、企业工作时段和内部 RL 评价的高峰并不完全重合。统一资源池可以在交互请求增加时让低优先级任务让位,低谷时再运行可延后的评测、研究或迁移。全球调度同时受区域、数据位置和企业策略约束,不能只选择最空闲的区域。
这里的优化来自空闲回收、基础状态共享和时移调度的组合。原文没有提供可独立比较的全面性能基准,因此“近零活跃资源”不等于总账单为零,“快速恢复”也不应被补成未公布的延迟数字。服务在文章发布时面向未来数月的 preview,尚不能写成已普遍可用的采购选项。
优先读身份代理和生命周期两部分:它们展示了 agent 平台怎样把权限与执行分开,又怎样只为真正活跃的工作付出计算资源。
状态恢复与权限恢复应分开
会话恢复时,文件和内存可以来自昨天,今天的用户权限却可能已经变化。由网关在沙箱之外重新检查委托和策略,提供了避免把旧授权随快照永久保存的一种设计方向。这里的工程判断是,恢复工作进度不应自动恢复已经撤回的访问权;文章给出了身份中介结构,但没有承诺每种企业授权变更都具有相同传播时延。
共享基础页面与隔离会话也需要共同考虑。静态镜像复用能降低内存成本,硬件与运行时控制则需要维持会话边界。对平台评估,不能只比较单次冷启动速度,还应观察大量会话同时恢复、私有写入增多、共享依赖升级及资源池拥挤时的行为。原文没有提供这些压力情形的逐项数字,因此它目前更适合作为架构阅读,而非性能承诺表。
同样,所谓长期 agent 并不意味着每一轮都需要长期占有同一物理主机。稳定的是工作区与身份语义,执行位置可以随策略和容量改变;这要求控制面、存储和审计记录对同一会话保持一致的解释。