Anyscale · 推理服务工程指南
原文:Cut coding agent costs by 90%: Secure LLM serving with Ray + vLLM on Anyscale
为什么编码 Agent 的流量需要单独优化
编码 Agent 往往反复提交仓库上下文、工具定义、历史对话和工具结果,而每次输出可能只是一条工具调用。输入长、跨轮重复多,中间又有工具执行和人类思考的停顿。服务瓶颈因此不只在生成 token 的速度,也在读入上下文、缓存复用和突发请求排队。
这篇指南把这些负载特征放进自建推理服务的设计中。它值得读的部分是模型、缓存、路由与容量怎样配合;标题里的“节省 90%”需要结合假设单独判断。
架构:引擎、多副本服务和运行平台各管一层
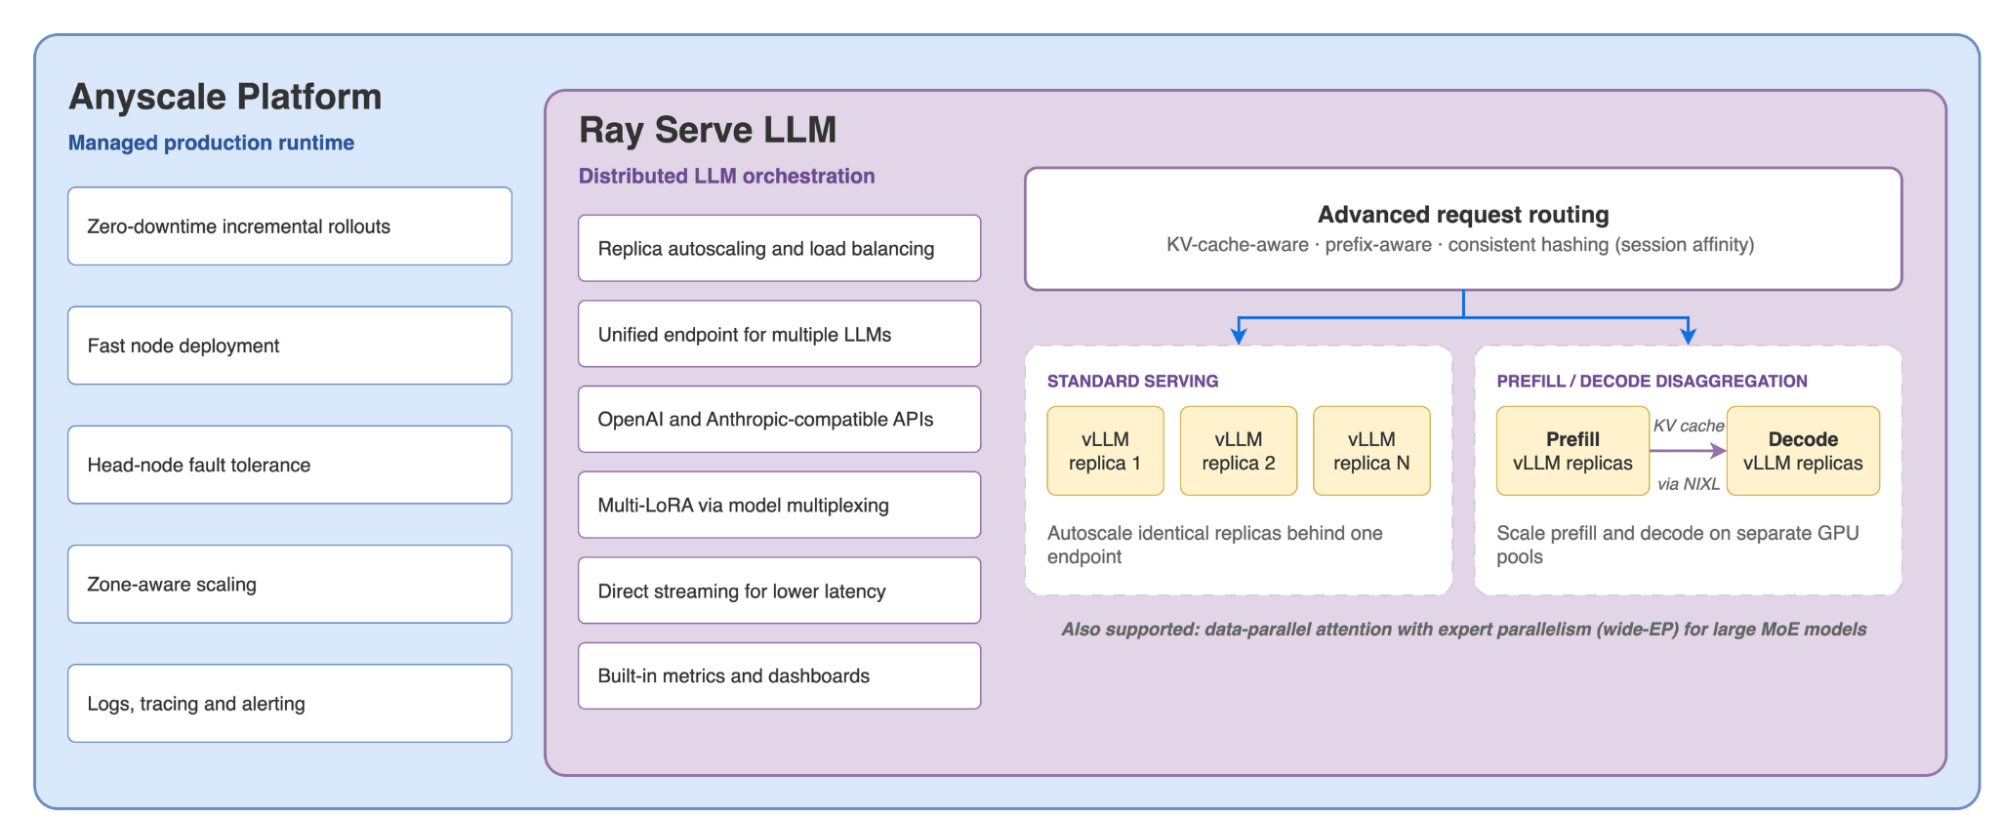
读图:vLLM 负责模型执行,Ray Serve LLM 管副本、请求路由和统一接口,外层 Anyscale 管 GPU 资源及服务运行。引擎跑得快,只覆盖其中一层。
单个请求进入服务后,既要决定由哪个副本执行,也要考虑该副本已经缓存了多少相关上下文。把同一会话持续发到熟悉它的副本,可以减少重复计算;但只追求缓存命中,也可能把请求集中到已经繁忙的副本。因此路由需要同时看可复用内容和剩余负载。
多模型路由解决另一类问题:哪些任务由自建模型处理,哪些转给其他模型。这里还需要保持会话的一致性,避免同一段工具交互中突然切换模型,遇到上下文范围或工具格式不兼容。
把缓存、路由和扩缩分开看
这三个机制处理的是不同问题。缓存减少同一上下文的重复计算;副本路由决定请求交给哪台引擎;扩缩决定准备多少服务容量。它们会互相影响,但不能只靠调一个并发参数同时解决。
以一个开发者会话为例:第一轮读取大量代码,需要处理较长输入;第二轮只补充工具结果,历史前缀大部分相同。若第二轮仍由有对应缓存的副本处理,就有机会跳过重复部分;若这个副本排队很长,等待的代价又可能超过缓存收益。
因此,缓存感知路由需要估计“还要计算多少输入”和副本正在处理多少工作。只按请求数量分配,看不出长短上下文的差异;只追求缓存重叠,也可能把热点越集中越严重。这是负载形态决定路由设计的一个具体例子。
扩缩则需要留出响应时间。引擎准入上限、发给某副本的在途请求上限、触发扩容的目标值,应分别理解。把扩容阈值等同于硬容量上限,可能在新副本还没准备好时就形成长队。原文给出的参数只能作为所测配置的起点,不能直接照搬到不同模型和 GPU。
缓存怎样改变等待时间
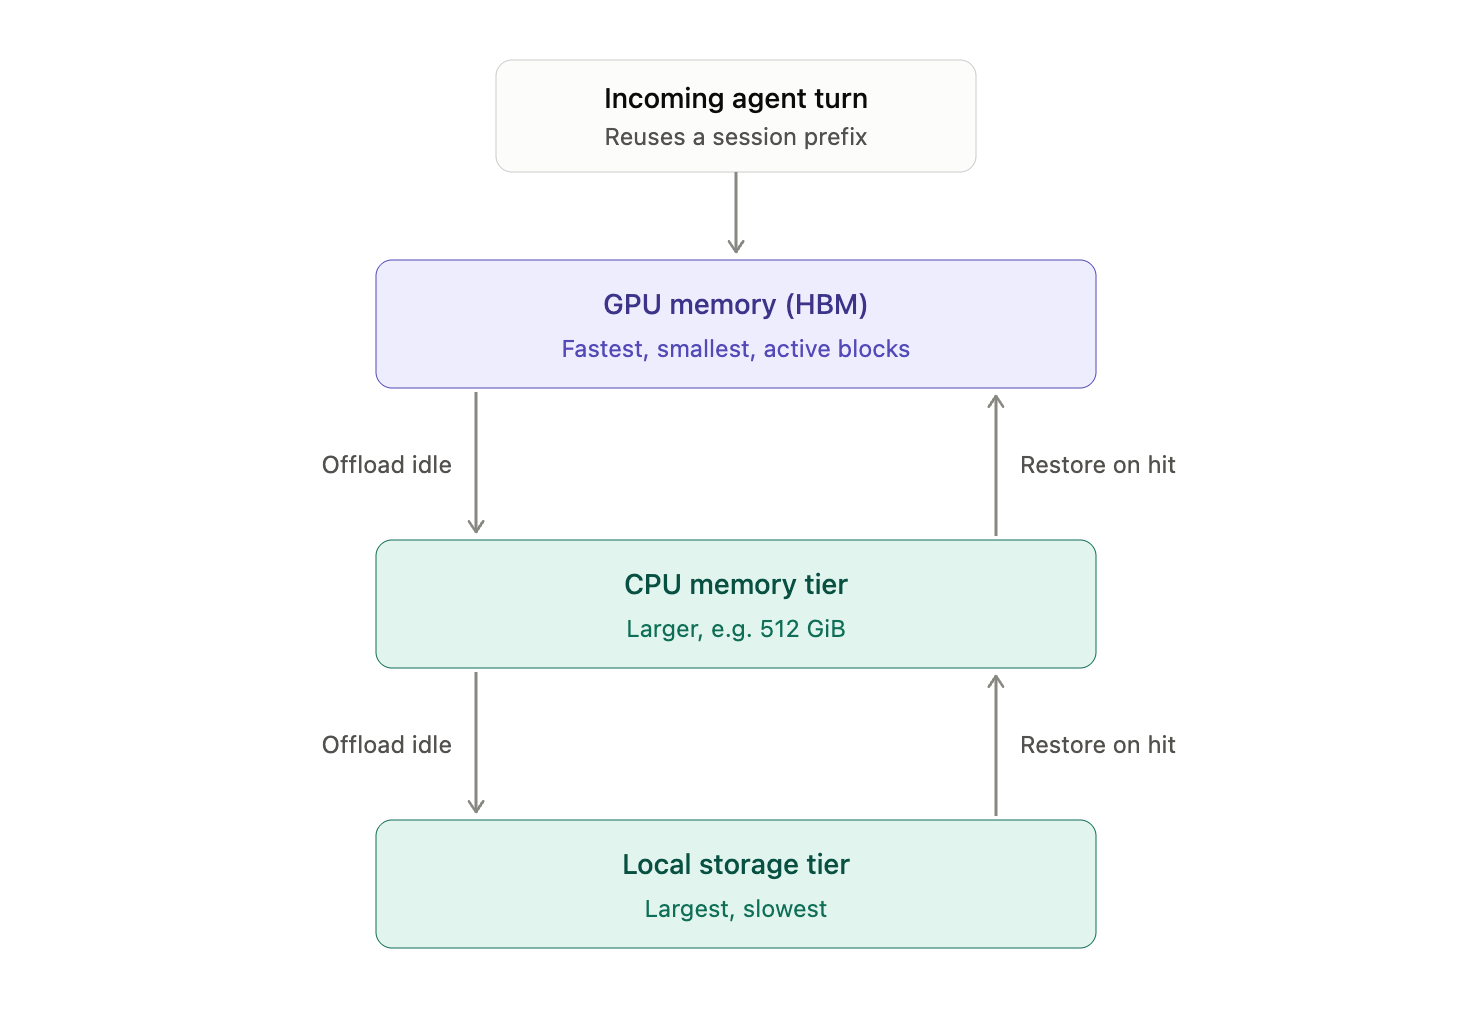
读图:活跃缓存放在 GPU,空闲块可卸载到容量更大的 CPU 或存储层;会话回来时尝试恢复,而不是重算整个前缀。
长上下文占据大量 KV cache。开发者停下来读代码时,其他请求可能把这些块挤出 GPU;分层缓存试图延长上下文的可复用时间,但恢复数据同样有传输成本。
Anyscale 报告的一组受控测试使用 GLM-5.2、单节点 8 张 RTX PRO 6000,以及额外 512 GiB CPU 缓存层:
| 指标 | 仅 GPU 缓存 | 加入 CPU 层 |
|---|---|---|
| 标称 900 秒窗口内完成请求 | 58 | 215 |
| 首 token 等待时间中位数 | 48.4 秒 | 9.2 秒 |
等待时间比较基于两种配置都完成的 58 条请求。这个结果说明,所测负载确实能从缓存保留中受益;不能据此认定任意模型、并发或会话分布都有相同比例的改善。
多模型路由决定的是任务分配
副本路由通常是在同类服务之间分配工作,多模型路由则改变了执行任务的模型。指南给出的方向包括:把常规任务交给自建模型,在复杂任务或容量不足时使用其他模型,并保留用户显式选择。
难点不只在判断任务难度。编码会话的后续请求可能只有工具结果,没有新的用户描述;如果每一轮都重新分类,可能把同一条工具交互切到不同的模型。格式、上下文和工具行为的差异会影响任务连续性,所以原文强调会话黏性。
这也意味着,路由收益需要按完整任务计算。一次请求更便宜,但若增加了修复轮次、失败重试或人工接管,总成本未必更低。吞吐和单次 token 价格应与任务成功率、总时长一起观察。
怎样理解“节省 90%”
原文的规划假设是 GPU 节点约每小时 4 美元、50 名注册开发者共享一张 GPU,由运行时段推算人均 GPU 支出。这里的注册人数并不等于已经验证的同时服务能力,GPU 费用也不是完整拥有成本。 模型质量、峰值排队、闲置、平台和运维成本都会影响实际结果。
还有一个容易混淆的条件:上面的缓存性能测试使用八张卡,而成本规划按一张卡计算,不能将两者拼成同一部署的性能与价格承诺。应先在真实会话负载上测出满足延迟要求的容量,再结合任务成功率计算成本。
性能优化必须同时保住工具调用正确性
原文依次讨论权重与 KV 量化、CUDA graphs、推测解码和冷启动缓存。它们改变的瓶颈不同:量化影响内存与计算,CUDA graphs 减少重复执行的调度开销,推测解码尝试一次推进多个 token,编译缓存则主要影响启动阶段。
这些收益不能直接相乘。文章在一个并发设置下观察到,推测深度从三 token 增到四 token,输出吞吐反而下降;它还提醒某些模型、解析器和运行时组合可能出现工具调用兼容性问题。更激进的配置需要完整多轮会话验证。
冷启动也应拆开测量:模型下载、权重加载、引擎编译和服务就绪是不同阶段。减少编译时间不代表端到端启动时间按相同比例缩短,更不代表稳定运行时的请求吞吐同步提高。
这份指南最可借鉴的实施顺序
先建立能正确执行目标工具交互的基线,再逐项调整,而不是一次打开所有优化。原文强调用真实会话回放保留输入增长、跨轮等待与突发性;长度一致的合成 prompt 很难代表编码工作流。
| 先测什么 | 要回答的问题 |
|---|---|
| 完整任务成功率与工具错误 | 配置变化是否损害任务完成能力? |
| 首 token、输出间隔和总时长 | 用户的等待发生在哪个阶段? |
| 排队、缓存命中与 GPU 使用 | 瓶颈是容量、重复计算还是负载不均? |
| 满足延迟要求的完成量 | 提高吞吐后,交互体验是否仍可接受? |
有了这些结果,才适合判断量化、缓存或扩容是否有效。模型、硬件和版本变化后,也要重新确认兼容性与质量,不能把旧配置的测量值作为新部署的承诺。
工程判断:适合评估自建编码 Agent 推理服务的团队参考。 主要价值是提供从单副本到多副本的组织方式与测量思路,能否比托管 API 划算仍取决于自己的任务和负载。作者仓库提供分阶段示例;本期没有安装或运行其中的服务,也没有把博客中的成本模型当作当前采购报价。