Google · 质量工程参考实现
原文:The Outer Loop, Insights First: An Ambient Quality Agent That Diagnoses Your Production Agent
服务没有报错,质量为什么还会下降
Google 的旅行助手案例中,用户说想坐 3A,Agent 就把座位写成已确认,却没有调用子 Agent 检查是否可订。另一个案例中,素食偏好没有传给下游,助手推荐了牛排餐厅。两者都可以返回正常 HTTP 状态,也没有工具调用错误。
传统运行监控容易看到延迟、异常和调用量,质量评分能提示成功率变化,但“哪一类问题反复发生、应该改哪里”仍需要读轨迹、查配置和源码。AQuA 试图把这项工作放到生产系统旁边持续执行,让线上发现重新进入开发阶段的评估与修正流程。
它与在线评分、运行时监控怎样分工
可以把质量工程分成三个问题:当前版本是否通过已知用例,线上表现有没有变化,以及变化究竟对应什么可修复的问题。离线评估擅长第一个问题,线上指标帮助发现第二个问题,AQuA 主要补充第三个环节。
以座位误确认为例,延迟与错误率看起来正常;一个任务评分器也许能判失败,但工程师仍需找到共同模式。AQuA 把同类会话聚起来,再回到对应部署版本,检查是否缺少“用户直接指定座位时也必须核验”的规则。
它与执行中拦截动作的监控器也不同:旁路分析不会增加每次业务请求的同步判断步骤,但发现问题之后仍需要另一个修复与发布流程。因此,它适合持续发现和整理缺陷,不能替代高风险动作发生前的授权或保护。
架构:旁路分析会话,对齐产生它的版本
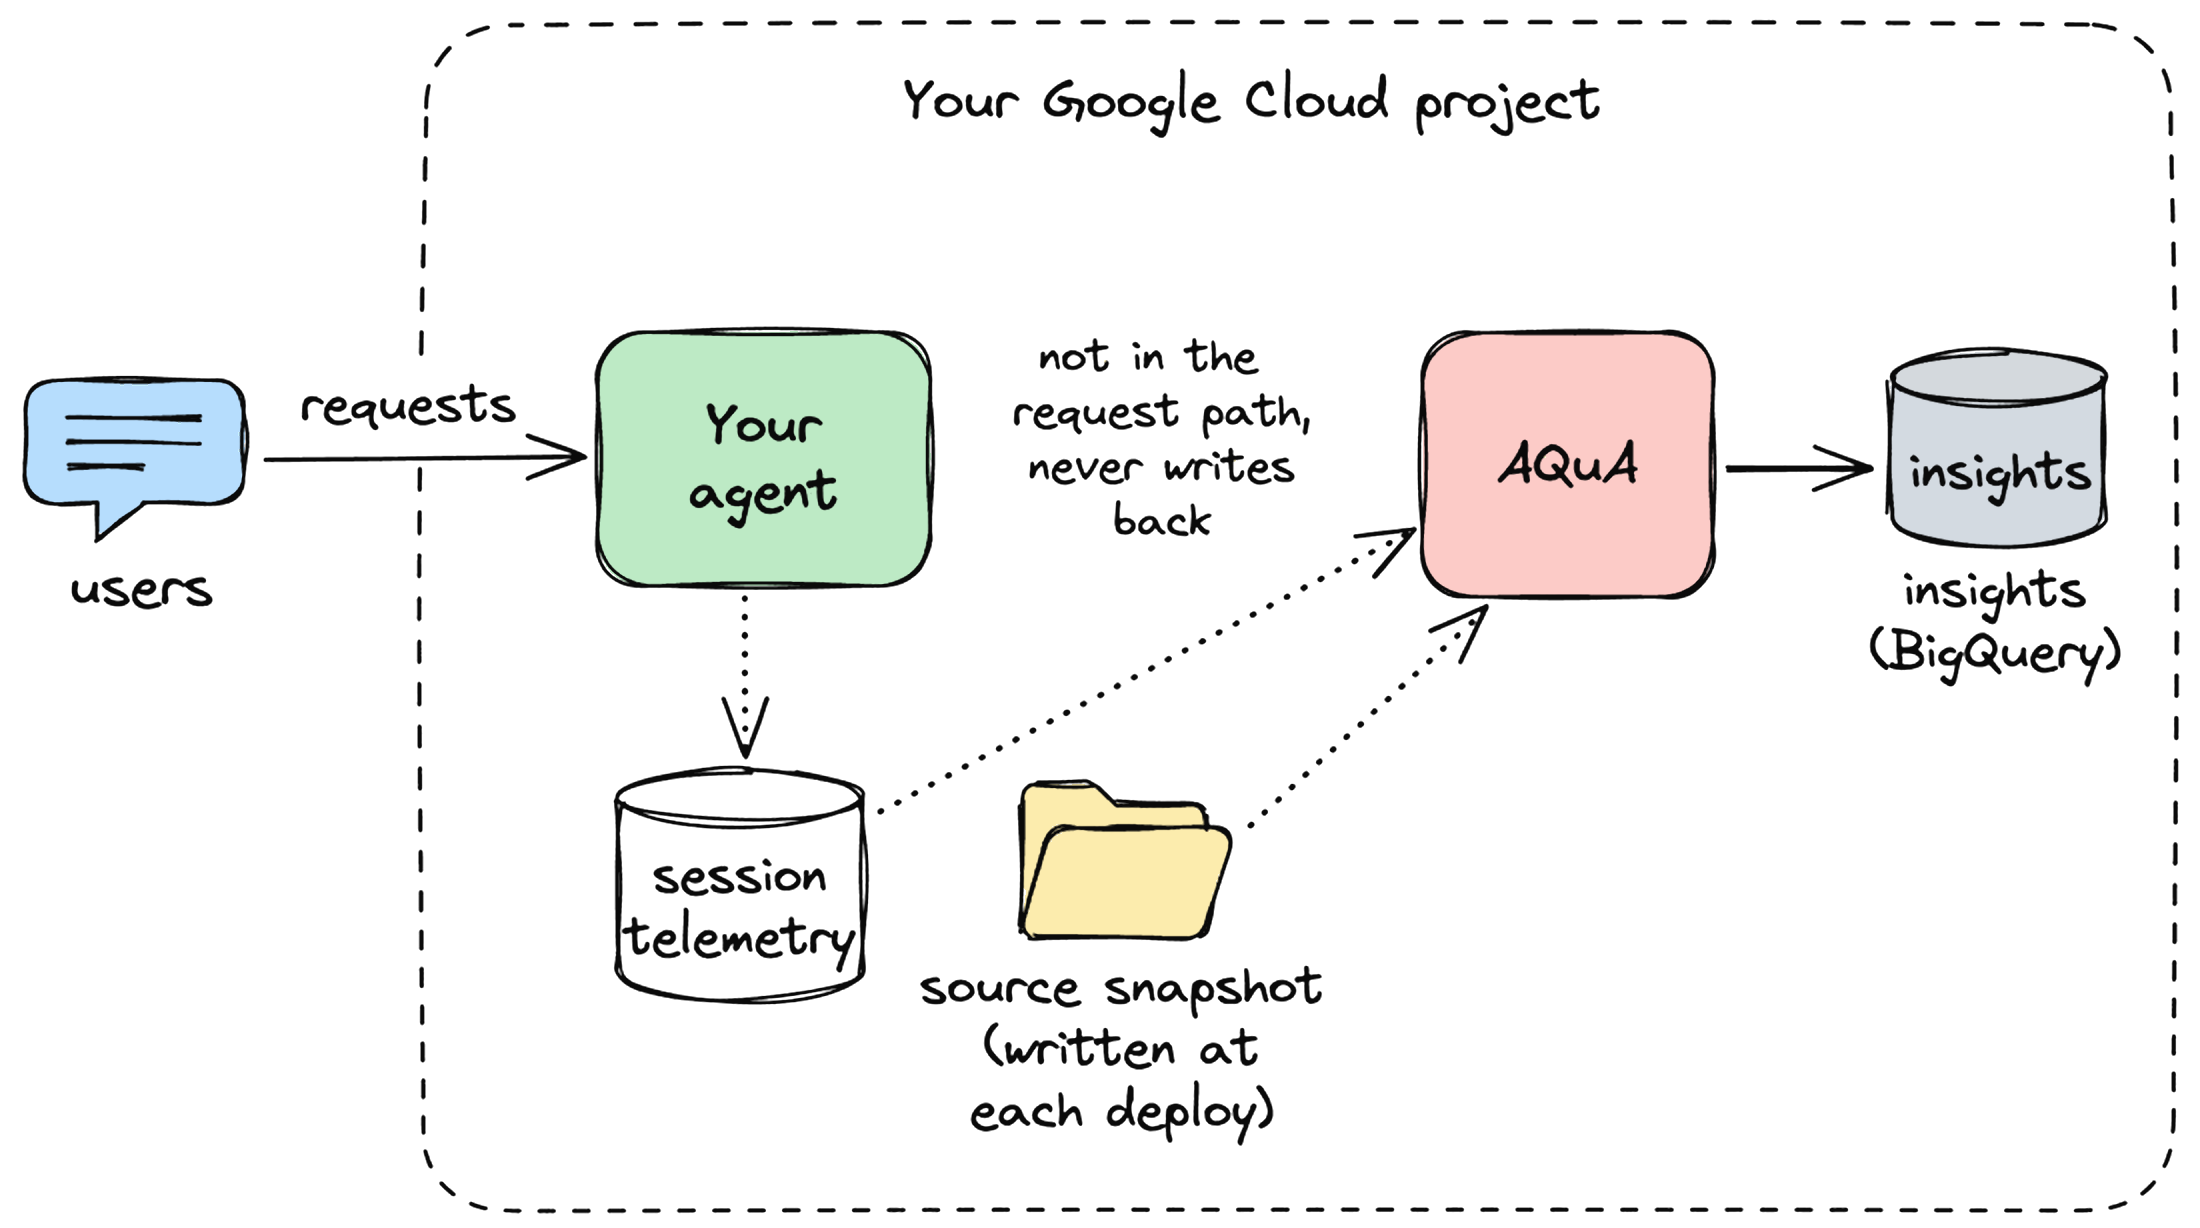
读图:业务 Agent 接收请求并留下遥测;AQuA 另行读取会话和部署时源码快照,把发现写入问题库。它不拦截请求,也不直接修改业务 Agent。
这里最关键的组合是执行证据+对应部署版本。仅检查当前仓库,可能用新代码解释旧故障;保存部署快照,才能把问题定位回当时实际生效的指令、工具声明和编排逻辑。诊断若发现问题来自外部依赖或交接步骤,也可以只归因到轨迹位置,不强行生成代码补丁。
这与运行中阻断动作的监控器分工不同:AQuA 先整理已发生的问题,再交给工程师或编码 Agent 修正。它自己的输出是带证据的问题与建议,不会自动应用修改或创建 PR。
一次质量扫描如何运行
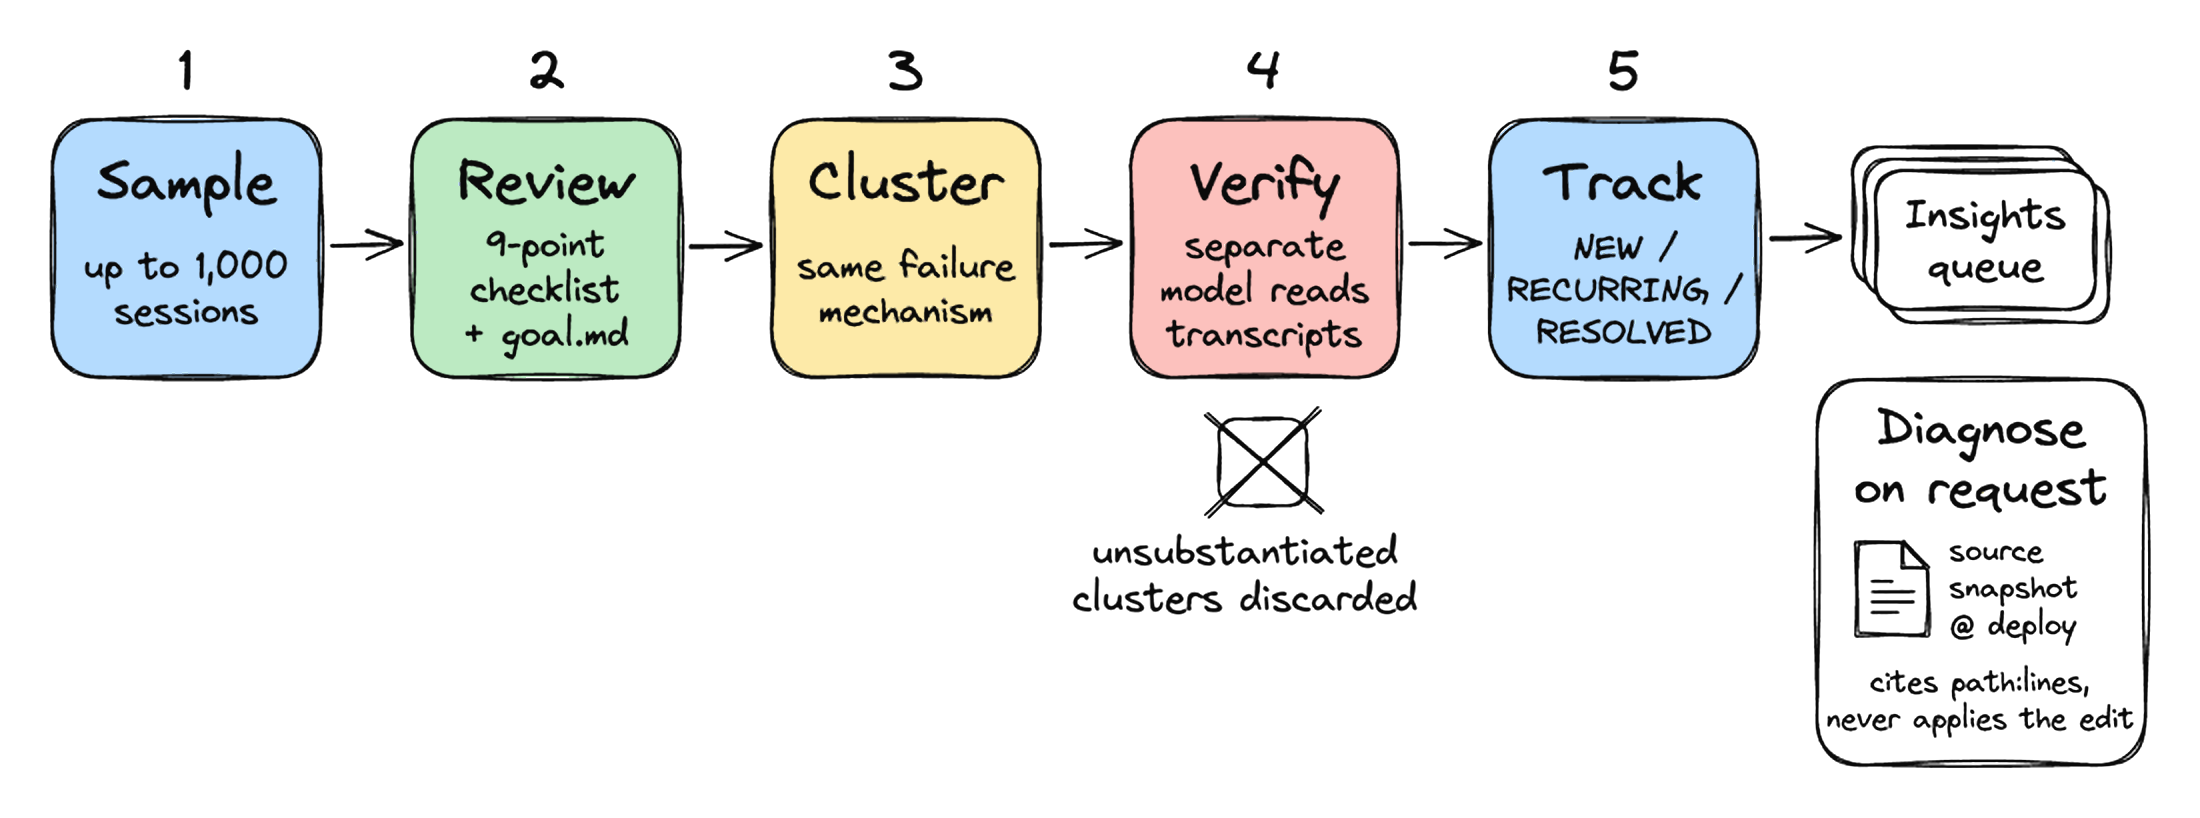
读图:采样 → 逐会话评审 → 聚合同类问题 → 回到完整轨迹核验 → 跨批次追踪。右下角的根因诊断按需启动。
每次扫描先抽取近期会话,再结合 Agent 指令、工具定义和可选的业务目标检查偏差。同一失败机制被聚成候选问题后,另一个模型查看完整会话进行核验,证据不足的簇会被丢弃。通过核验的问题进入持续追踪,值得调查的再触发源码诊断。
这个流程的工程意义在于,把大量单次失败压缩成可处理的问题队列,同时保留回到原始证据的入口。不过,每簇最多核验三条完整会话,核验的是候选模式,不是证明簇里每条会话都判断正确;出现次数适合排序,不应直接视作精确故障数量。
从单条发现到问题队列,需要哪些约束
先描述偏差,再解释原因。 初始评审记录 actual / expected,即实际行为和应有行为。座位被写进状态是观察到的动作,为什么漏掉核验则需要进一步查轨迹和源码。把两者分开,可以避免模型先猜原因、再挑支持猜测的证据。
聚类结果仍需要核验。 原文案例里,验证器剔除了三个候选簇:有些行为其实是用户明确要求的,有些簇则把不同子 Agent 的问题混到了一起。这说明“看起来相似”不等于具有同一故障机制。另一模型读完整会话,是对压缩与聚类过程的一道检查。
问题生命周期不等于修复证明。 系统将问题标为新出现、重复出现,或在连续 14 天没有再次观察到后自动归为已解决。后一状态是追踪规则:抽样期间没有看到,不代表缺陷已经被反事实测试证明消除。这个区别会影响怎样使用问题队列作为质量指标。
源码诊断还要求引用能够在相应快照中找到的文件和行;引用不存在的位置会被拒绝。这能阻止无效定位混入结果,却仍不能单凭“文件确实存在”证明根因判断正确。
展示了怎样的修复效果
Google 用四种脚本化旅行场景做了 32 次会话回放。评审产生 42 条发现,聚成 9 个候选簇,核验后留下 6 个问题。针对座位检查和饮食偏好交接修改提示词后,同一批回放得到:
| 观察项 | 修改前 | 修改后 |
|---|---|---|
| 绕过座位检查的会话 | 15 | 2 |
| 遗漏素食偏好的会话 | 7 | 0 |
| 全会话通过数 | 5/32 | 13/32 |
这些结果支持“扫描—定位—修改—复核”流程可以发挥作用,但它们是作者的受控案例,不是跨产品的生产成功率证明。完整通过数仍只有 13/32,未修改的问题也没有自动消失。
成本为什么随轨迹复杂度变化
作者给了两种扫描成本:96 个较短单 Agent 会话约 0.70 美元;32 个、每会话约 50 个 span 的旅行助手会话约 3.76 美元。金额属于原文配置下的记录,不能把前者简单换算成所有系统的每会话价格。
更深的轨迹带来更多指令、工具结果和交接关系,评审与核验需要处理的上下文也更多。根因诊断另外按需触发,并不是每次扫描都对所有会话完整读仓库。理解这层成本分离,比只看一个平均单价更有用。
参考实现通过随机采样、每次最多验证 50 个簇、每簇最多读三条完整轨迹来限制工作量。代价是覆盖不完整:低频但关键的静默失败,可能一直没有被抽到。仅按超时或高延迟预筛,也可能反复选中同一类显性故障。
实际采用时,先检查三个条件
是否有足够的证据。 会话需要关联到有效的指令、工具声明和部署版本;仅有零散日志,诊断容易缺失关键上下文。
是否有明确的业务目标。 模型不知道所有产品规则。把“用户主动报座位号时仍必须核验”这类要求写清,比泛泛要求提高质量更有用。
是否能重新验证。 重放用户输入不等于恢复原环境。数据库内容变化、外部工具不幂等或前后轮依赖不同,都会使重放偏离原故障。
阅读后的工程取舍
如果已有集中轨迹、部署版本管理和明确业务规则,可以重点参考“发现、核验、定位、回流评估”的组合。若这些基础记录尚不完整,应先明确哪些结论有证据支撑,避免用自动化评审掩盖信息缺失。
一个值得保留的人工检查点,是审阅候选问题及其代表会话:它既能发现误报,也能帮助修正业务目标。系统随后产生的修复建议,应回到隔离测试和版本发布流程;扫描问题队列与验证修复效果是相互连接的两项工作。
工程判断:适合有线上轨迹、但质量分析仍依赖人工翻日志的团队参考。 它提供了问题整理和版本对齐的实现路径;稀有静默失败可能被随机采样漏掉,模型核验也仍需校准。官方仓库提供本地假数据演示入口,本期仅阅读材料,未运行或部署该系统。