Nidhi Bhatia, Samkit Jain, Sai Kishan Pampana, Ritika Borkar, Bita Darvish Rouhani · NVIDIA · 2026-07-31
原文:Co-Designing AI Model Attention for Fast, Interactive Long-Context Inference
长上下文使注意力成为越来越显著的推理成本。NVIDIA 从 GPU 上的矩阵形状、访存和并行方式解释:模型结构本身如何影响 prefill 和 decode。文章讨论的是稠密注意力及其所测 kernel,不是所有模型和全部推理开销的通用速度公式。
同一注意力,两个瓶颈
Prefill 同时处理输入 token,矩阵较大,文章的分析将其视为计算受限;普通 decode 每步只产生一个 token,反复读取历史 KV cache,常受显存带宽限制。前缀缓存带来一个重要例外:新输入很短、已缓存上下文很长时,prefill 的行为也可能更像 decode。推测解码则会增加每步有效查询长度,使 decode 更接近计算受限。
令 G 为每个 KV 头共享的 query 头数。在文中的 FP8 注意力与 KV cache 假设下,增加 G 可以让多个 query 复用同一份 KV 读取,提高 decode 的算术强度;prefill 则主要受输入长度影响。
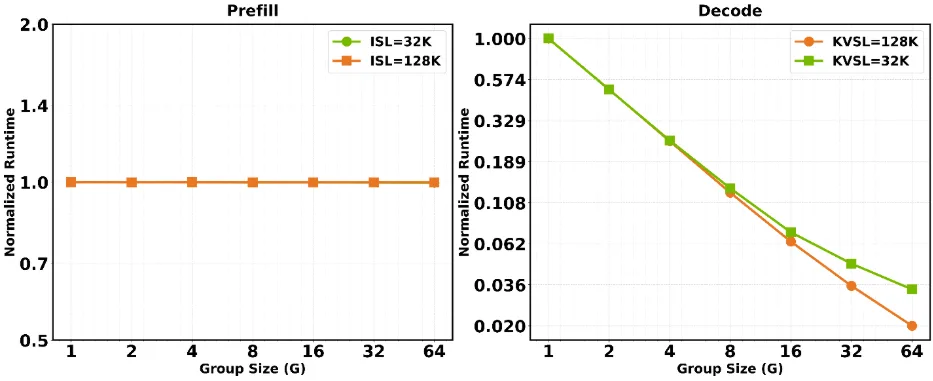
读图:所测 prefill 曲线几乎水平;decode 随分组增大下降,短 KV 序列在大分组处趋平。
图中使用 64 个 query 头、头维度 128、prefill batch 1 和 decode batch 8,序列长度为 32K 或 128K。作者测得 G 从 1 增至 64 时 prefill 运行时间变化小于 1%;decode 在部分区间约随 G 翻倍而减半,但 32K 曲线在 G 超过 16 后趋平,固定开销和并行归约开始占更大比重。这是 kernel 实验结果,不等于端到端服务延迟也按相同倍数下降。
头维度与序列长度
头维度增加会同时增加计算和 KV 数据量,但不会改变文中简化模型的算术强度。作者根据 GPU tile、128 字节访存及 tensor memory 容量,建议优先考虑 128 或 256 的头维度;64 可能仍支付更宽 tile 的成本,512 则接近容量约束。这些建议依赖其硬件和 kernel,不应替代模型精度评估。
稠密注意力下,prefill 工作量随输入长度近似平方增长;单步 decode 读取 KV 的成本随缓存长度近似线性增长。短序列时固定开销会使实测比例偏离理想曲线。压缩 KV、稀疏或滑动窗口注意力、混合架构都能减少有效状态,但会改变模型或注意力行为,需要另行衡量质量。
KV 头数也是并行边界
张量并行按头切分;当 GPU 数超过 KV 头数,共享 KV 头需要复制,可能增加内存与带宽开销。较大的 G 有利于 decode,却意味着更少的 KV 头,可能更早遇到这个并行边界。文章讨论通过 attention data parallelism 或 KV parallelism 与 expert parallelism 配合扩展,具体收益仍取决于通信、负载和实现。
这篇文章的价值在于把单卡 kernel 效率和多卡切分放在同一张设计图里:分组、序列长度、模型质量和部署拓扑需要一起评估,而非只优化某一个孤立指标。