AI SRE 的价值往往取决于能否把告警转成可追查的证据,而不是生成一段听起来专业的根因解释。Bronto 开源的 Alert Investigation Agent 将这个过程拆成告警识别、上下文生成、调查与报告四个阶段。它值得阅读的地方是阶段之间的约束:哪些字段由服务接口确定、哪些问题需要人确认、模型能够查询哪些日志,以及预算耗尽时如何结束。
原文:Introducing Bronto’s Open-Source Alert Investigation Agent
Nikolai Gladychev · Bronto · 2026-10-21 · 项目与 README
先确认正在调查哪一个告警
自然语言描述并不等同于一个明确事件。“网关 500 增多”可能对应多个监控器和不同时间窗口。交互模式先查询审计日志,让用户确认目标告警,再选择是否加入 playbook。项目将确认步骤建模为工具调用,由中间件暂停并等待选择;未确认目标时进入放弃分支。这避免把身份不明的事件一路包装成完整报告。
确认也不是所有入口都具备的固定步骤。Webhook 已经携带已知告警,因此直接进入上下文和调查,不逐步询问用户。这里的设计取舍是把交互确认放在存在歧义的入口,而不是宣称每次自动调查都有人批准。自动生成调查报告与批准执行修复也应分别理解,当前流程的产物是报告和建议。
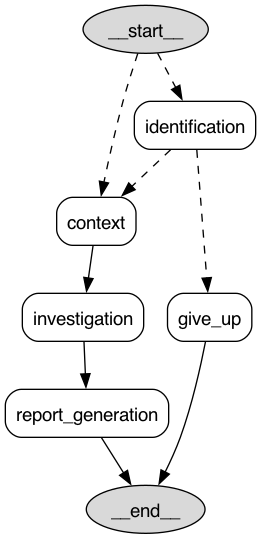
读图:交互入口先识别告警,已知告警可直达上下文;无法确认时进入 give_up,其余路径经过调查与报告后结束。
把时间范围交给确定性逻辑
上下文阶段通过 SDK 的 REST 查询获取监控器、底层查询和数据集,计算告警触发前的时序以及绝对调查窗口。有 playbook 时,模型可以辅助判断涉及哪些数据集;核心事件标识与时间边界不靠模型自由猜测。这个阶段的作用,是给后面的推理固定一个可解释的搜索范围。
调查阶段只绑定 get_keys、get_key_values、search_logs 和 timeseries 等工具,允许并发查询。中间件从模型可见 schema 中移除 time_range,再从上下文补入绝对时间边界;失败调用采用退避重试。这是一种将容易出错的参数选择移到程序控制层的做法,也使历史告警不至于被默认“最近一段时间”的查询替代。
不过,窗口正确并不等于根因一定在窗口内。部署变更可能更早发生,依赖系统也可能没有进入相同日志集合。从工程上看,范围约束提升了可控性,也可能限制证据覆盖。扩展这套系统时,需要明确何时允许扩大时间窗或引入新数据源,并保留扩展理由;这属于基于实现的设计建议,不是项目已经证明解决的问题。
五次调用是调查预算,不是整条任务的总价
README 中调查阶段默认最多五次模型调用,--max-model-calls 仅控制这一阶段。上下文生成与报告生成各自最多还有一次模型调用,识别阶段另有预算机制。因此,把参数设为五不能推出完整调查只有五次调用,也不能据此估算固定费用。
最后一个调查轮次会移除搜索工具,只留下结构化 findings 工具,要求形成包含根因、证据、修复建议与置信度的结果。这样的结束方式比直接截断对话更容易交给报告阶段处理,但它保证的是输出形状与流程终止,并不保证证据已经充分。模型填写的置信度也不能自动当作经过校准的概率。
另外,工具返回大小没有上限。即使调用次数有限,一次宽泛日志搜索仍可能快速撑大上下文。原文强调针对相关日志进行查询而非采样;这不能解释为所有相关信息都进入了模型,查询表达式、数据集选择与返回规模仍决定它实际看到什么。控制调用次数、控制数据量与检查证据充分性,是三个不同的预算问题。
报告速度与诊断质量需要分开看
官方文章称,默认设置配合 Claude Sonnet 5,大约一分钟可以生成报告。这个数字是产品方提供的使用描述,没有配套故障样本分布、根因标注或准确率对照。它支持“较快形成调查材料”的定位,尚不能支持“已证明缩短真实事故恢复时间”。
最终报告将结构化发现转为对事件含义、影响、可能根因和后续动作的说明。对值班团队,更有用的验证是每个关键结论能否回到日志查询、时间窗口与具体证据,以及缺失证据是否改变了建议。项目提供 OpenTelemetry 追踪入口,有助于观察调用路径;但轨迹记录的完整性仍需和实际工具输出对应,不能只用模型写下的解释替代执行事实。
另一个实用边界是区分查询失败与没有证据。工具超时之后生成的“未发现异常”,与完整查询返回空结果并不是同一事实。基于该工作流进行评估时,应记录失败调用、实际覆盖的数据集和窗口,并检查最终报告是否保留这些缺口。这样才能判断一次快速报告究竟缩短了调查,还是把未完成的检索隐藏起来。
自动触发后的生命周期边界
当前 README 对自动化入口给出了很具体的限制。Webhook 默认最多三项并发调查,以监控器 ID 和窗口起点识别重复事件;忙时返回 503,让上游重试。运行状态与去重信息都在内存中,要求单实例,并避免宿主在请求之间停止。交互 Slack 模式的进行中任务同样不能跨重启保留,未回答的问题在 15 分钟后结束该次运行。
因此,增加副本并不只是吞吐优化:多实例会改变去重的作用范围,重启也会改变同一告警能否再次进入调查。这是从存储边界直接推导出的风险,不能把进程内去重理解为跨重启的恰好一次处理。需要更高可靠性的团队,应先明确重复报告、重试成本和恢复责任,再决定怎样扩展持久化与队列。
这份实现适合用作可审查的 AI SRE 参考:它把检索范围、人工确认、模型预算和报告产物放在明确的阶段里。最有价值的阅读顺序是先看四阶段流程,再看预算语义和部署限制。它提供了一个从告警到证据报告的起点;自动修复效果、诊断准确率和大规模告警风暴下的表现,仍需要独立验证。