Martha Lambert · incident.io · 2026-10-01 · 原文
incident.io 的实践说明,AI SRE 的工作量很大一部分在模型周围:历史事件回测、带证据的发现记录、避免打扰值班人员的消息判断,以及随环境变化更新知识。其调查过程会汇集多个来源、形成假设并尝试反驳。文章是团队的工程经验,不是可以直接外推到所有组织的效果基准。
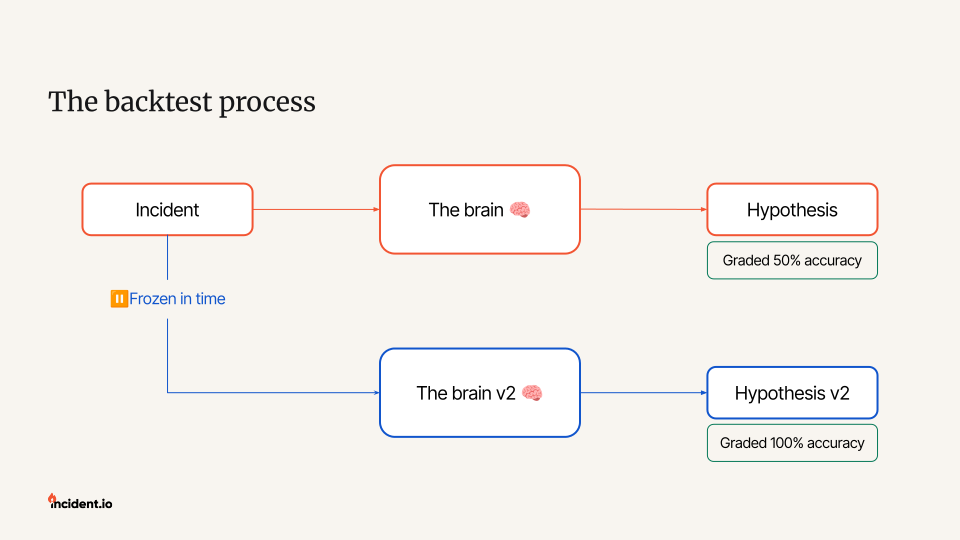
原文回测示意:固定事件输入比较两个版本;图中评分是示意,并非实验提升幅度。
把“能给出答案”改成“能维护一份调查状态”
一个有用的阅读视角是:故障调查并非一次问答,而是持续接收新观察、修改解释的过程。面向这种过程,输出长摘要很容易产生两个问题——新的文字看起来变化很大,却没有新增证据;旧假设已经失效,却继续影响后续判断。
作为工程推导,可以把发现记录拆成对象、时间范围、观察、推断、引用和状态。观察是数据中直接存在的事实;推断是连接这些事实的解释。新证据应该能够让一条推断降级、撤销或被替代,而不只是追加另一段文字。
这样做还有一个实际好处:值班人员可以检查“这次新增了什么”,不用每轮重读整篇报告。结构化状态不仅服务模型,也服务人与模型之间的交接。
回测必须回答“当时能知道什么”
冻结历史事件时,最危险的污染往往来自正确但过晚的信息。一个用于说明风险的例子是:调查代码版本取自事发前,但检索系统返回了事后修复说明。模型看似准确理解了故障,实际读取了答案。
可以给每类证据记录事件时间、入库时间和可见时间。回测不只按一个时间戳过滤,还要模拟当时的访问权限及数据延迟。参考标签则保存在另一侧,不能通过搜索索引、文档链接或工具输出绕回来。
将回测案例按服务、故障机制和时间分开留出,也比随机抽取几条事件更能检验泛化。若某个版本只在熟悉服务上改善,应把它视为局部结果,而不是组织范围内的能力提升。
通知是一项独立的系统能力
诊断正确,不意味着现在就值得发消息。重复通知、过晚通知和没有新信息的更新,都会占用响应者注意力。因此,调查质量与通知质量应该分别测量。
一个可检验的通知规则可以依次判断:是否有新证据、是否改变当前结论、是否影响下一步行动,以及是否已经有人提供了同样的信息。这里的建议不是让模型任意隐藏不确定性,而是用较短的消息说明证据变化和判断强度,把完整材料留在可追溯的记录中。
评价时,可以比较每次通知后的行动变化、重复率及人工纠正,而不只统计发送数量。越活跃的机器人不一定越有帮助。
记忆也需要失效机制
调查系统记住有效查询,可以减少下一次的搜索成本;但服务重命名、字段迁移和权限变化都会让旧经验失效。工程上应为记忆保留适用范围、来源版本和最近验证时间。复用前先检查前提,比把历史成功结果当作永久知识更可靠。
这篇文章最适合拿来检查自己的AI SRE原型还缺哪些环节:能否解释一次判断如何形成,能否回退错误结论,能否发现旧知识已经过期,以及能否让人快速接手。这些都能形成具体测试,不必等到一次真实大故障才知道系统是否可靠。