Cloudflare 的事故复盘展示了一条很具体的可靠性漏洞:压测检查了状态码和吞吐,却没有确认返回内容来自当前请求。系统返回 HTTP 200、保持流式输出,仍可能读取上一位用户留下的 KV 页面。这里失败的是请求隔离和状态归属,正常的接口形态没有提供保障。
原文:Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang · Cloudflare · 2026-10-26。
影响范围有明确边界
Cloudflare 报告,问题影响其 Workers AI 的 @cf/zai-org/glm-5.3,窗口为 2026 年 8 月 27 日至 9 月 9 日,共识别 155 个受影响响应,全部对应超过 681,280 token 的提示。公司称没有其他 Workers AI 模型受影响;剔除自身与研究者测试后,观察到的时序和数量符合正常长上下文使用,未发现蓄意利用证据。这是调查结论,不等于证明从未有过利用。
9 月 8 日收到研究者报告,次日复现并停用模型;修正配置和引擎后于同日恢复。影响窗口、恢复日期与 10 月的公开披露日期需要分开看。
两个看似独立的假设在交接处相遇
模型配置允许 1,048,576 token 上下文,prefill KV 池却只容纳 681,280 token。池大小取决于加载权重后剩余显存,并非与上下文长度自动一致。Cloudflare 上线前知道差异,但因为长请求返回成功,误以为引擎会妥善处理。
SGLang 实际将过长请求标记为拒绝,并用单 token 占位符让它走完内部批处理。在单节点路径上,最终能返回错误;分离模式的准入检查却只看请求是否“完成”,没有正确识别“待拒绝”。于是占位符仍执行 prefill,并发出传输完成信号。
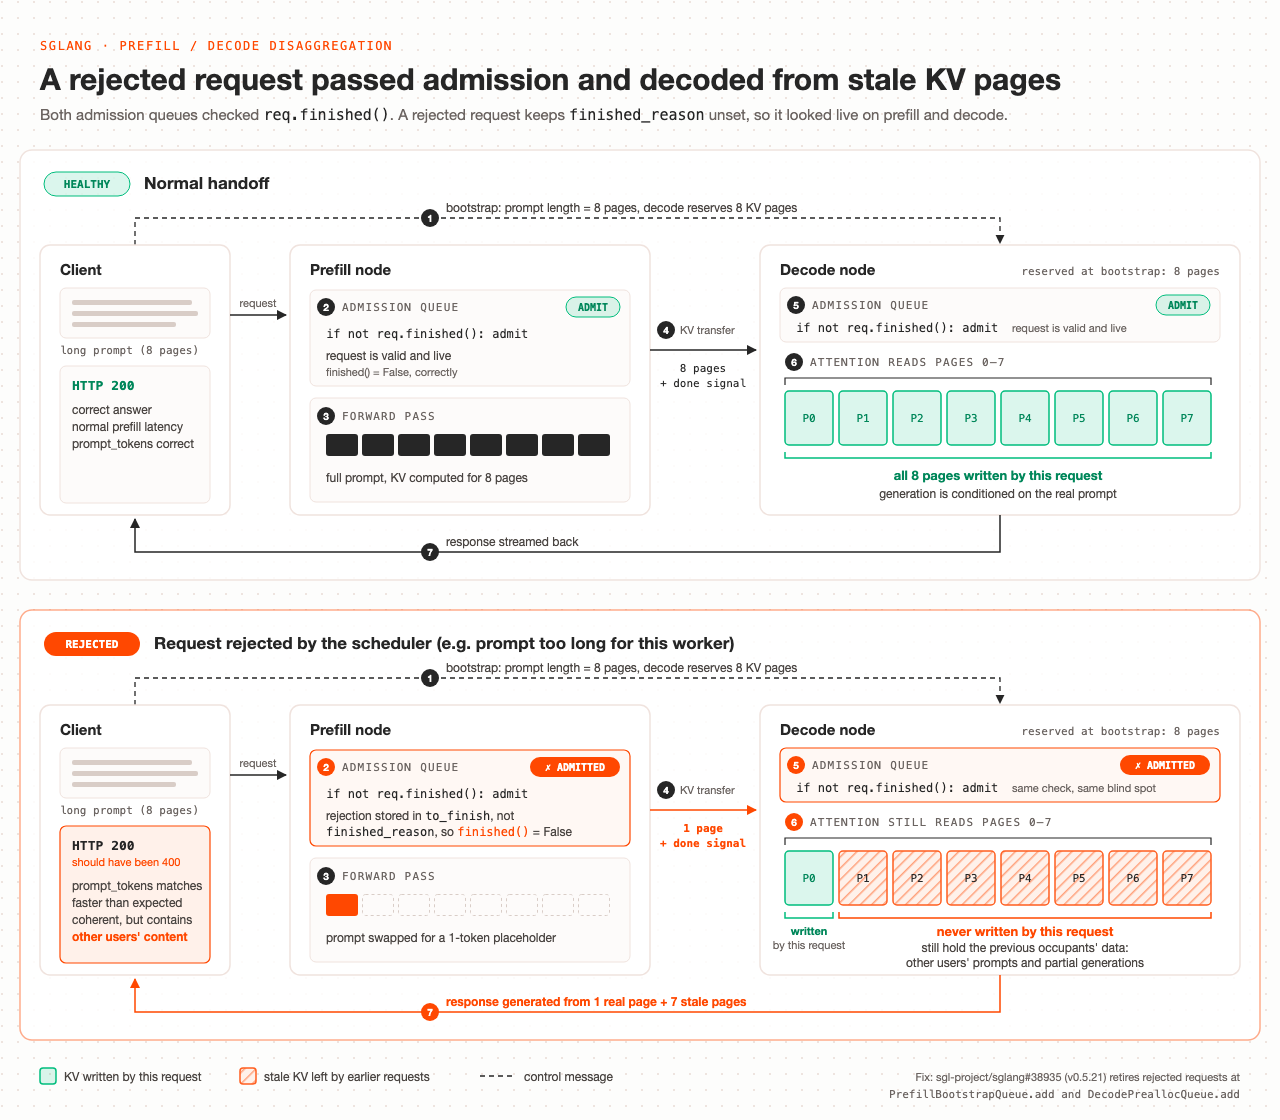
上半部完整写入八个示例页面;下半部只写入一个页面,却让 decode 读取全部预留页面。
decode 已按原提示长度预留多页,却只收到占位符对应的少量 KV。它把完成信号理解为整个请求已准备好,attention 随后读取剩余旧页面。由于页面复用时不预先清零,旧内容可能来自其他用户。报告中的八页图只是机制示例,不能当成全部事故请求的真实页数。
容量检查和引擎修复需要同时存在
Cloudflare 调整配置,使 prefill 池约能容纳 204 万 token,并修复拒绝路径,在 bootstrap、分配或 KV 传输之前返回原错误。前者让合法长请求不再撞上该容量边界,后者保证其他拒绝条件仍然安全。仅增加显存池,无法保证后续权重、量化或并行配置变更后仍然安全。
恢复前的验证同时使用研究者复现和 canary 标记测试;部署检查改为直接读取运行引擎的 KV 池容量,与上下文上限比较。最值得借鉴的是验证对象变化:从“请求成功”转为“拒绝是否终止交接、页面是否确由当前请求填满”。
同一类风险,还有不同修复路径
报告另述异步 RDMA 迟到写入、单节点 offload 与页面释放竞态。它们和此次占位符问题都破坏页面归属,但不是同一个触发机制。延迟释放、有限传输批次和完整性检查针对这些相关风险;未来的逐页标签与形式化验证仍属后续工作,不能当作已经部署的全面证明。
对 Agent 基础设施,这起事故说明长上下文不仅是容量测试,还应是隔离测试。错误路径、取消路径和正常路径共用缓存池时,状态机里每一种“结束”含义都必须落实到下游:不再计算、不再写入、不再读取、可以重新分配,是不同的条件。