Cloudflare 的代码审查案例说明,Agent 成本不只是模型单价的问题,还取决于上下文如何组织、一次工作需要多少轮调用,以及这些调用是否产出有效发现。团队报告平均审查费用从 2.43 美元降到 0.77 美元,约省 68%;但不同审查角色的质量变化并不一致,理解这一点比记住降本比例更重要。
原文:Cutting our inference bill by 68% by being obsessive about optimization
Ryan Skidmore · 首发:2026-10-19
高命中率为什么还会越来越贵
多轮审查反复携带之前的上下文。即使大部分 token 能从缓存读取,只要上下文与调用次数一起增长,账单仍会上升。文章把注意力转向每个会话的第一次请求:会话内部经常命中,与不同仓库的新会话能否共享前缀,是两个不同的问题。
原来的系统把公共提示和工作目录、日期等环境信息放在同一块,缓存断点位于块末尾。于是公共部分虽然相同,却没有单独成为可复用的缓存边界。调整后,稳定内容先结束一个块,变化内容再跟上;前面的工具描述也必须保持一致。
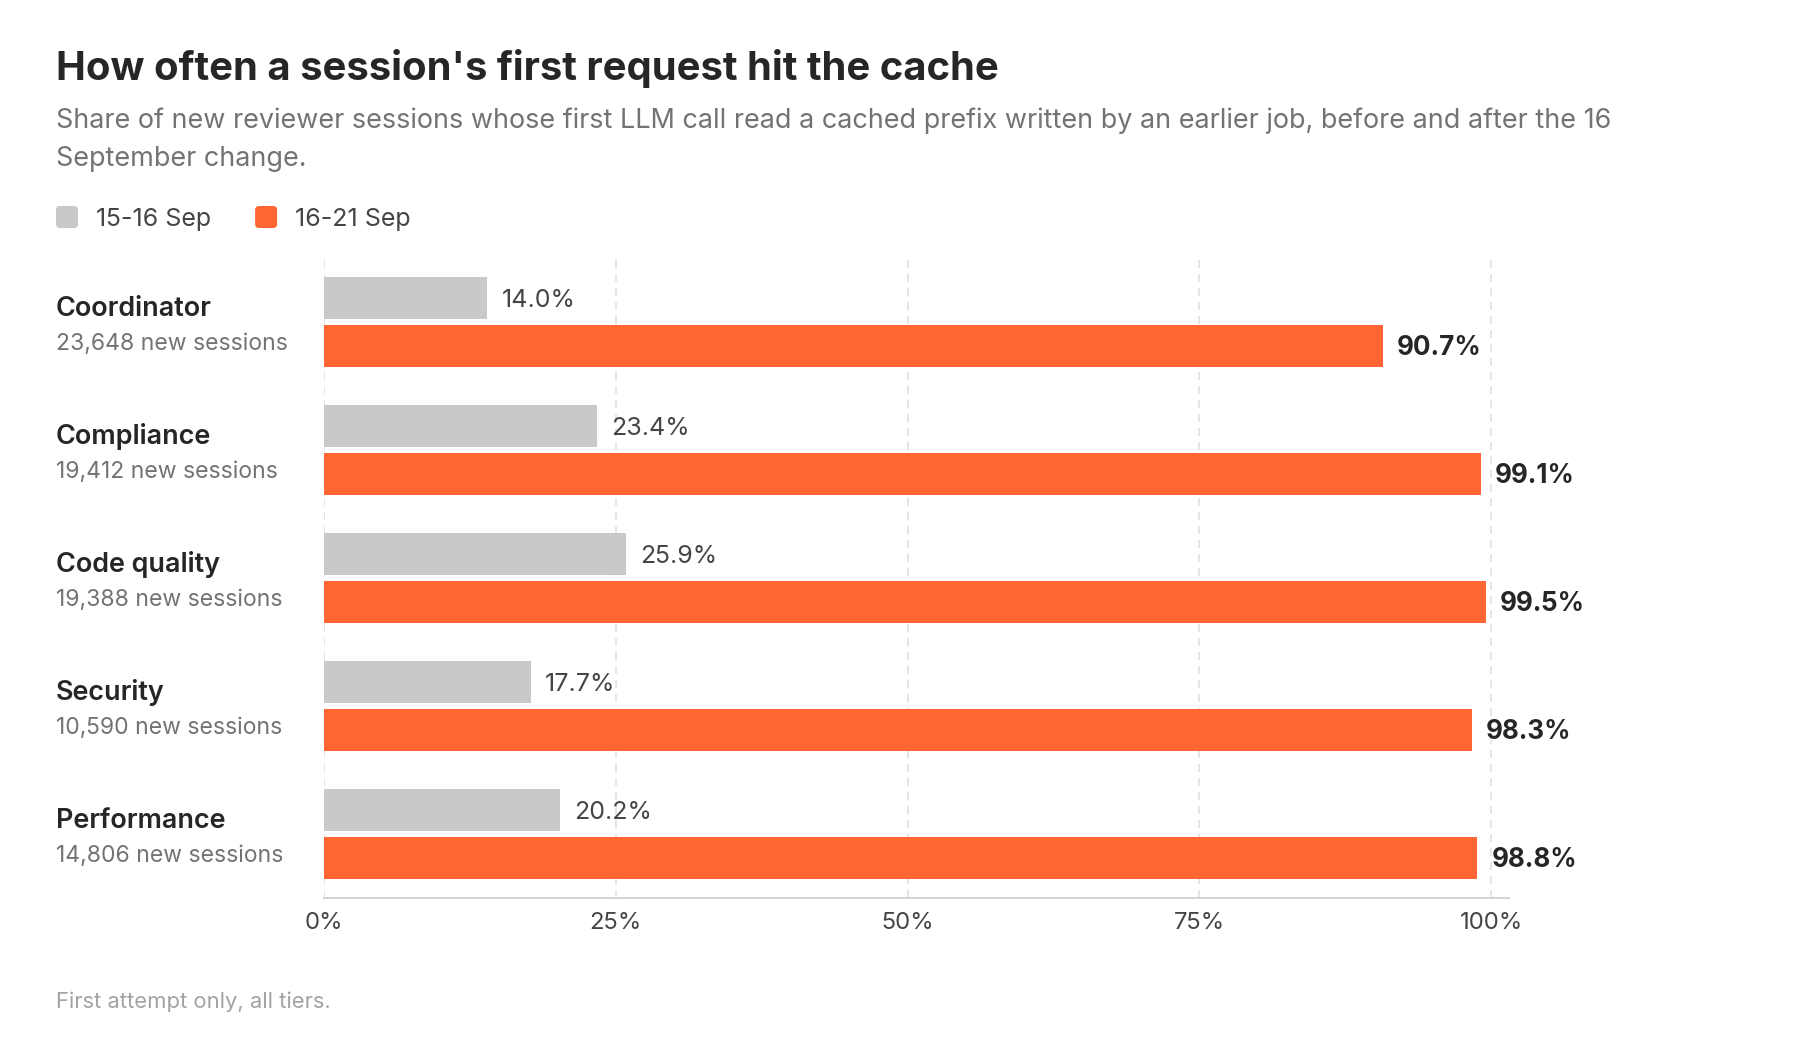
读图:灰色为修改前,橙色为修改后;比较的是所有层级首次尝试中,会话第一条请求复用旧缓存的比例,不是整个会话的 token 命中率。
这一机制的可迁移价值,是检查真正发给服务商的字节。 源代码中的提示模板相同,不代表渲染后的请求前缀相同。若要定位类似问题,可以分别观察首请求与后续请求、公共前缀长度与实际读取量。把所有 token 合并成一个命中率,会掩盖缓存边界设计的问题。这是对案例的工程推导,并不要求所有系统采用相同提示布局。
缩短工作链,也会减少反复读取
原文还描述了移除不可用工具、合并读取、跳过无新增内容的重复审查,以及发布结果后及时停止等修改。共同作用是减少没有必要的后续轮次。一次无效调用的代价不只是它自己产生的输出,还包括下一轮重新携带和处理已有上下文。
这提示一个更合适的成本单位:完成一次有用审查的总成本。单次 LLM 调用变便宜,如果诱发更多重试,整个任务未必更便宜;单次输入稍长,如果能消除多次往返,也可能更划算。评估时需要同时记录调用数、输入与输出量、缓存读写量,以及任务完成状态。
共享前缀还存在并发取舍。文章让多个审查角色共用开头的上下文,并协调首次写入与随后读取。由此可以推得,缓存优化有时会把完全并行的启动变成短暂依赖链。是否值得等待,应比较节省的重复计算、等待时间与失败传播;不能只最大化命中率而忽略审查的完成时限。
降低 effort 不是纯性能开关
团队同时调整模型和 reasoning effort。这里最需要保留的结果是质量边界:代码质量审查最终选择 high effort,而性能审查留在 medium 时,模型评审估计重要发现减少约 64%;安全审查也有下降迹象,但差异未达到统计显著。整体平均成本下降不能替每个角色证明质量保持。
从决策角度看,应把模型与 effort 当作任务策略,而不仅是资源设置。不同角色的漏检代价、证据搜索深度和可容忍延迟不同。一个便宜且适合格式检查的配置,不一定适合发现跨文件性能问题。统一下调所有角色,容易把局部节省变成难以察觉的能力损失。
这也解释了为什么“发现数量少了”不足以判断退化。减少的可能是重复、错误或夸大严重性的报告,也可能是真问题。比较前后的有效发现,需要知道哪些问题应当被找到,而不只是统计发出了多少条评论。
怎样理解文章的质量证据
Cloudflare 使用作者是否修改被指出的代码行,以及对 657 条发现的盲评来辅助判断。盲评由不同提供商的两个模型进行,分歧交给第三个模型;这些是可见发现的质量信号,并非对所有遗漏问题的完整测量。文章还说明部分分组只有 35–66 条发现,最新观察窗口仅一天。
作者改了代码,可能表示报告有用,也可能是顺手修改;没有修改也不能直接判定报告错误。模型评审看到 diff,有助于比较已报告问题的合理性,却无法自动建立整个仓库的真实缺陷集合。因此,文中对 high effort 代码质量审查的支持,应理解为多种有限信号相互印证,不能扩展为所有审查任务都无损。
同样,代码修改与模型配置变化交错发布,逐次归因依赖前后工作时段比较。文中的分项节省并不是严格控制实验,也不应强行相加为精确的因果账本。更可靠的阅读方式,是把它们当作定位大头与安排下一轮实验的线索。
把成本、延迟与覆盖一起观察
作者报告总体审查中位耗时从 4 分 09 秒降到 1 分 32 秒。减少往返能同时改善时间和费用,但这种一致改善不会永远成立:扩大上下文、增加并行角色或提高 effort,都可能改变质量与资源消耗之间的关系。
工程上可以分两步推进。先消除与任务语义无关的浪费,例如无权使用的工具和已取消任务的残留工作;再对模型、effort 与跳过规则做有质量参照的比较。前一类改动也要检查行为边界,后一类尤其要按角色和风险层级观察,不能只看全局平均。
还应给跳过规则留下可审计的原因。一次重复审查被跳过,是因为相关文件没有变化,还是因为规则没有识别出间接影响,两者的质量含义不同。将节省与触发条件一起记录,才能在漏检出现时还原取舍。对缓存同样如此:命中的是哪些稳定上下文、是否仍适用于当前任务,应与节省多少 token 一起理解。
推荐把缓存边界和质量讨论两节连起来读。 这篇文章的进展,是展示如何将 Agent 账单还原为可解释的调用结构,并把优化后的能力变化重新纳入判断。适合迁移的是测量方法与分角色实验思路;68% 是该系统特定时期的综合结果。