Agent 推理服务的压力,往往来自两次模型调用之间。一个编码任务携带很长的初始上下文,调用工具后追加结果,再次发送历史;子 Agent 又可能共享前缀并行工作。GPU 暂时没有生成 token,不代表会话不再占用 KV cache。Dynamo 这次进展值得关注之处,是让会话身份贯穿路由、准入、观测与缓存策略,把优化单位扩展到完整执行链。
原文:Session-Aware Agentic Inference with NVIDIA Dynamo
Ishan Dhanani、Jamie Li、Karen Chung · PyTorch Blog / NVIDIA Dynamo · 发布:2026-10-08
会话身份把零散请求连起来
单请求路由能判断哪个 worker 已缓存更多输入前缀,却难以回答另一组问题:这个 Agent 是否仍在运行、工具调用后何时回来、它与哪些子任务共享上下文、接纳更多会话会留下多大的常驻工作集。原文用稳定的 session_id 串起同一执行链,用可选的 parent_session_id 表示父子关系,各优化模块自行选择消费这些信息。
Dynamo 能映射 Claude Code、Codex、OpenCode 已发送的身份 header;自定义框架可以提供 X-Dynamo-Session-ID 与父会话 header。这里传递的是关联信息,不能把同一会话直接等同于缓存命中。真正复用仍依赖具体前缀与缓存状态;父子身份的价值在于帮助系统判断哪些状态可能再次被使用。
把工具等待也放进性能证据
启用请求 trace 后,Dynamo 在响应流结束时记录会话字段、输出 token 数、结束原因、KV 指标、工具名和回放信息。默认不记录提示、响应或工具调用内容;输入长度和块序列哈希用于保留前缀共享关系。这样,一次工具等待可以与随后的缓存驱逐和重新 prefill 联系起来,而非只看到模型调用变慢。
同一轨迹可以交给 AISimulate 做无 GPU 的离线配置比较,也可以由 AIPerf 向真实端点回放。前者探索 worker 数量、路由与容量,后者验证实际延迟和吞吐。工程上需要区分“同一请求图的服务表现”与“Agent 重新决策后的表现”:回放保持已有流量结构,不会证明策略改变后工具选择与任务结果也相同;内容默认不落盘,也不代表元数据完全没有敏感性。
在工具边界调节准入
缓存抖动来自工作集超出容量:驱逐一个仍活跃会话的前缀,下一轮就可能重复计算。Dynamo 将 ThunderAgent 的调度思路集成进原生 Rust 插件,直接持有 KvRouter,并从响应中的实际 prompt 与 completion token 数跟踪工作集。它同时维护两个状态维度:正在推理或正在调用工具,以及活跃或暂停。
内存压力升高时,调度器逻辑暂停处于工具阶段的会话,让引擎有机会回收它们的 KV;它不抢占已经开始的 decode。如果没有可暂停的工具阶段会话,就标记较小的推理会话,在下一个工具边界暂停。原文给出的默认控制参数是:利用率达到 0.95 后暂停,目标降到 0.80;0.80–0.95 区间提前降低优先级;低至 0.85 才触发恢复。
恢复按 token 数从小到大装入容量,并计入每会话缓冲量;恢复请求得到一秒优先级提升,另有 30 分钟强制恢复上限。迟滞避免在阈值附近反复切换,但这些参数并非适合所有服务的常数。暂停把部分等待转移到会话层,小任务优先也意味着必须同时观察长会话的完成时间。工程含义是,用少一些同时活跃的工作集,争取少做重复 prefill;它没有增加物理缓存容量。
结果要连着硬件与基线读
作者在单节点八张 H100、两个 TP4 MiniMax-M2 副本的 SWE-bench 配置中报告,相对仅 KV 路由,吞吐约提高 12%–16%。另一组 Uni-Agent SWE-Bench rollout 使用八张 H20-3e、Qwen3-Coder-30B-A3B-Instruct,与 VERL 默认 Global LB 比较:低并发 CC32–128 时大致持平,高并发 CC384–512 时后者明显退化,而会话调度维持较高吞吐;全并发扫描的前缀命中率高于 94.5%。
原文对中并发提升的文字百分比与曲线标值并不完全对应,因此更稳妥的阅读结论是高并发下的退化趋势得到缓解,而不是给出跨配置的统一倍率。上述测量面向服务吞吐,不能推成任务正确率提高,也不能把不同硬件、模型和比较基线拼成同一条扩展曲线。会话完成延迟、暂停时长及公平性仍是判断交互体验所需的补充指标。
外部缓存要按完整页计入收益
工作集进入 CPU 或共享存储后,只看 GPU 命中会漏掉可取回的状态。实验性的 shared-pool indexer 消费 Mooncake 的 Store / Remove 事件,依据 TP/PP 布局、K/V 张量等,将逻辑页映射到物理对象;所需对象全部存在时才认为该页可复用。路由使用本地索引中的连续命中区间,无需在热路径逐项查询远端存储。
同时,FlashIndexer 计算 worker 原生层级的前缀重叠,共享池只对设备前缀之外的命中给予额外信用,避免同一 GPU 命中重复计分。最终评分还结合层级权重与实时负载。工程上,“存在可复用页”与“从那里取回更快”仍是不同判断:移动成本、并行布局和缓存新鲜度都会影响收益,信用需要服务实际成本模型。
从工程设计看,这种索引还增加了一层维护成本:块存入、移除以及会话分支变化都要进入可用的关联视图。评估时应把索引更新开销与缓存节约一起计算,区分“知道远端存在”与“已经搬到可执行的位置”。这也说明,把共享缓存纳入评分只是第一步,最终仍要由引擎落实状态移动和资源检查。
路由器表达意图,引擎决定执行
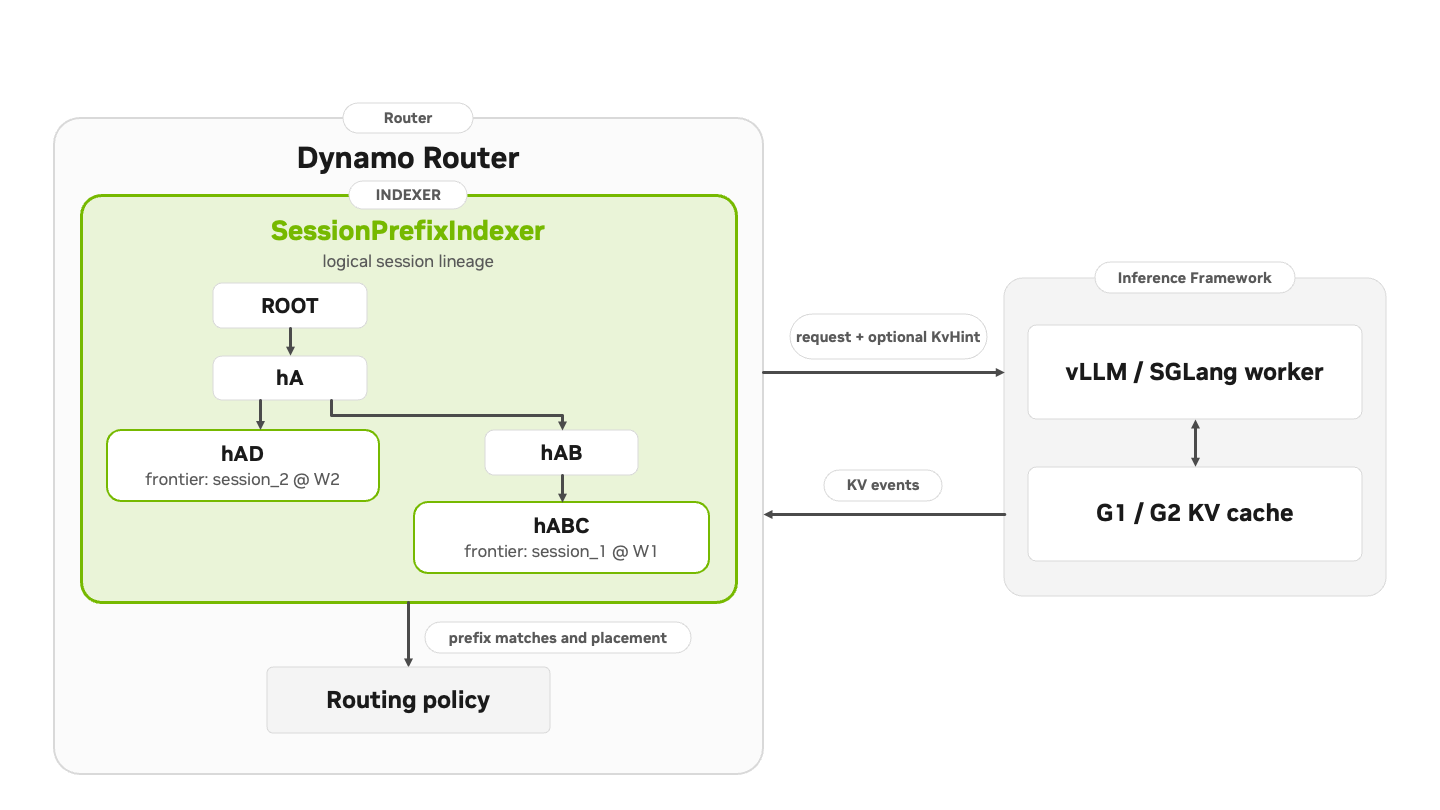
读图:左侧树记录共享前缀、会话分支与块位置;右侧 worker 上报 KV 事件。路由策略利用这些关联信息,随请求向引擎发送可选提示。
Session-Prefix Indexer 用 radix tree 关联会话谱系与 KV 块,由引擎 Stored / Removed 事件及 FlashIndexer 命中持续更新。建立关联后,路由器才有条件提出“工具等待时下移”“子任务结束前预取”之类策略,而不必把整个会话调度逻辑塞进每个推理引擎。
拟议的 KvHint 接口包含 Share、Prefetch、Demote、Pin、Retain,分别表达共享、预取、下移、限时固定和保留偏好。提示是软约束,引擎可以裁剪、延迟或忽略;不发送提示的负载沿用原行为。原文称 Share 已有基于 HiCache 的可工作实现,Prefetch 与 Demote 计划在其基础上继续推进,其他策略也不能据此当作全部可用。
阅读重点是三个成熟度层次:会话标识和准入调度、实验性的外部共享池感知、继续演进的缓存提示接口。 这项工程进展把“缓存在哪儿”与“谁还会回来用”放到同一决策中。它最适合长上下文、多轮工具调用和较高会话并发;对几乎没有前缀复用或本就不受容量约束的负载,不能期待同样收益。