推测解码的收益不只由草稿猜得准不准决定。多猜几个 token 会增加目标模型一次验证能接受的长度,也会增加起草、验证和状态管理成本;小 batch 时划算的树,遇到繁忙服务可能反而拖慢。EAGLE-4 最值得关注的变化,是把这些成本纳入每轮起草决策,并减少草稿输出词表的计算。它让同一个 drafter 在不同条件下调整工作量,但当前实现仍有明确的负载与引擎边界。
来源:EAGLE-4 Team / Eagle AI
原文:EAGLE-4: One Flexible Drafter for All Batch Sizes and Hardware · 论文 · 发布版支持矩阵。项目公告日期为 2026-10-20;以下发布版数据使用当前 0.1.1 文档口径。
起草树为什么需要成本模型
传统动态树按预测置信度寻找更可能接受的分支,却不能仅凭概率知道多展开一层是否值得。EAGLE-Harness 用硬件、batch、上下文长度和验证宽度对应的延迟表,为额外起草与验证定价;草稿路径概率则近似提供新增接受 token 的收益。每轮主要决定是否继续加深、多少候选送去验证,以及当前负载允许多宽的分支。
论文把局部选择概括为新增收益与新增成本的比值:
A 是估计接受量,C 是延迟成本,阈值随决策条件变化。轻负载可以保留较深较宽的树,重负载更倾向短链;更深分支的置信估计也更不可靠。自回归 drafter 的价值在于,可以在下一步尚未计算前停止,避免已经生成整个并行块后才丢弃后半段。这里优化的是收益/时间,而不是孤立追求接受长度。
先粗筛词表,再精确算候选
小草稿模型也可能被输出 LM head 拖慢。EAGLE-4 用低秩头遍历完整词表、找出候选,再用原始全秩头计算候选的精确 logits。低秩部分负责找到值得考虑的 token,而不直接作为最终概率估计器。与永久截断词表相比,它允许不同上下文选择不同候选;代价是候选召回质量仍会影响草稿效率。
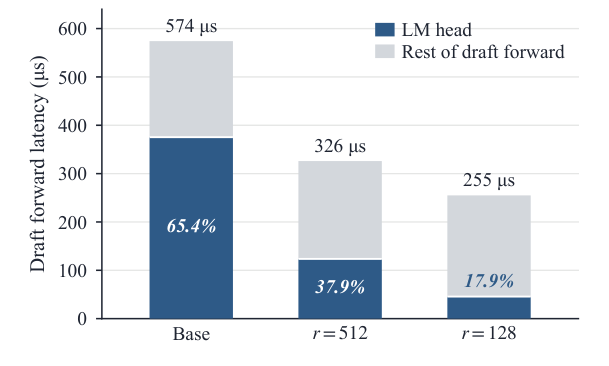
蓝色是 LM head、灰色是其余起草计算;低秩候选筛选减少输出头成本,但图中不是完整服务延迟。
论文展示的单次草稿前向中,完整 head 占 574 微秒总延迟的 65.4%;rank 512 与 128 的方案把总延迟降为 326、255 微秒。这个分解说明优化发生在哪里,不能直接把微秒减少比例当作整个服务的加速比例,因为目标验证、调度和采样仍在路径上。架构优化与动态预算是互补关系:前者让每次提议更便宜,后者控制做多少次提议。
发布版数字必须带上引擎与并发
项目论文与已发布软件的测量不是同一张成绩单。0.1.1 README 汇总的是 Qwen3.8-27B、4 张 NVIDIA B300、温度 0、SPEED-Bench 客户端,相对同一引擎关闭推测解码的吞吐比:
| 引擎 | 1 个请求 | 客户端并发 8 | 客户端并发 64 |
|---|---|---|---|
| SGLang | 3.42× | 2.09× | 1.39× |
| vLLM | 2.83× | 1.72× | 1.14× |
| TokenSpeed | 3.09× | 2.02× | 1.41× |
这些是各引擎专属配方,不能据此直接排名引擎。客户端并发还可能包含排队请求,不等于 GPU 同时运行的 batch,必须连同支持矩阵里的 running cap 阅读。官方社交公告中的 961.6 tokens/s 也不能替代这些版本化行。AMD MI355X 的结果单列:SGLang、单卡、并发 8 和 32 分别为 2.07×、1.56×,不是所有 ROCm GPU 的通用结论。
“保持目标分布”的算法条件与实现条件
正确的推测采样由目标验证和拒绝修正维持分布;greedy 模式则沿用目标模型的选择。论文特别处理了一个容易忽略的问题:若根据本轮已经采样的 token 决定停止深度,会引入选择偏差。因此正温度路径在开始一轮前,根据上一轮信息固定该轮深度。
软件仍有精度与路径限制。当前文档报告 vLLM TP4、并发 64 的 greedy 对照中存在一处超过其 fp32 检查规则的差异,仍在调查;温度 1 的分布测试也只覆盖指定采样参数。有限测试与理论分布保持不是同一种证据。实际阅读时应同时检查目标验证方式、数值容差、采样设置和引擎版本,而不是把“输出一样”理解为任意 GPU 与 batch 下逐 token 恒等。
高负载下,自动调节还没有消除退化
最关键的限制来自项目自己的 known limits:SGLang 在 running cap 512、TP4、默认树下,相对无推测在客户端并发 64/256/512 分别为 1.03×/0.74×/0.61×。高负载自动策略尚在验证,默认关闭;当前建议并发超过 64 时使用无推测路径。这与论文里另一套高并发比较并不矛盾,却说明论文方法的潜力不能直接视为发布版的全负载保证。
校准表也不能永久复用。模型、草稿、精度、TP、注意力后端或引擎变化,都可能改变成本;在线测量可追踪部分变化,但初始采样、未覆盖的上下文区间及内核编译会影响成本估计。保留真实工作负载的接受情况,比只跑几条启动提示更有解释力。原生关闭推测与保留草稿状态的零提议轮,也不必然具有相同开销。
这次更新推进的是可调的推测执行策略,以及把适配逻辑接入 SGLang、vLLM、TokenSpeed 的工程接口。最值得精读的是成本决策、候选 head 和逐格支持矩阵,它们分别解释收益、开销与资格边界。它对低延迟服务有吸引力;若关注拥塞时的吞吐和尾延迟,则应优先读退化条件,而非只引用单请求最高倍率。
怎样理解支持矩阵中的正确性标记
矩阵把逐 token 完全相同、接近并列的数值选择与 fp32 仲裁分开记录。这是有用的工程细节:浮点运算次序改变可能让几乎相同的 logits 交换名次,但这类解释仍须有明确误差规则,不能自动把所有分歧归为舍入噪声。vLLM 的并发 64 行因此带有限制标记,即使吞吐比仍大于一。把性能表与正确性表一起阅读,才能知道某个格子的证据到了哪里。
多个后端也不等于同一种运行能力。当前文档要求与 harness 匹配的引擎 hooks;TokenSpeed 的在线成本测量、原生无推测轮与部分采样路径尚未齐备,静态模式的启动检查不等于 serve 模式资格。仓库提供了统一入口,却没有把各后端所有行为抹平。
从系统设计看,一份更长的草稿只有在多接受的 token 足以抵偿额外时间时才有意义;当验证本身随 batch 变贵,最优决策甚至可能是不推测。项目显式列出退化区间,恰好让这一点可以核对。后续最值得跟踪的是高负载策略如何在独立启动、持续流量和不同上下文长度下保持收益,以及对应的正确性证据是否同时扩展。