MoE 服务扩容的难点,是让新 GPU 准备就绪时,旧 GPU 仍能处理请求。vLLM 这次把通信拓扑切换与 CUDA graph 的有效性放在一起处理:耗时准备在后台完成,真正暂停服务的阶段只负责交接。值得关注的是状态复用的条件,以及它怎样改变扩容对用户的影响。
原文:Achieving near-zero-downtime scaling in Elastic Expert Parallelism
Itay Alroy (NVIDIA) · 首发:2026-10-19
为什么不重启仍可能停很久
在数据并行 attention、专家并行 MoE 的部署中,改变 GPU 数量还会改变专家之间的通信关系。旧版 Elastic EP 已能在线改变规模,但初始化新 worker、传权重、准备通信与执行图仍会阻塞服务。把进程启动搬到后台,只解决了一部分等待:如果切换通信对象后,原来捕获的 CUDA graph 失效,留下来的 GPU 仍需重新预热和捕获。
这解释了一个容易误判的现象:机器已经加入集群,不代表可用吞吐已经增加。扩容包含资源分配、状态准备和服务激活三个不同进度。对容量规划而言,应分别观察它们,否则控制器可能把尚未可用的资源算进容量,再过早停止扩容。
把准备与激活分开
后台阶段让旧 worker 继续使用当前通信组服务,同时为目标拓扑建立连接、传送模型权重并准备执行状态。新增 worker 完成自己的初始化。短暂的提交阶段暂停调度器,激活已准备的拓扑,然后恢复请求处理。随后异步专家负载均衡继续调整专家分布,新 worker 可先承担 attention。
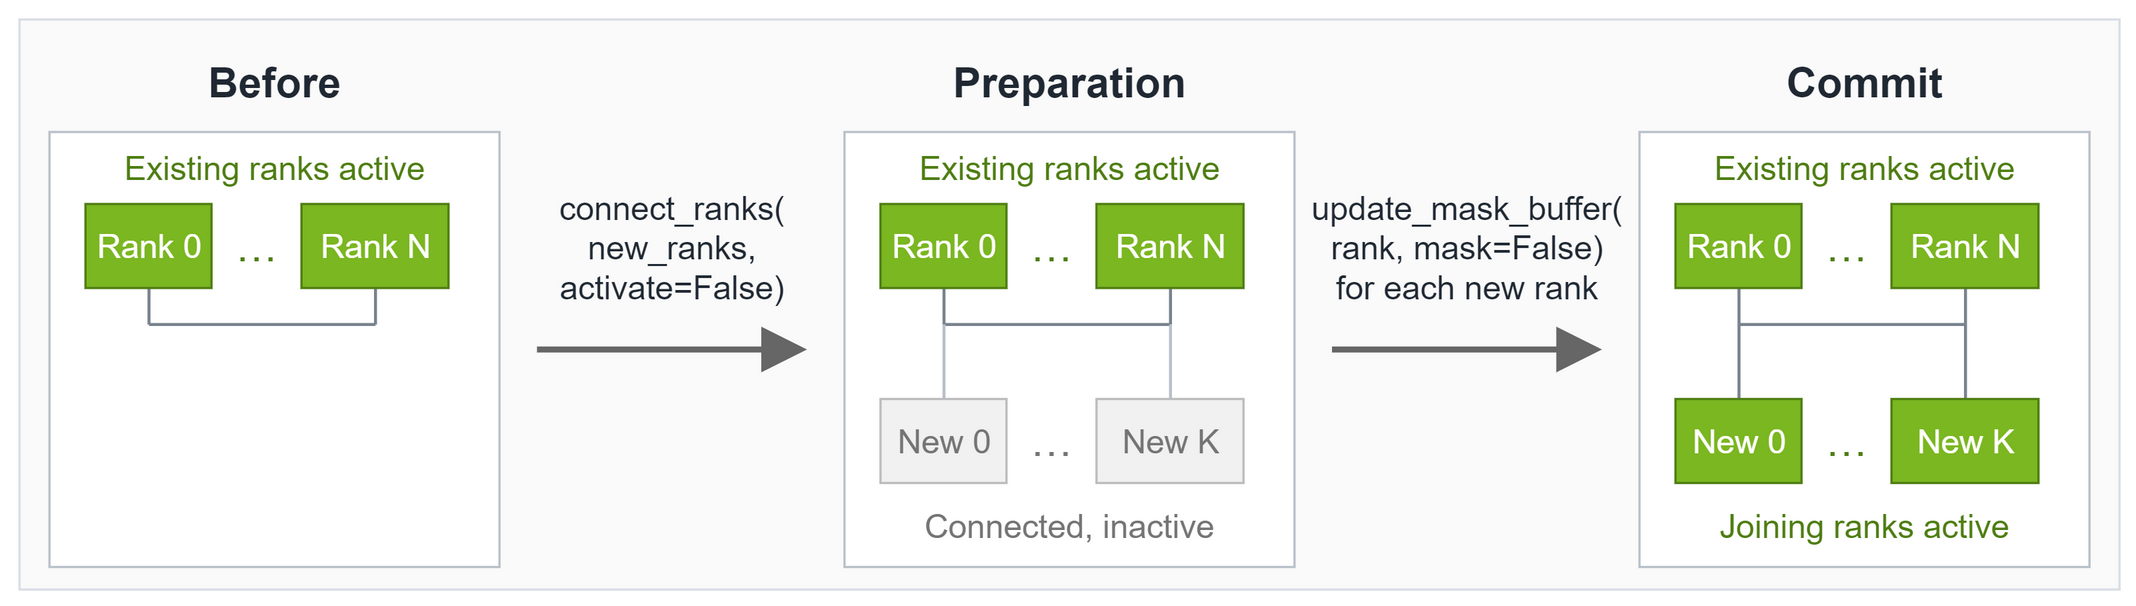
读图:左侧原成员持续工作;中间新成员已连接但被屏蔽;右侧提交后启用新成员,底层通信对象与缓冲区继续复用。
这里最重要的接口变化是 NIXL EP 支持原地改变成员。新成员可以先连接但保持屏蔽,提交时再启用;已有通信缓冲区、连接和 agent 得以保留。工程上可以把它理解为把“认识这个成员”与“让它参与当前计算”分开。若两件事同时发生,准备新成员时就更容易把正在执行的请求拉入一次全体同步。
CUDA graph 复用是一组约束
捕获的执行图记住了内核启动参数与张量地址。只保留通信对象的名字并不够:通信内核、相邻计算内核看到的地址、布局与启动配置都需要继续有效。文章描述的修改包括保留 fused-MoE 执行对象、工作区与 dispatch 输出,以及原地更新专家路由映射。
从这一机制可以推得,运行时弹性与内存布局设计不能分开考虑。一个按当前成员数重新分配张量的局部优化,可能让整个服务重新捕获执行图。对实现者而言,需要明确哪些数据可以改内容、哪些对象可以替换、哪些地址必须稳定;这比给扩容函数加一个后台线程更接近问题本身。
新 worker 又有不同的问题:它没有可复用的执行图。NIXL EP 在准备时允许它屏蔽所有远端成员,仅用本地 rank 完成预热和捕获;相应准备过程也不等待其他 worker 的 DP 批信息。这样,新机器的准备不会要求服务中的机器停下来配合。关键并非省略准备,而是消除准备对线上协同执行的依赖。
结果要同时看中断和总时长
作者在 GB200 上测试 DeepSeek V4 Pro,TP=1,DP/EP 从 16 扩到 20,再缩回 16;权重预先存放在共享 Lustre,内核编译缓存已热。下面列出阻塞方案与异步准备加执行图复用方案的结果。
| 操作与指标 | 阻塞准备 | 异步准备+执行图复用 |
|---|---|---|
| 16→20 GPU,服务中断 | 99.62 秒 | 0.82 秒 |
| 16→20 GPU,总时间 | 99.72 秒 | 92.34 秒 |
| 20→16 GPU,服务中断 | 56.25 秒 | 1.96 秒 |
| 20→16 GPU,总时间 | 56.21 秒 | 9.32 秒 |
0.82 秒表示交接造成的中断,新增容量并没有在 0.82 秒内准备好。 总时长与中断是分别测量的指标,表中阻塞缩容的微小倒置也不应被拿来推导阶段耗时。作者另用 11,391 个请求、约 8→16 请求/秒的升载场景测试,Elastic EP 完成全部请求,并保持滚动 p95 首 token 时间低于 5 秒。曲线使用 30 秒窗口,失败请求按 30 秒惩罚计入。
这些结果支持的是:在这套软硬件与流量条件下,可以大幅缩短扩缩期间的服务停顿。它们还没有覆盖冷编译、任意网络争用、所有模型组合或扩容中途失败后的恢复行为。原文的数值正确性检查也不能替代所有生产故障路径的验证。
对服务控制器意味着什么
以下是由机制得到的工程判断。首先,扩容触发仍需提前量:在容量紧张时才启动一个持续约一分钟以上的准备过程,旧容量可能先积累排队。其次,后台工作也使用链路和设备资源,应该把准备期间的延迟与正常期间分开观察,不能仅凭后台线程存在就认定干扰为零。
缩容还要求控制器知道何时才可以释放硬件。拓扑已提交、旧 worker 已不再承担工作、设备可安全回收,是相关但不同的状态;控制器与引擎的接口若只暴露一个模糊的“成功”,就难以安排后续资源操作。
还有一个容易忽略的区别:缩短正常交接窗口,并不自动定义异常交接的语义。准备阶段若某个新成员失败,系统应如何识别它没有就绪;提交之后若成员失联,哪些请求需要重新调度,这些问题需要具体实现和故障测试回答。正常扩容测量不能替代这部分证据,也不宜把“近零停机”读成任何情况下都不中断。
对后续评估,可以把一次扩缩拆成准备前、准备中、提交窗口和稳定后四段,分别比较吞吐与延迟分布。这样能区分暂停消失、排队转移到其他阶段,以及容量真正生效三种情况。尤其在请求长度差异很大的服务里,短请求的平均表现可能掩盖长请求是否在交接处停滞。
原地复用还有生命周期上的取舍:为了避免搬动地址,系统可能需要预先保留某些资源或限制可调整的布局。文章没有给出可泛化的额外内存成本数字,因此不能把保持执行图理解为免费能力。实际部署需要一起衡量状态稳定性、显存余量与可支持的扩缩范围。
推荐先读通信原地扩展和执行图保持两节,再看性能表。 文章最有价值的进展,是把“弹性”落实为一组可保持的执行状态约束。Snapshot 加速新 worker 准备,以及与 Dynamo、llm-d 自动扩缩控制器的集成,仍属于文中后续方向,不能算作这次结果已经具备的能力。