GPU 内核 DSL 的进展,只有进入常用算子路径,才会影响大多数模型使用者。FlyDSL 这次接入 PyTorch 的意义,是把面向 AMD 硬件精细调优的内核放进既有接口和后端选择过程。用户不必把应用全部改写成自定义算子,但仍需理解:不同算子通过不同路径接入,支持范围和性能证据也各不相同。
原文:Accelerating PyTorch on AMD GPUs with FlyDSL · AMD 与 Meta 联合作者,Xiaobing Zhang 等 · 2026-10-21
显式布局让优化靠近硬件
FlyDSL 在 Python 中表达线程、wave、数据 tile 与指令的映射,经 MLIR 降低到设备执行。作者用布局代数、LDS 缓冲、MFMA 指令和同步边界控制数据移动。与让编译器处理更多映射的抽象相比,这更适合数据放置本身就是算法关键部分的硬件模板,也带来针对架构维护和调参的成本。
例如 GEMM 的 half-tile interleaved 路径,在两组 wave 之间错开计算与加载,让已读取的一半 LDS 空间尽早接收下一批数据;attention 的 dual-wave 流水则将某个 KV tile 的 softmax 工作与另一 tile 的矩阵计算重叠。收益来自安排依赖和资源占用,不是把同样代码换一个语法就自动加速。
三条入口不能混为一谈
eager 模式下,符合条件的 RMSNorm 和 TopK 在可选运行时可用且启用时分派到 FlyDSL;其他输入保留已有实现。编译 GEMM 则由 TorchInductor 筛选候选,与 ATen、Triton 实测比较并缓存胜者。开启 FlyDSL 只是增加候选,最终仍可能选择别的内核。
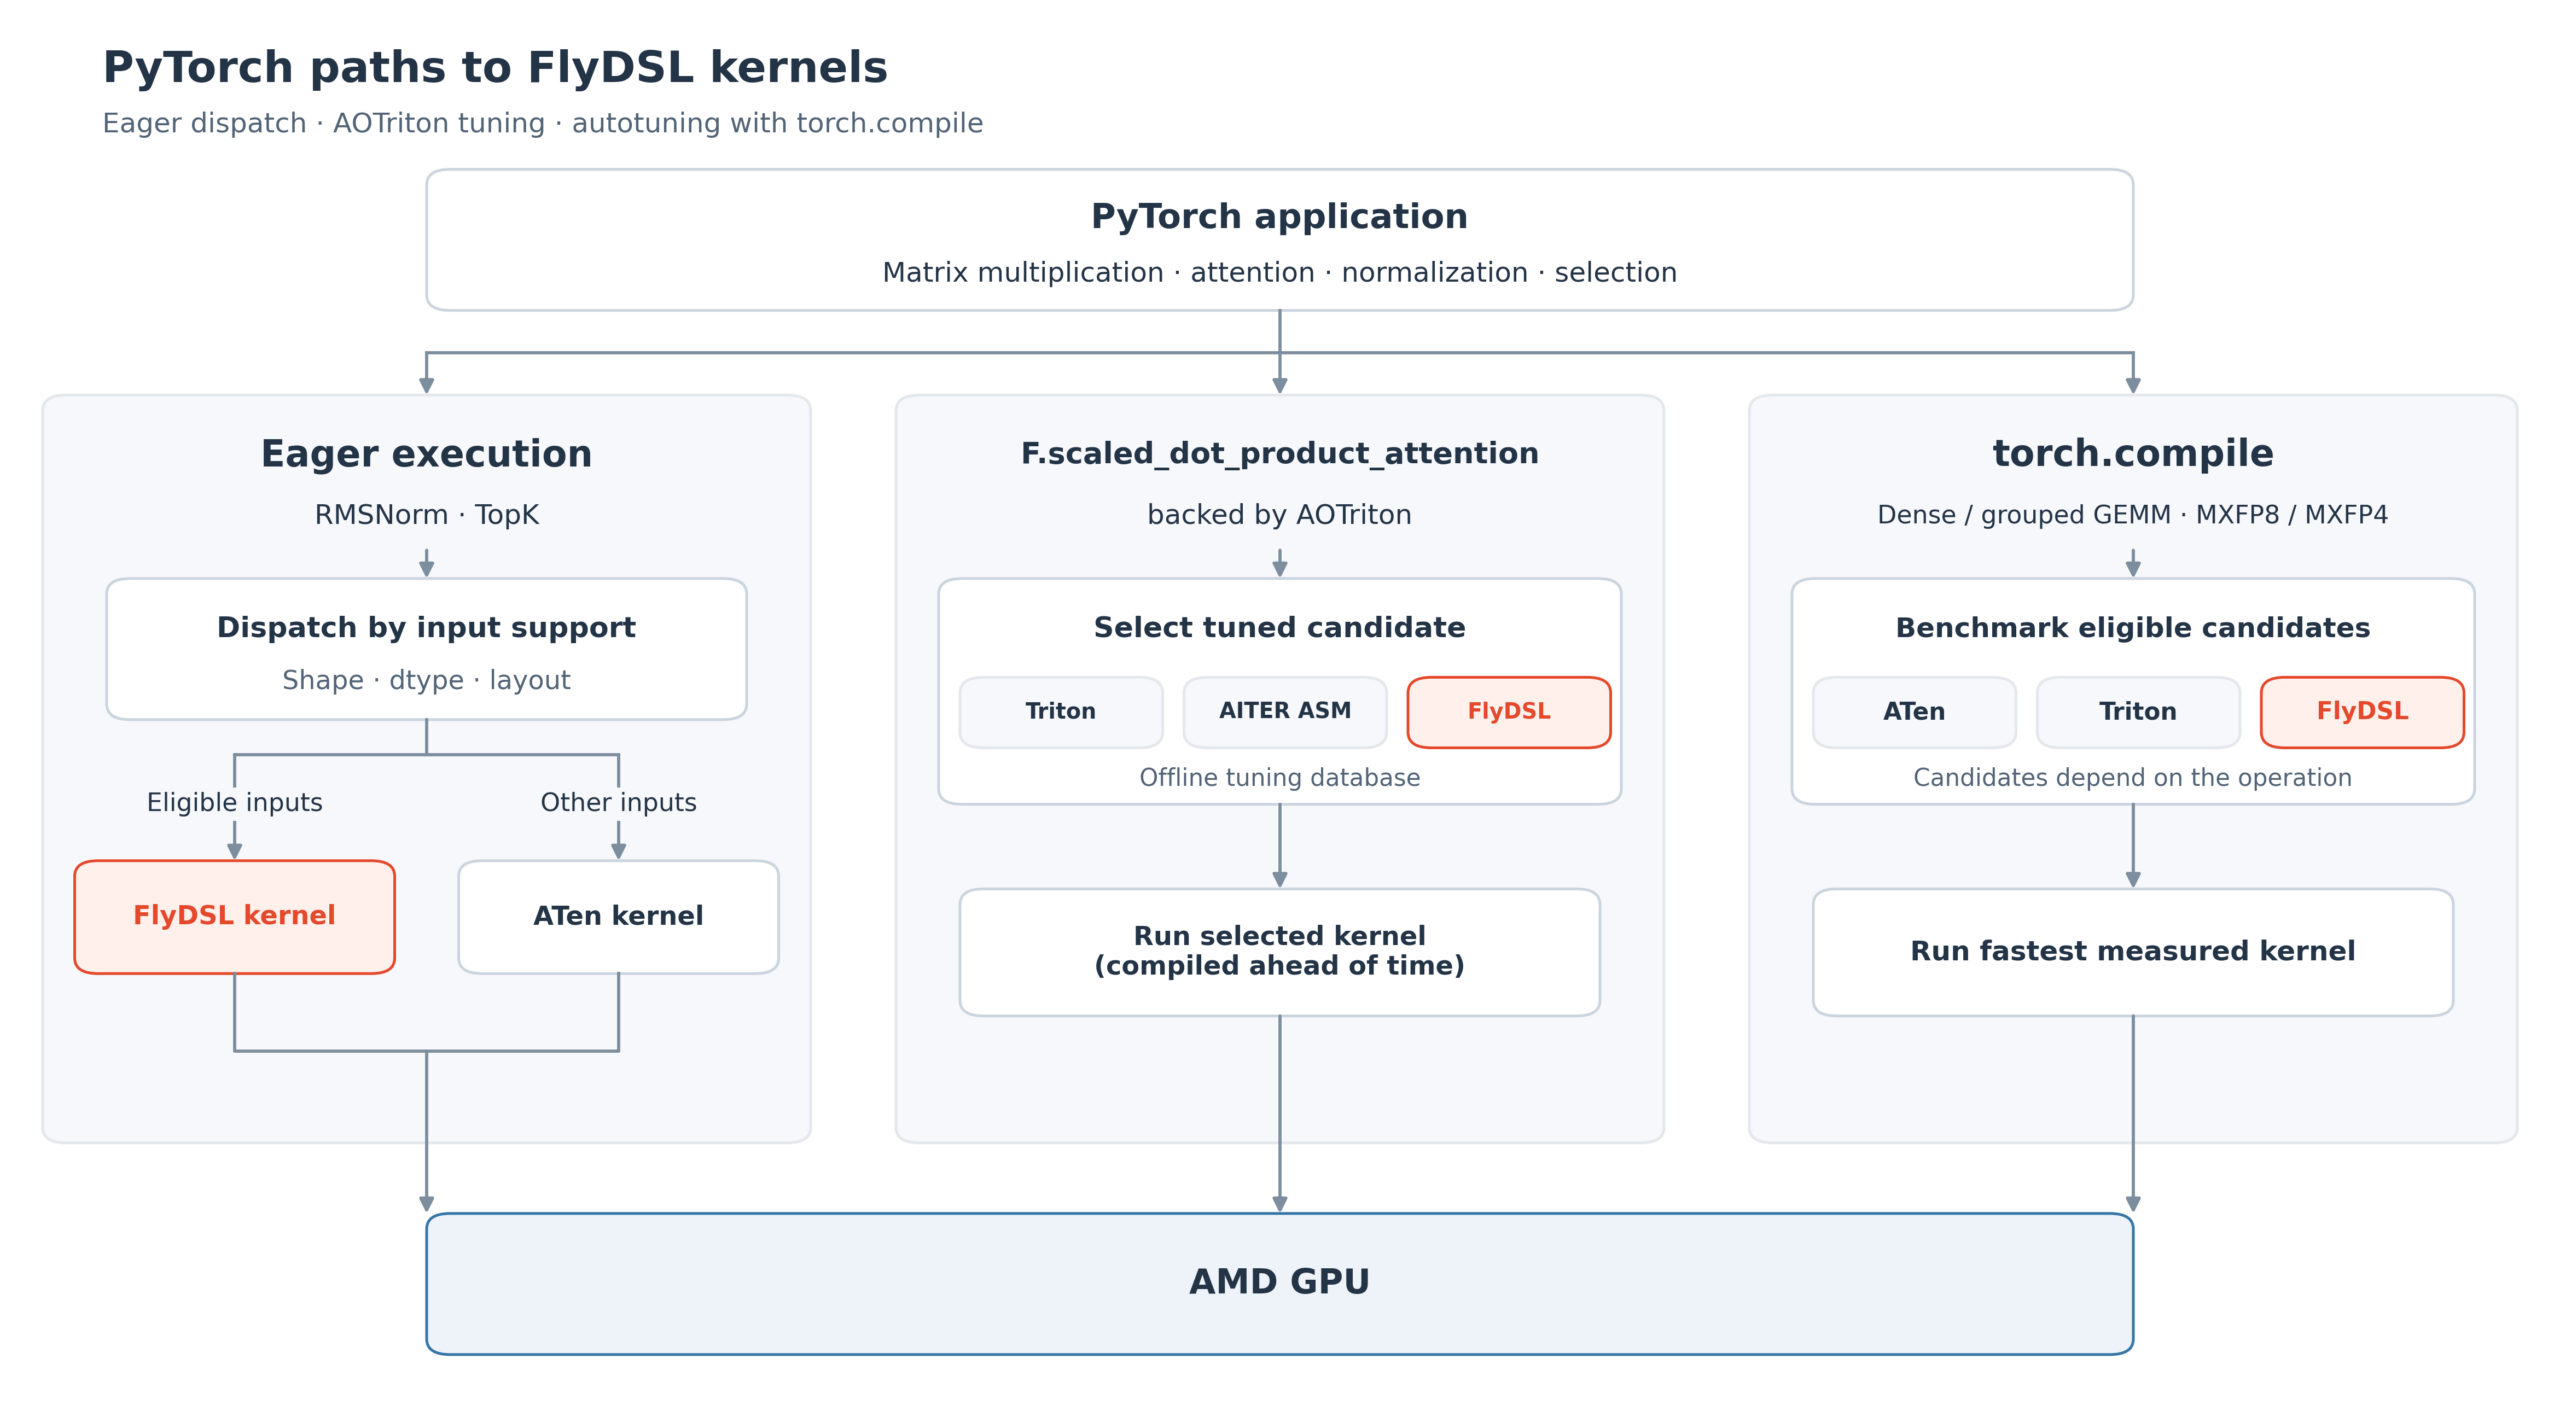
读图:左侧 eager 按输入支持范围分派,中间 SDPA 通过 AOTriton 调优数据库选择,右侧编译 GEMM 实测多个候选;三条路径最后都落到 AMD GPU。
SDPA 的入口又不同:AOTriton 捆绑预编译 attention 内核,并按调优数据库在 FlyDSL、Triton 和 AITER ASM 中选择。文章说明 AOTriton 0.14.2b 或更新版本的对应 PyTorch 构建即可走这条路径,不需要另装 FlyDSL 包。FlexAttention 是另一套 API 和编译路径,文中的当前集成不覆盖它。
性能数字必须携带基线
算子实验在 MI355X 上测量稳态执行,不计编译及初始调优。15 个 BF16 NT GEMM 形状的几何平均加速为 1.10 倍,基线是每个形状中 ATen 与 Triton 较快者;17 个形状的 MXFP8 和 MXFP4 则相对 ATen 为 1.58、1.68 倍。后两者从已经量化的输入开始,量化成本不在计时内。
24 个 grouped GEMM 案例相对 Triton 的几何平均为 1.20 倍,覆盖均匀、投影维度变化和不均衡专家负载。RMSNorm 相对 ATen 为 1.17–3.66 倍,其中峰值出现在特定非对齐维度,常见对齐形状的收益更温和。不能把不同形状的峰值当成一个模型所有层都会达到的结果。
TopK 的十个 small-K 案例在关闭确定性算法时,相对 ATen 几何平均为 4.82 倍,开启时为 4.02 倍。两种设置需要同口径比较;有相同数值的元素,其索引次序及 NaN 选择行为也可能与 ATen 不同。对依赖稳定索引的路由或评测代码,这些语义比单个速度倍率更重要。
整请求实验更接近服务,但条件很窄
作者在单张 MI355X、TP=1 上测试 Llama-3.1-8B-Instruct、Qwen3-32B 和 Llama-3.3-70B-Instruct,每请求输入 256 token、固定输出 512 token,并发 8–256。基线与处理组保持相同服务配置和每模型 KV cache,只改变 Inductor GEMM 候选列表。
BF16 的整请求峰值加速为 1.13 倍,来自 8B 模型;32B 峰值为 1.06 倍,70B 多数处于 1.79% 测量噪声范围。BF16 使用至少两次 ABBA 交错重复的中位数。MXFP8 与 MXFP4 的最高整请求结果为 2.04 和 3.01 倍,但每个模型/并发单元只有一次测量;MXFP4 还保持 lm_head 不量化。小差异不能据此当成稳定收益。
AOTriton attention 版本比较也要单独读:前向倍率范围 0.92–2.34,反向 0.93–2.47,包含退化情况;版本同时改变其他内核和调优数据库,无法把全部差异归因于 FlyDSL。
兼容接口不等于覆盖所有输入
当前主要支持 MI350 系列 gfx950。MXFP scaled GEMM 要求特定行列布局、沿 K 每 32 个值一个 E8M0 scale,且 K 为 128 的倍数;不兼容布局可能先插入复制。attention 当前不支持 FP32,RMSNorm 的加速针对前向,反向仍走已有实现。这些边界决定实际命中率和额外成本。
工程上应先找目标模型真正占时的算子与形状,再确认分派路径和数值要求。若瓶颈在通信、调度或 KV 搬运,局部 GEMM 提速可能被其他部分遮住。首次编译与调优开销也影响短生命周期服务,稳态算子图表不能直接回答冷启动是否划算。
从算子分派到用户延迟,中间还有一段距离
可以用一个不依赖具体模型的例子理解端到端边界。假设请求的一部分时间花在受益 GEMM,其余时间由 attention、通信、调度和输出处理占据;即使 GEMM 明显变快,后半部分也不会自动缩短。如果新布局需要先复制输入,复制还可能吃掉一部分收益。因此,算子几何平均描述的是所选测试集合,不是按线上时间占比加权后的服务改善。
后端自动调优也需要观察真实分派。一个形状命中 FlyDSL,另一个形状由 ATen 获胜,是候选机制正常工作,并不是安装失效。反过来,设置了候选列表却没有确认实际选择,也不能把后续速度变化全部归功于 FlyDSL。对于动态长度请求,应记录常见形状是否重复出现、调优结果能否复用,以及罕见形状的编译开销是否可接受。
低精度路径还多一道质量判断。原文报告的是同一精度配置下改变内核候选的服务实验;它没有证明把一个 BF16 应用直接换成 MXFP4 后,任务质量保持不变。量化策略、scale 表示和未量化层共同影响结果,性能验收之外还需要对应任务的数值与质量检查。把精度变化和内核变化拆开,才能解释收益究竟来自哪里。
实际阅读时,建议先定位自己使用的是普通矩阵乘法、scaled GEMM 还是 SDPA,再查输入布局和 dtype 条件,最后选择对应基线图。这样的顺序避免把“支持一个算子名”误读为该算子的全部组合都有相同实现。尤其在 nightly 集成阶段,配置接口和可用内核可能随构建变化,比较应固定软件版本。
对服务维护者,这还意味着升级回归要同时记录正确性与分派变化。一次升级没有改应用代码,也可能因候选集合或调优数据库改变而选用另一实现,性能波动需要沿这条路径解释。
值得读的是“专用优化如何被安全纳入选择”的机制。 保留多个后端、按形状测量、对不支持输入回退,使硬件专用内核成为可比较的选项。后续 MI450、更广低精度、FlexAttention、融合与训练覆盖都被列为进行中的方向,不属于当前已经验证的能力。