长 agent 上下文会同时压迫 prefill 速度与 KV 容量,二者不能靠同一个“多用几张卡”参数自动解决。vLLM 的 GLM-5.3 优化第二篇把查询计算、持久 KV 放置和 decode 侧缓存分开处理,展示它们怎样在两台八卡 H200 机器上组合。最值得抓住的区别是:PCP 分查询,DCP 分 KV,Hybrid HiSparse 再改变 decode 的存储位置。原文:GLM-5.3 Optimizations, Part 2: PCP, DCP, and Hybrid HiSparse on 16 H200s。
vLLM Team · 2026-10-23
DP 与 TP 各自留下什么瓶颈
DP8 把一条 prompt 交给一张 GPU,其余七张不能共同完成该请求的注意力工作;单卡还必须装下这一请求的 KV。TP8 按注意力头切分,但 MLA 的 latent KV 被所有头共享,每张 GPU 仍保存完整缓存。每卡只服务部分头,还要重复运行扫描历史 token 的 indexer。
GLM-5.3 的稀疏 MLA 每个查询主要访问选出的 2,048 个 token,而 indexer 仍需为选择过程扫描历史。前者随上下文增长近似线性,完整 prefill 的后者成本呈二次增长。因此头并行不能自动消除长上下文索引工作,也不能自动把复制的 KV 变成共享容量。
PCP 让每张卡处理一部分查询
PCP8 将 prompt 按 token 划分,每张卡处理八分之一查询、保留全部 64 个头。因果注意力中后部 token 可见历史更多,简单连续八等分会失衡;实现先切 16 块,再把靠前与靠后的块配对,给每张卡相近的工作量。
这样 indexer 不再在每张卡重复完成全部查询,每次取回 KV 也能服务更多头。文章估算稀疏 MLA 算术强度从约 26 提高至约 191 FLOPs/byte。但每层的新 KV 会 all-gather,所有 GPU 最终仍持有完整缓存。PCP 解决计算分配之后,容量问题依然需要第二步。
DCP 减少持久副本,保留临时通信
一条 1M-token 请求需要约 53.4 GiB 的 FP8 KV,而每张卡只有约 15 GiB 余量。DCP8 按 token 轮转分片,使每卡持久存储约 6.7 GiB。名称里的 Decode 是历史来源,这篇方案实际在 prefill engine 同时使用 PCP 与 DCP。
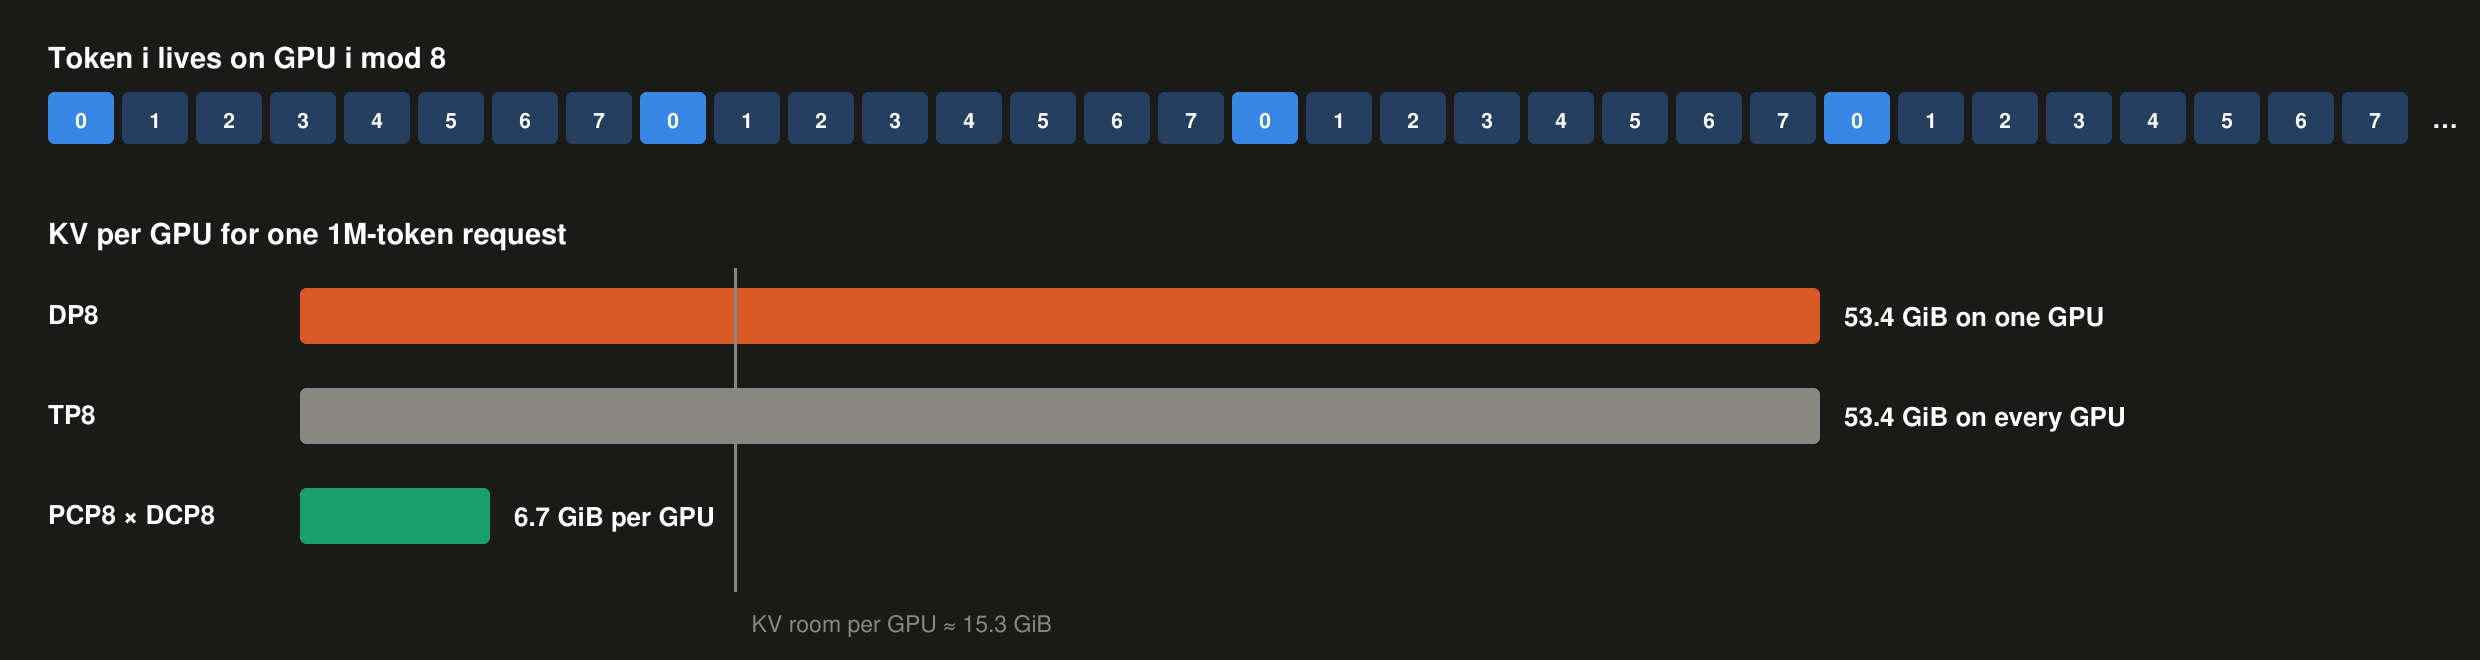
上方按 token 轮转分片;下方比较单请求在 DP、TP 与 PCP×DCP 下每卡需要保存的 KV,竖线标示容量余量。
需要小心的是,持久缓存分成八份,不等于计算时永远只读本地八分之一。该 prefill 实现每层仍把各分片 all-gather 成临时完整上下文,让本卡查询执行注意力,之后释放临时副本。它以额外通信换取持久容量。对相同 2K-token prefill chunk,DCP8 在缓存上下文不超过 64K 时增加约 6% 单步开销,到 248K 时约 15%;这不是八倍免费扩容。
Decode 侧仍需要另一种容量策略
部署使用 16 张 H200,prefill 为 PCP8×DCP8×EP8,另有总计 512 GiB CPU KV offload。decode 为八个 DP rank 配 EP8,每 rank 使用 48 GiB HiSparse host pool 与 16 GiB offload,总主机内存同样为 512 GiB。prefix-aware 路由把请求送往 prefill,NIXL 再传输和重组 KV。
比较组保持 GPU 数、主机内存和 vLLM build 相同,分别改变 prefiller 和 decode 缓存方式。这样能区分速度来自哪一端。它也暴露集成难点:prefill 的 token 分片布局,必须转换成 decode rank 所需的完整分页布局,包括 MTP 层;前缀复用在转换后也必须继续正确工作。
读结果先读 token 的分母
AgentX 使用 Claude Code 轨迹及前缀复用,每个并发配置重启服务,运行一小时。所有组使用 MTP3,并把合成接受长度固定为 2.99。吞吐是包含缓存输入的逻辑 token/s/GPU,按全部 16 张卡计算;交互性是 P90 端到端归一化的每用户输出速率。因此图中的总吞吐不能直接当成新生成输出 token 吞吐,也不能用它证明真实草稿接受率达到同样水平。
在主要受 prefill 限制的并发区间,相同 HiSparse decode 下,PCP8×DCP8 相对 DP8 在同吞吐时交互性提高 1.7–3.2 倍,中位 TTFT 从 1.5–5.2 秒降到 0.8–0.9 秒。低并发时两种 decode 方式差别小,offload-only 甚至在 c8 略快,说明优化并非每个负载点都有同方向收益。
百万上下文是组合能力的结果
c32 起 decode 压力增加;c64 的组合方案达到 8,340 逻辑 token/s/GPU 与 29.6 token/s/user,而其他配置的每用户速率降到 1–2。1M 上下文又需要两端都能承载:DP8 prefill 和只用 offload 的 decode rank 均装不下一条这样的请求。
这些结果支持按瓶颈组合技术,而不是寻找一个万能并行参数。部署时应同时检查持久 KV、临时 gather 空间、互连带宽和 decode host pool;原文也将通信重叠留为后续优化。优先读布局变换与测试口径,才能判断这套方案是否适合自己的上下文长度和并发区间。
布局正确性是组合优化的前提
这几项优化都在改变“某段状态现在由谁持有”。查询块的分配与缓存 token 的分片并不一致,所以仅看某张卡自己的块表,无法判断它已经获得计算所需的所有状态。每层通信结束、临时副本释放和跨节点重组都需要满足各自的数据依赖。文章把这些组合工作放在共同执行路径里,说明性能改进也伴随状态管理契约的增加。
对读者而言,一个实用的分析顺序是先画出单请求的状态生命期,再计算最大同时存在的副本。持久占用下降八倍,只描述长期驻留部分;临时完整副本、传输缓冲和其他运行状态仍需要空间。相同道理,主机 offload 容量相同也不能保证相同延迟,因为实际命中、搬运次数与请求排队可能不同。
哪个运行点最值得优化
如果业务多数请求停留在短上下文和低并发,增加通信换容量可能并非首选;如果一条请求已经超过单卡可容纳范围,容量机制首先决定服务能否运行,随后才比较速度。报告中低并发 decode 差异小、高并发 HiSparse 优势变大的现象,正好展示优化目标随运行点变化。
因此,评价新配置时应固定任务轨迹和硬件资源,同时保留首 token、用户感知生成速率与系统逻辑吞吐。某次改动可能把瓶颈从 prefill 移到 decode,单看前半段会误以为收益还能继续线性增长。原文使用不同并发点形成前沿,比选一个最高吞吐点更能说明可用运行区间。
这些建议是根据文中的资源关系作出的工程分析,并不补充新的性能测量。它们的作用是帮助读者判断何时需要复查缓存容量,何时应检查互连或后端执行,而不是把所有长上下文问题都归给显存不足。
文章公布的测量提交与复现脚本固定的提交不同。比较后续版本时,应把实现版本也当作实验条件,避免将接口可用直接等同于已经获得文中的性能。