发布后服务没有宕机,却有部分请求逐渐变慢,是最容易消耗团队注意力的场景之一。有人盯仪表盘,有人判断异常是否重要,有人查调用链,最后开发者还要重新理解问题才能改代码。Grafana 这次把持续观察、事故调查和代码修改提案放进同一条流程,关注的是这些步骤之间反复丢失的上下文。
原文:From production problem to proposed fix: Implement autonomous operations with Grafana AI · Maurice Rochau / Grafana Labs · 2026-10-20
三种能力,各自回答一个问题
发布状态需要分开看:Assistant Watchers 与 Investigations 为正式可用,Managed Sandboxes 为公开预览。前者持续判断值得关注的变化,中者解释事故,后者让调查结果进入代码环境并形成补丁。把它们连接起来,并不意味着三者具有相同成熟度,也不意味着补丁会直接进入生产。
Watchers 的输入是用自然语言描述的关注点和选定数据源。Assistant 分析历史遥测以建立基线、校准检查,随后周期性评估并给出证据。以结账服务为例,关注点可以是持续错误或延迟恶化,同时容忍发布时短暂扰动。相比固定条件的告警,它增加的是围绕业务语境的判断。
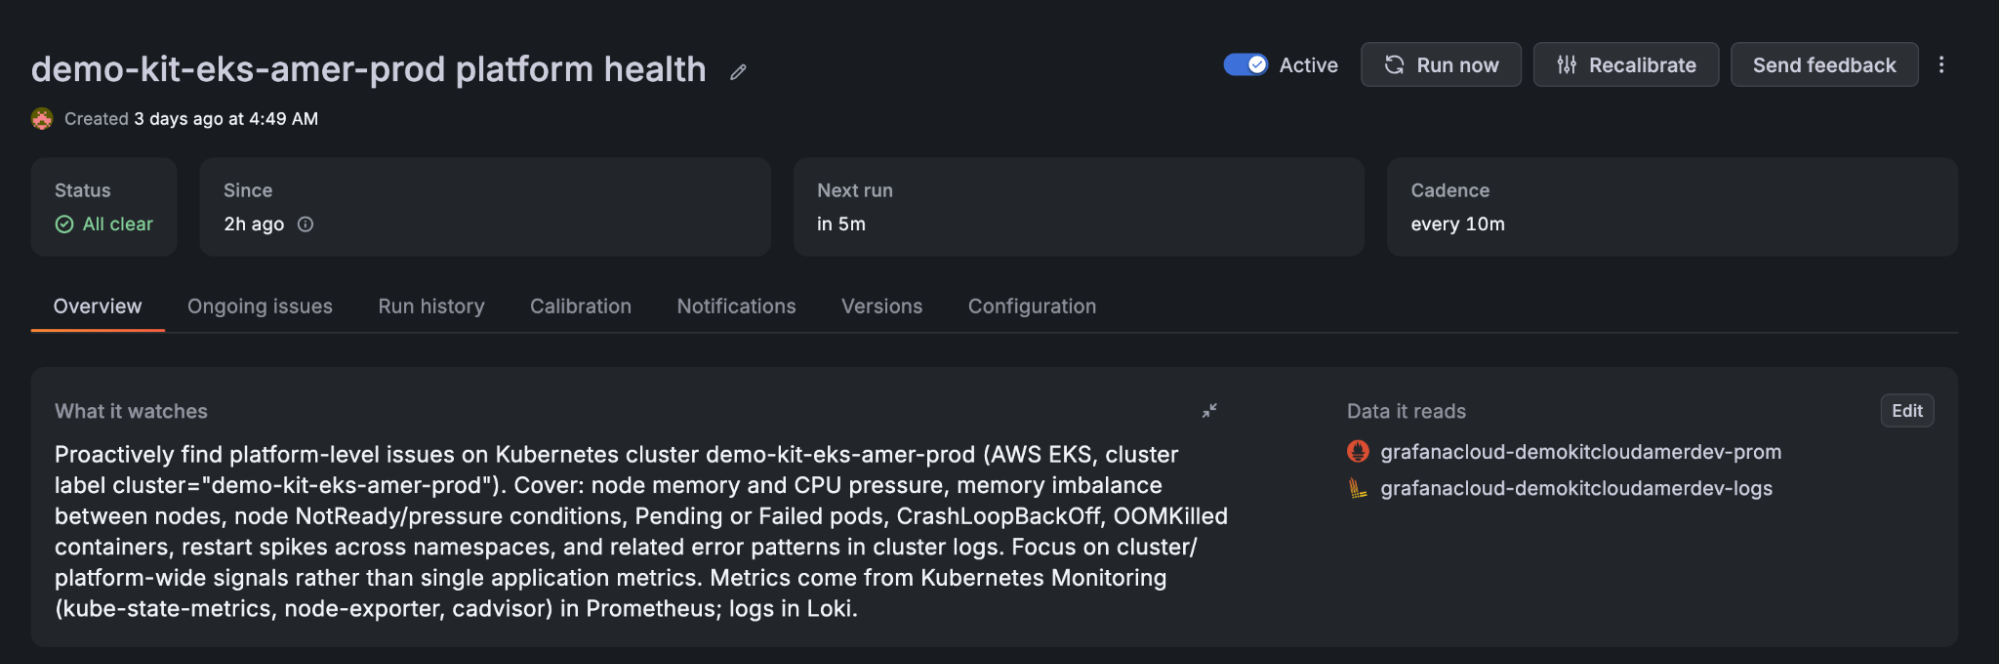
读图:Watcher 明确写出要观察的对象与异常类型,并列出读取的数据源;校准和运行记录帮助操作者理解后续判断基于什么。
官方强调,既有告警仍负责已知条件下可靠的呼叫通知。这里的分工很实际:明确而紧急的阈值事件不必每次等待开放式推理,Watcher 则适合补充跨信号、带背景的观察。支持 BigQuery 也使检查对象可延伸到业务信号,但数据源接入不等于业务异常已经具备可靠解释。
调查应交付证据链
Watcher 发现严重问题时,可以启动 Investigations。调查 Agent 探索指标、日志、追踪和性能剖析,检验假设,并把源查询附到发现上。对接手者而言,结果不应只有“数据库慢了”,而应包含哪些请求受影响、变化从何时开始、哪些观测支持这一判断。
原文以请求路径里重复数据库调用为示例。这个发现给开发者缩小了检索范围,也给下一步修改一个可检验假设。但“重复调用”是否真是主要瓶颈,仍需与负载、缓存和服务依赖结合判断。把调查结果保留为证据支持的假设,可以避免尚未确认的推断在跨工具交接后变成既定根因。
从工程上推导,这种交接最好同时保留时间范围、查询条件和观测对象。否则,同一条查询稍后运行得到不同数据,开发者可能无法重建当时情境。发布稿展示了带源查询的工作方式,没有报告诊断准确率或调查完成时间的受控对照,因此目前更适合评价流程能力,而非给出自动 RCA 的成功率。
沙箱让建议变成可审查的改动
Managed Sandboxes 提供受控云环境,连接相关仓库并启用编码后,Agent 可检查代码、准备修改、运行可用检查。仓库专用环境可以预置构建与测试所需工具和依赖,使调查上下文不止停留在聊天结论,而能进入具体实现。
结账示例里的下一步,是检查数据访问模式、准备针对性改动并增加回归测试。理想交付物是一份 pull request:说明改了什么、为何针对当前假设、执行了哪些检查,以及还有什么未确定。这个设计把自动化的结束点放在可审查成果上,让开发者评估真实代码,而不是仅批准一句自然语言建议。
测试通过只能说明所覆盖的行为满足测试。若根因假设错了,一个功能正确的补丁仍可能不改善线上延迟。团队需要判断修改是否合适、如何发布,并在部署后用生产遥测确认恢复及复发情况。调查、代码与恢复指标形成闭环,才能避免把“创建 PR”误当成“事故已解决”。
自动化程度是一个分配问题
这套组合允许团队把重复观察、资料收集和补丁准备交给 Assistant,保留关键发布决定。原文也允许根据任务选择更充分的委托。工程取舍因此不是简单开或关,而是每个阶段允许什么输入、输出和动作,什么结果必须再由人或已有系统确认。
例如,低风险周期分析可以只生成报告;可能触发生产变更的调查,则需要可追溯的查询、受限仓库范围以及明确的验收信号。这些是对所述流程的工程分析,不是发布稿额外承诺的默认权限。公开预览阶段尤其应检查沙箱实际可用的环境和检查是否覆盖目标项目,而不能从“受控”二字推断全部边界。
先用交接质量判断价值
官方建议从一个熟悉的服务开始,先定义观察行为、校准 Watcher、审阅发现,再连接仓库尝试边界清楚的修改任务。这样可以区分是哪一段在节省时间:更早发现异常、减少搜集资料、还是让开发者更快得到可检查的补丁。
评估时可以记录调查是否引用有效证据、接手者是否还需重复检索、修改是否通过项目测试,以及发布后目标指标是否恢复。它们比对话次数或 PR 数量更接近运维结果。文章没有公布统一的 MTTR 或成本收益数字,因此不应把流程串联直接写成已证明的修复提速。
把一个结账问题拆成可验证的交接
沿用原文的结账场景,可以把验收分成三份成果。Watcher 应说明为何这次延迟超出了发布扰动的正常范围;Investigations 应给出支持重复数据库调用假设的查询和追踪;沙箱应把代码改动与该路径对应起来,并说明回归测试覆盖了什么。这样即使最终没有接受补丁,前两阶段的调查也仍可独立产生价值。
相反,如果三个阶段都只转交自然语言摘要,细节可能逐轮丢失:初始发现中的时间限制被删掉,调查中的“可能”变成确定断言,补丁又围绕这个断言添加测试。每一步都看似完成,却没有继续检验最初问题。这是对串联 Agent 流程的一般工程推断,也说明为什么官方强调源查询和可审查变更,比单纯生成更长解释更有意义。
因此,试点最好允许阶段性停止。证据不足时保留调查结果,测试环境不完整时交付有明确边界的提案,生产恢复不符合预期时重新打开假设。能否把这些状态表达清楚,比自动化是否总能走到最后一步更能反映流程是否可靠。文章所列功能提供了连接各阶段的入口,实际停止条件仍要由团队结合服务风险配置。
这次进展在于把可观测上下文带进编码环境。 值得追踪的是证据能否跨阶段完整保留,尤其当一个问题经历自动观察、推理调查、沙箱开发和人工发布时,各阶段是否仍在验证同一个故障假设。