GPU kernel 的 tile、warp 数和流水级数已经调过,机器码仍可能留下优化空间。Helion 与 NVIDIA CompileIQ 的结合,把 ptxas 的编译控制加入可搜索的配置:上层决定怎样分配工作,下层决定怎样把工作编成指令。值得关注的是两层之间的耦合,以及把离线搜索结果稳定带入后续构建的方式。
原文:One Search, Two Layers: Compiler Controls Inside PyTorch Helion using NVIDIA CompileIQ
Aditya Srikanth (NVIDIA), Rupak Roy (NVIDIA), Abhinav Singh (NVIDIA), Jason Ansel (Meta), Clement Anthonioz-Blanc (Meta), Jongsok Choi (Meta) · 首发:2026-10-19
自动调优为什么会停在一半
Helion 从接近 PyTorch 的表达生成底层 kernel,并搜索 tile、访存方式等配置。但同一份中间代码经过寄存器分配、指令调度和代码生成策略后,可以形成不同的机器执行行为。原文把这部分控制封装为 Advanced Control File(ACF),在编译时应用。
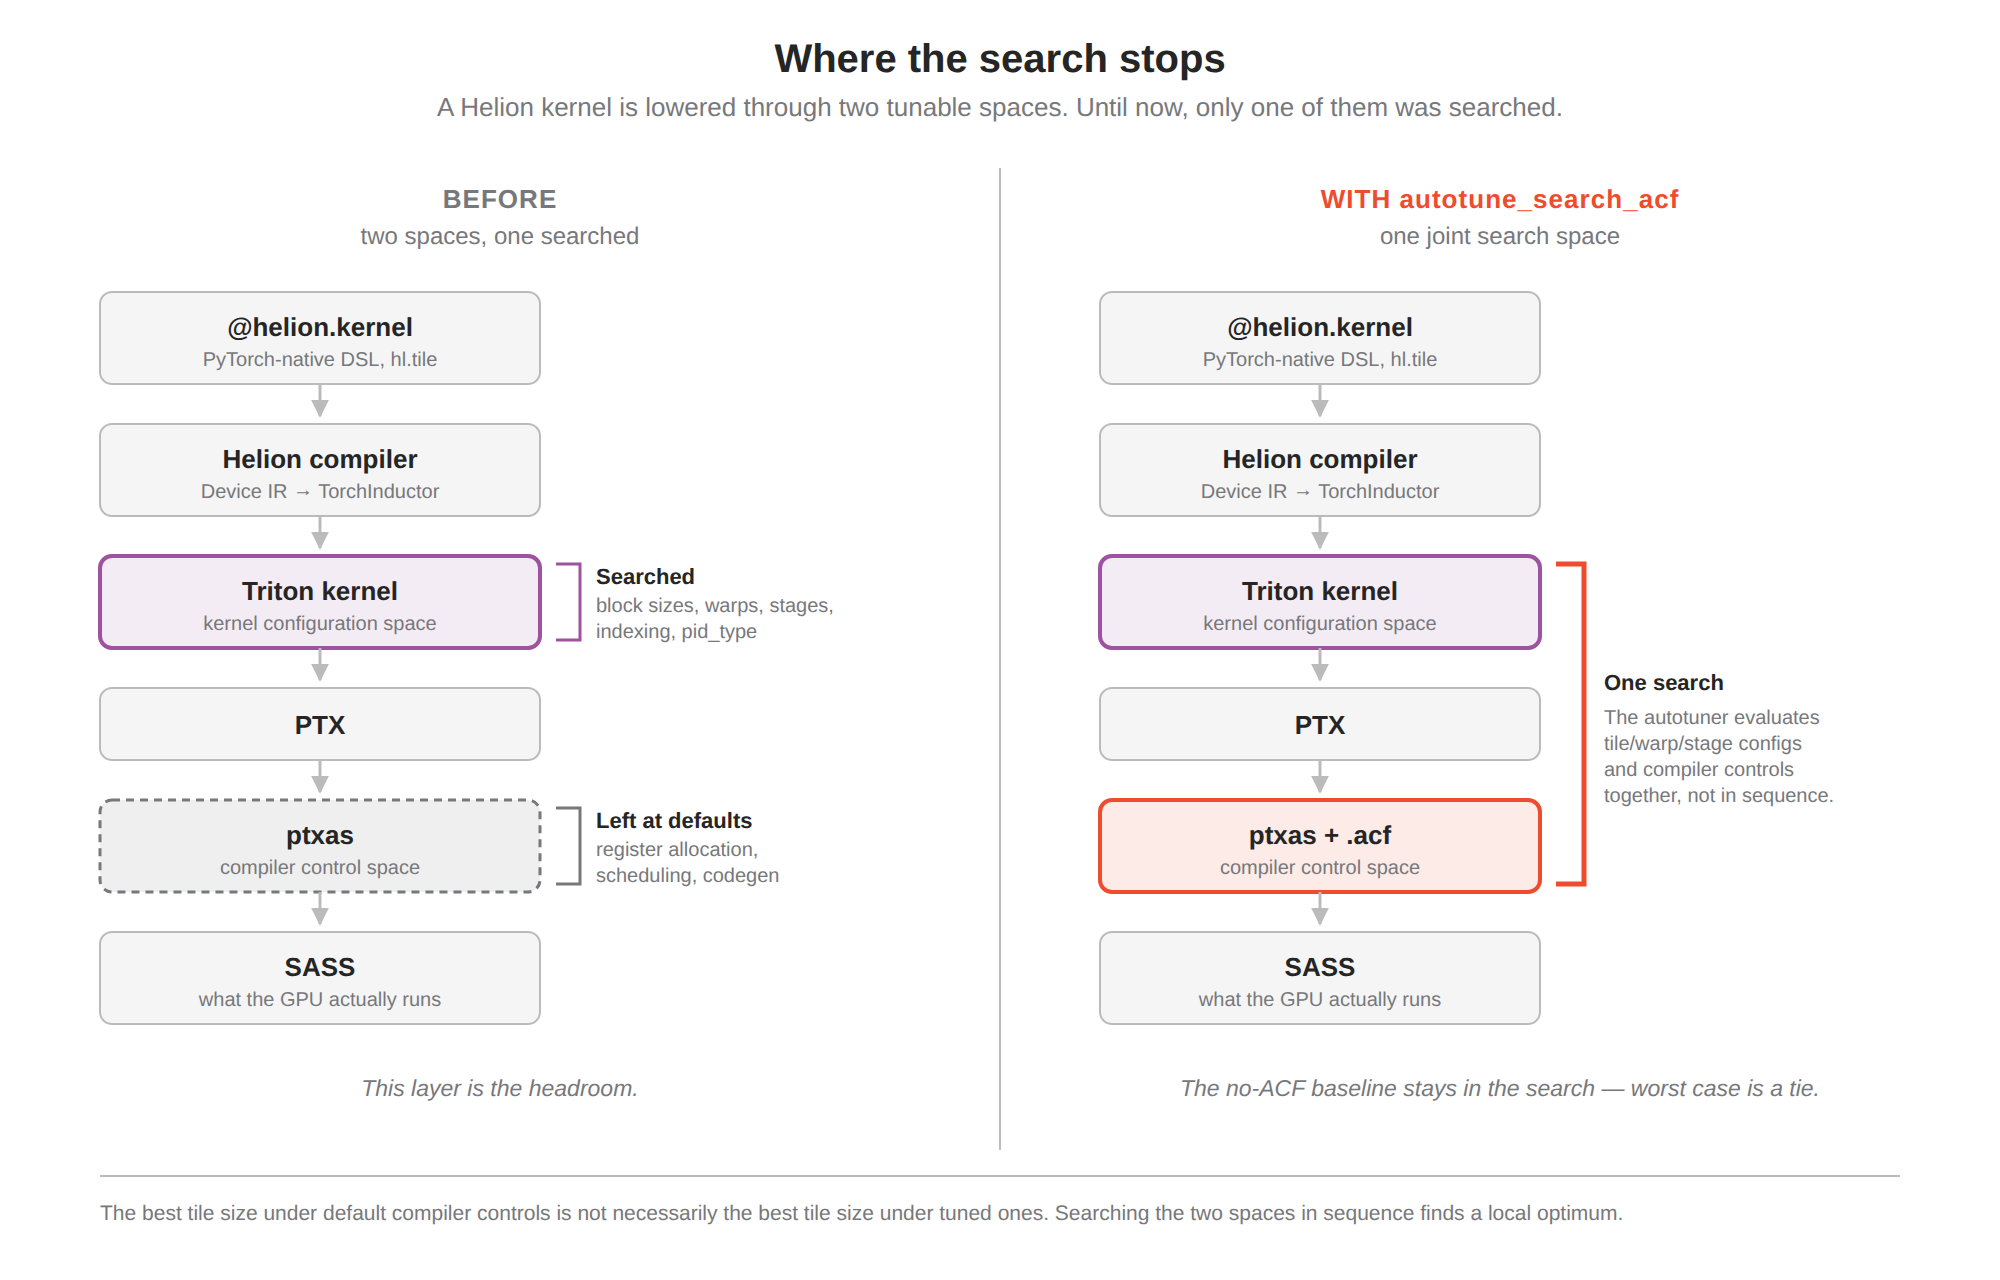
读图:左侧搜索止于 Triton 配置,下方 ptxas 使用默认控制;右侧把 ACF 与 kernel 配置一起比较,最终仍生成 GPU 执行的机器指令。
一个直观的工程推论是:最好的 tile 取决于编译器怎样处理其资源需求。较大 tile 可能增加寄存器压力;某种分配策略可能改变溢出或 occupancy,进而改变调度效果。因此,先固定上层配置再搜索下层,会错过另一组上下层组合。联合搜索避免这种固定顺序的限制,但有限预算的搜索仍不能保证全局最优。
搜索结束后,留下一个可管理的产物
Helion 可通过 advanced_controls_file 固定一个 ACF,也可通过 autotune_search_acf 比较多个 ACF 与 kernel 配置的组合。默认编译控制仍作为候选保留。CompileIQ 则负责生成控制文件:编译候选,先检查数值正确性,再测量通过者,并继续搜索。
从工程角度看,ACF 把一次调优变成可保存、可选择的构建输入。由此也产生版本管理责任:记录文件本身还不够,需要同时记录目标 GPU、工具链、kernel 实现、输入形状和验证方法。如果其中任一项改变,就不能仅凭旧文件名认定优化仍有效。
保留默认候选是有用的比较基准,却不意味着开关打开后生产性能绝不退化。测量噪声、输入分布变化、运行时争用都可能改变赢家。合理的使用方式是离线寻找候选、独立验证、固定配置,再观察真实工作负载;把大量编译测量放到请求路径上,会用启动等待换来尚未确认的收益。
微秒级改善需要明确基线
文章的主要数值案例是已经带有 AOT 配置的 NVFP4 W4A4 decode GEMV,而非从朴素实现起步。实验使用 GB200/sm_100、ptxas 13.3.73、CompileIQ 1.0.3、Triton 3.8.0,锁定 GPU 时钟,检查 PyTorch 参考结果,并以独立重测、Welch 检验 p<0.05 和 Cohen’s d>0.2 筛选收益。
在 N=8192、K=28672 的形状上,固定 Helion 配置后搜索编译控制,两次验证分别得到约 1.0485×、1.0478× 加速;第一轮均值从 0.09752 ms 降到 0.09301 ms。联合优化运行时间与 L1TEX 吞吐的另一搜索得到约 1.0689× 加速。这些是特定 kernel 的结果,不能写成模型整体快了同样比例,也不是联合搜索所有 tile 与 ACF 的全面对照实验。
统计上可区分,不等于对系统同样重要。 是否值得部署取决于这个 kernel 占总时长的比例、调用次数与维护成本。以理想化算例说明:若它占执行时间的 20%,其余部分不变,kernel 加速 1.05×,整体加速仅约 1.01×。这是按时间占比推导的示例,并非文章的端到端测试。
优化代理指标,要再回到时间
occupancy 或缓存吞吐能帮助定位问题,但它们不是用户目标本身。更高 occupancy 可能伴随不同的指令数量或访存行为;更高的吞吐百分比也不自动等于更短的完成时间。文章展示了用不同目标函数探索控制空间的方式,阅读时应把目标指标的改善与独立测得的运行时间分开。
多形状部署还会引出另一层选择。针对一种形状的最快配置,未必适合另一种;共享一个配置可以减少产物数量,却可能牺牲个别场景。实际评估应按请求中形状的频率或服务目标加权,而不是只挑最大加速数字。若稀有形状承担延迟尾部,还需要单独保留它的结果。
搜索预算怎样转化为部署收益
一个值得单独计算的量是摊销周期。假设离线编译、测量和复查需要一段固定时间,而每次调用只省几微秒,只有累计调用足够多,节省才可能抵消搜索资源。这不是反对微小优化:长期运行的热点可能很快摊销,低频路径则未必。两者应按实际调用量区别对待,而不只是比较加速百分比。
正确性检查也有输入分布。某个形状、精度和数值范围通过参考比较,不代表所有取值和边界条件都通过。工程上应保留业务真正使用的误差容限,并覆盖可能改变执行路径的形状边界;不能为了保住最快候选,临时放宽到与应用要求不一致的容差。
构建过程还需要可退回的基准。当升级工具链后原 ACF 不再适配,明确回到已验证的默认控制,比继续使用名字相同但条件不同的文件更容易定位问题。保留旧版本的性能和正确性记录,可以把“编译器变了”“kernel 变了”和“输入变了”分开比较,避免把所有变化混成一次基准波动。
最后,独立重测的意义是把搜索时的选择与最终判断分开。在大量候选中挑出最小耗时,本来就更容易挑中一次有利噪声。增加搜索候选不应同时降低验收要求;收益越小,测量环境与工作负载代表性就越重要。
使用边界决定调优能否交付
ACF 对硬件和工具链有约束,错配可能产生错误结果或运行失败。文中示例使用 CUDA 13.3,而所述 24 个文件的 Helion Booster Pack 面向 B200、按 CUDA 13.4 的 ptxas 验证;两者不是可以忽略版本差异的一套产物。每增加一批候选,编译与测量预算也会增加。
另一个实际取舍是许可:Helion 为开源项目,CompileIQ 在文中描述为按 NVIDIA 专有 EULA 分发的免费工具,生成的 ACF 可自由分发。采用者需要分别理解工具与产物的交付条件。
适合优先阅读的人,是已经知道热点 kernel 在哪里的人。 这项进展把编译器内部控制变成了更可操作的优化空间,但并未代替 profiling、正确性检查或端到端评估。优先读搜索接口、实验环境和 caveats,再判断几个百分点是否值得承担额外构建与验证成本。