Ant Group / vLLM Community · 2026-10-21 · 原文
Humming试图降低量化推理的组合复杂度:量化表示、硬件选择与CUDA执行组件分开描述,再按工作负载进行JIT特化。它的价值不只在某一张加速图,而在不同格式和GPU之间能否复用优化,同时保留明确的数值与执行约束。
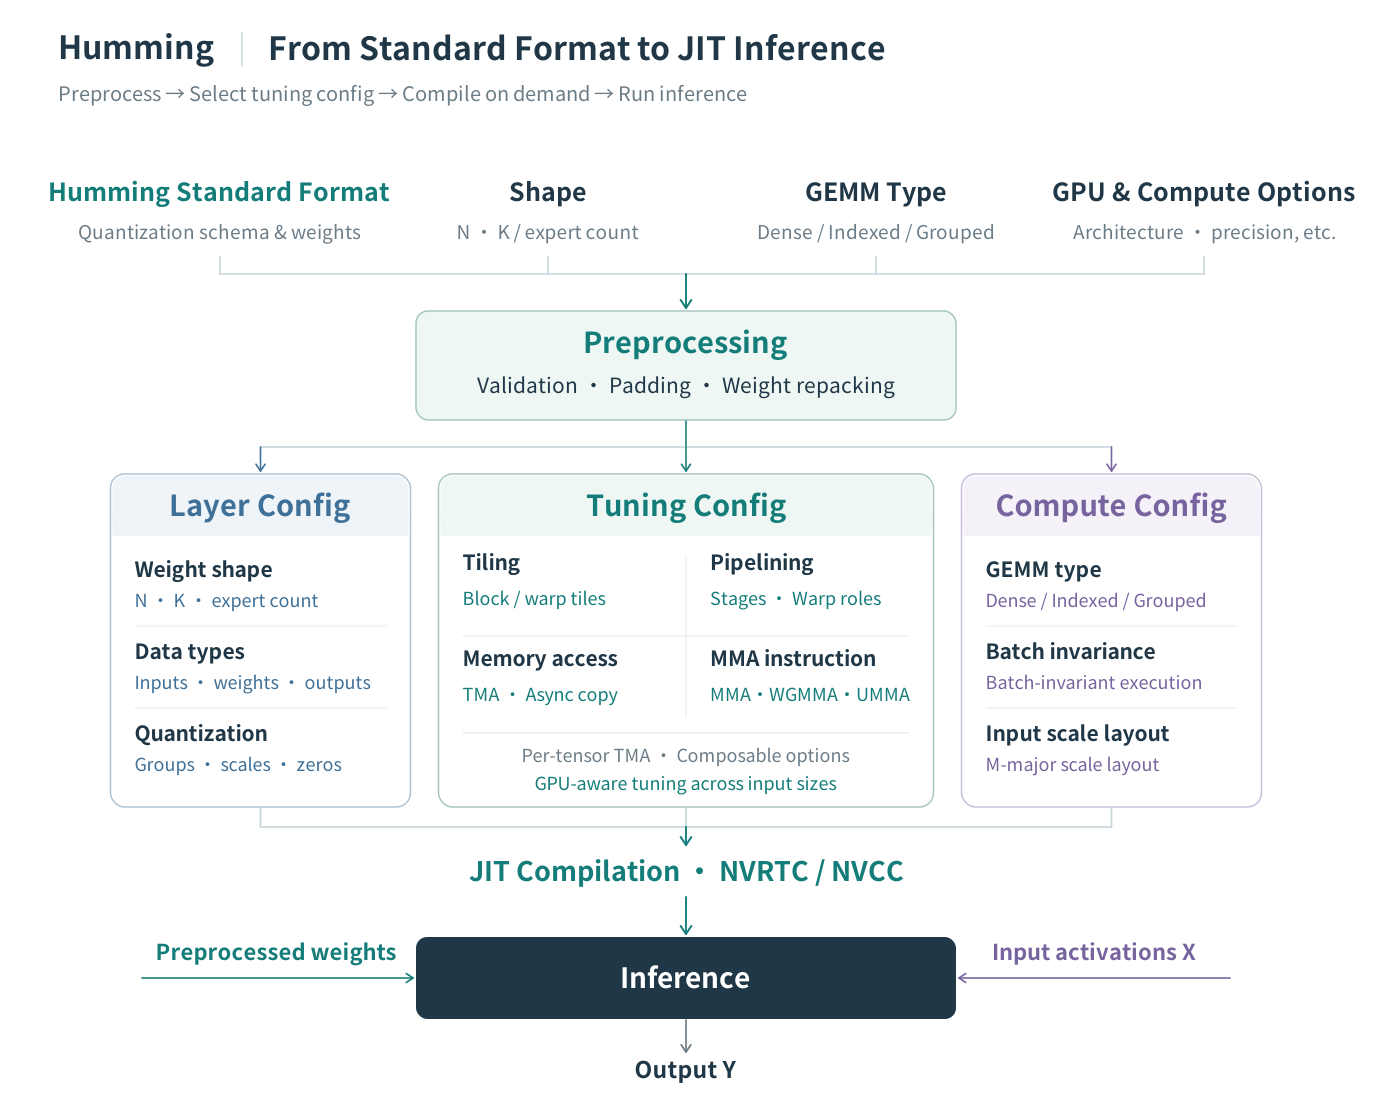
原文展示量化表示、配置选择与JIT执行之间的关系。
统一接口不能抹掉量化语义
项目仓库提供HummingLayer和量化GEMM使用入口。理解这类接口时,需要把“相同位宽”和“相同数值含义”分开:缩放粒度、零点、数值格式和数据排列都会影响执行与结果。一个统一描述应表达这些区别,而不是把所有低比特权重强行当成同一种张量。
工程上可以把导入过程当作契约检查:权重、scale与zero-point的形状是否匹配,布局转换是否保持元素对应关系,padding是否影响有效输出,以及目标设备是否有合适的指令路径。只检查加载成功,会把很多问题推迟到实际请求中暴露。
编译选择与运行时分布要一起看
一个内核配置在某个矩阵形状上很快,不代表它覆盖真实服务的输入分布。服务端批大小变化、prefill与decode切换、专家负载偏斜,都会改变计算与访存比例。
因此,评估JIT系统时可以分别测量首次编译、缓存命中后的调用,以及新形状出现时的代价。热内核微基准适合解释稳态性能,启动延迟与编译缓存占用则关系到弹性扩缩和多租户部署。两类成本都要保留,避免只优化一个已经充分预热的实验点。
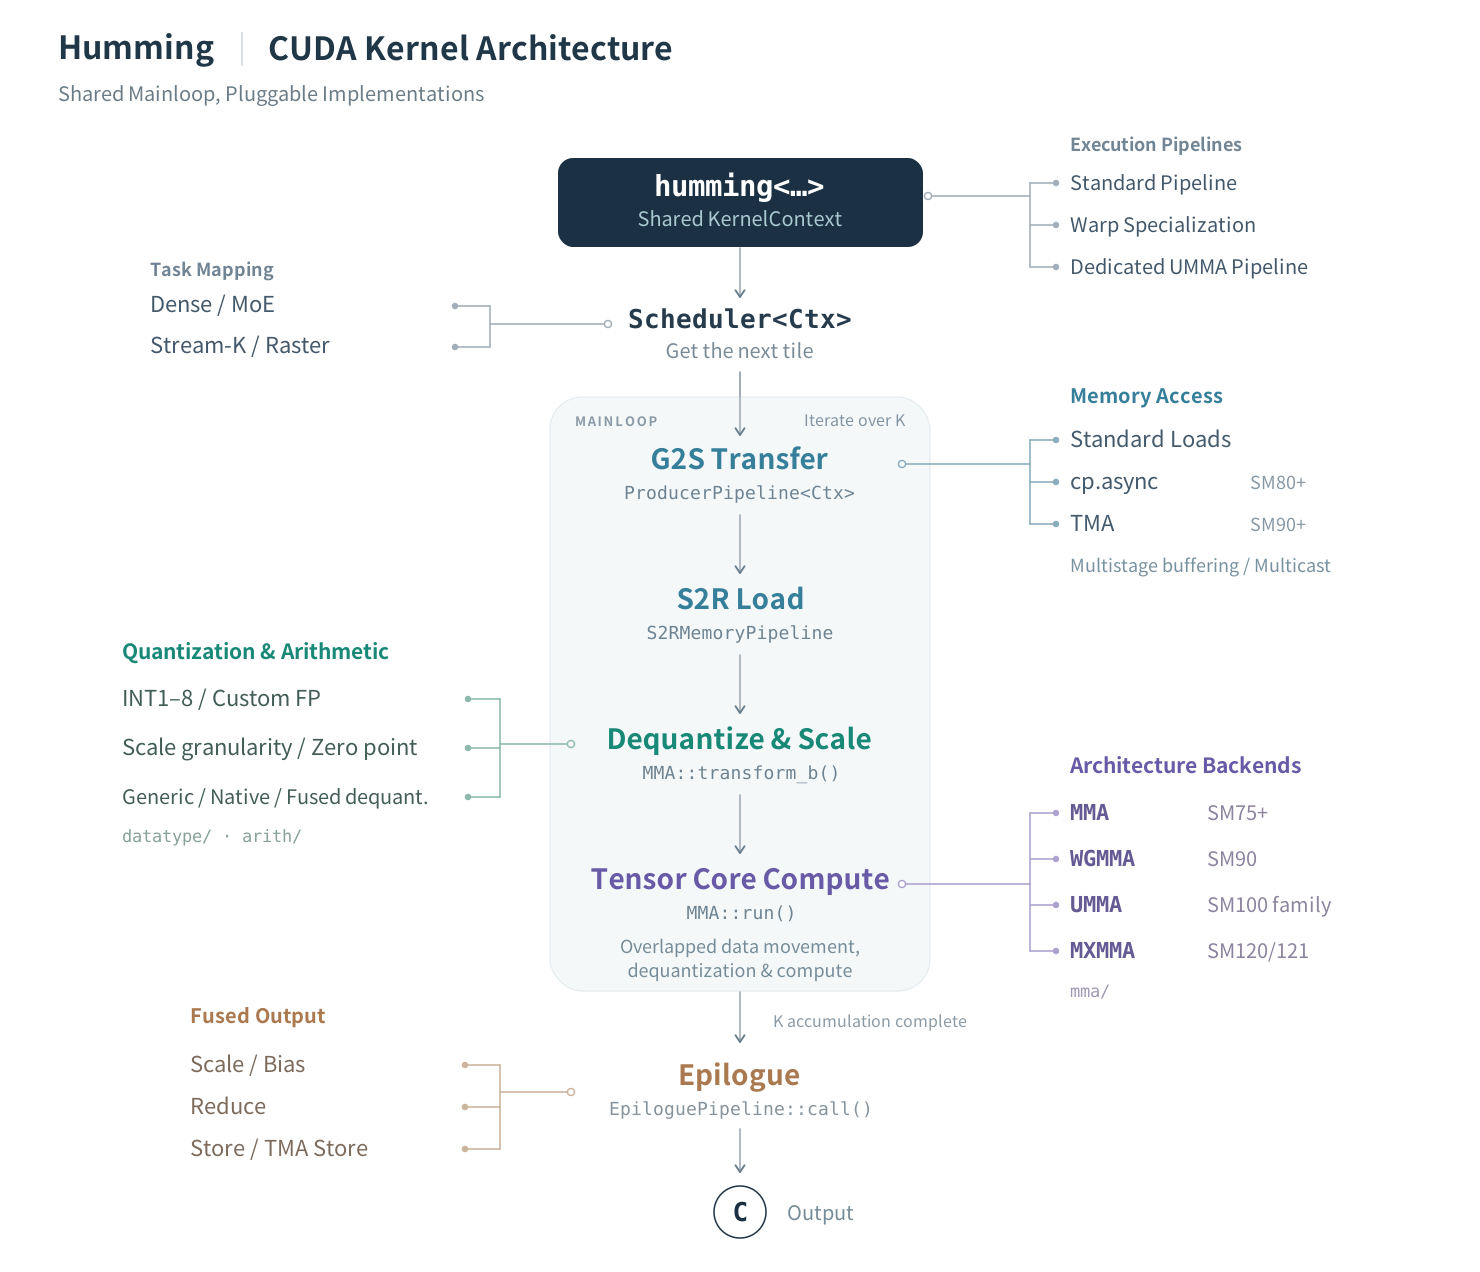
原文CUDA组件结构:不同执行流水线复用兼容组件。
端到端提升包含哪些变化
原文报告,在8张H20、TP=8的DeepSeek-V4.1-Flash实验中,从Marlin W4A16切到Humming W4A8后,吞吐提高约14%–43%。其中激活精度也从BF16变为逐token FP8,所以这不是只替换内核、其他条件完全不变的对照。读取这些结果时,应同时保留模型、格式、并发和设备条件。
一个更严格的验证计划可以拆成两步:先固定量化语义比较执行后端,再评估改变精度后对服务质量和性能的共同影响。需要同时覆盖数值误差、任务质量、吞吐与尾延迟,不能让更快的输出掩盖精度回归。
对MoE还应记录每个专家收到的工作量。平均负载相同,分布不同,也可能使调度和分组策略得到完全不同的结果。
正确性测试应覆盖转换与组合
可以从小张量参考实现开始,对不同scale粒度、边界值、非整齐维度和极端激活进行差分测试。随后再加入批大小变化、多专家组合和完整模型。这样可以区分格式转换错误、内核计算错误与模型集成问题。
性能回归测试同样应保留配置签名:模型导出格式、设备架构、编译器、内核选项和输入形状。否则,一次“后端回归”可能其实来自配置分派变化,或者缓存中的旧编译产物。
Humming值得持续观察的是这套组合方式能否降低维护成本,而不只是支持矩阵里多一个勾。对于推理平台,统一入口很有吸引力;对于可靠性研究,它也带来了跨格式、跨硬件、跨负载验证的新空间。