SREGym 的这次实验把诊断任务拆成两部分:程序负责采集和整理集群信息,Jev 从提供的选项中选择调查对象与支持证据。它没有让一个自由行动的 LLM Agent 编写命令和报告。值得关注的进展,是把低成本判断嵌入确定流程,同时公开说明这条流程在哪些故障上稳定失败。
原文:Jev-Driven SRE Diagnosis: What Worked and What Failed
Yiming Su, Saad Mohammad Rafid Pial, Jackson Clark, Tianyin Xu · 首发:2026-10-06
把开放式调查变成有边界的选择
采集器先读取 Kubernetes 对象、事件、近期 Pod 日志和资源状态,按组件汇总异常。Jev 选择值得进一步调查的组件;程序随后收集更细的信息,整理成编号证据。接着 Jev 判断该组件是起因、受害者还是无关对象,并选择支持结论的条目,程序据此继续调查或拼装报告。
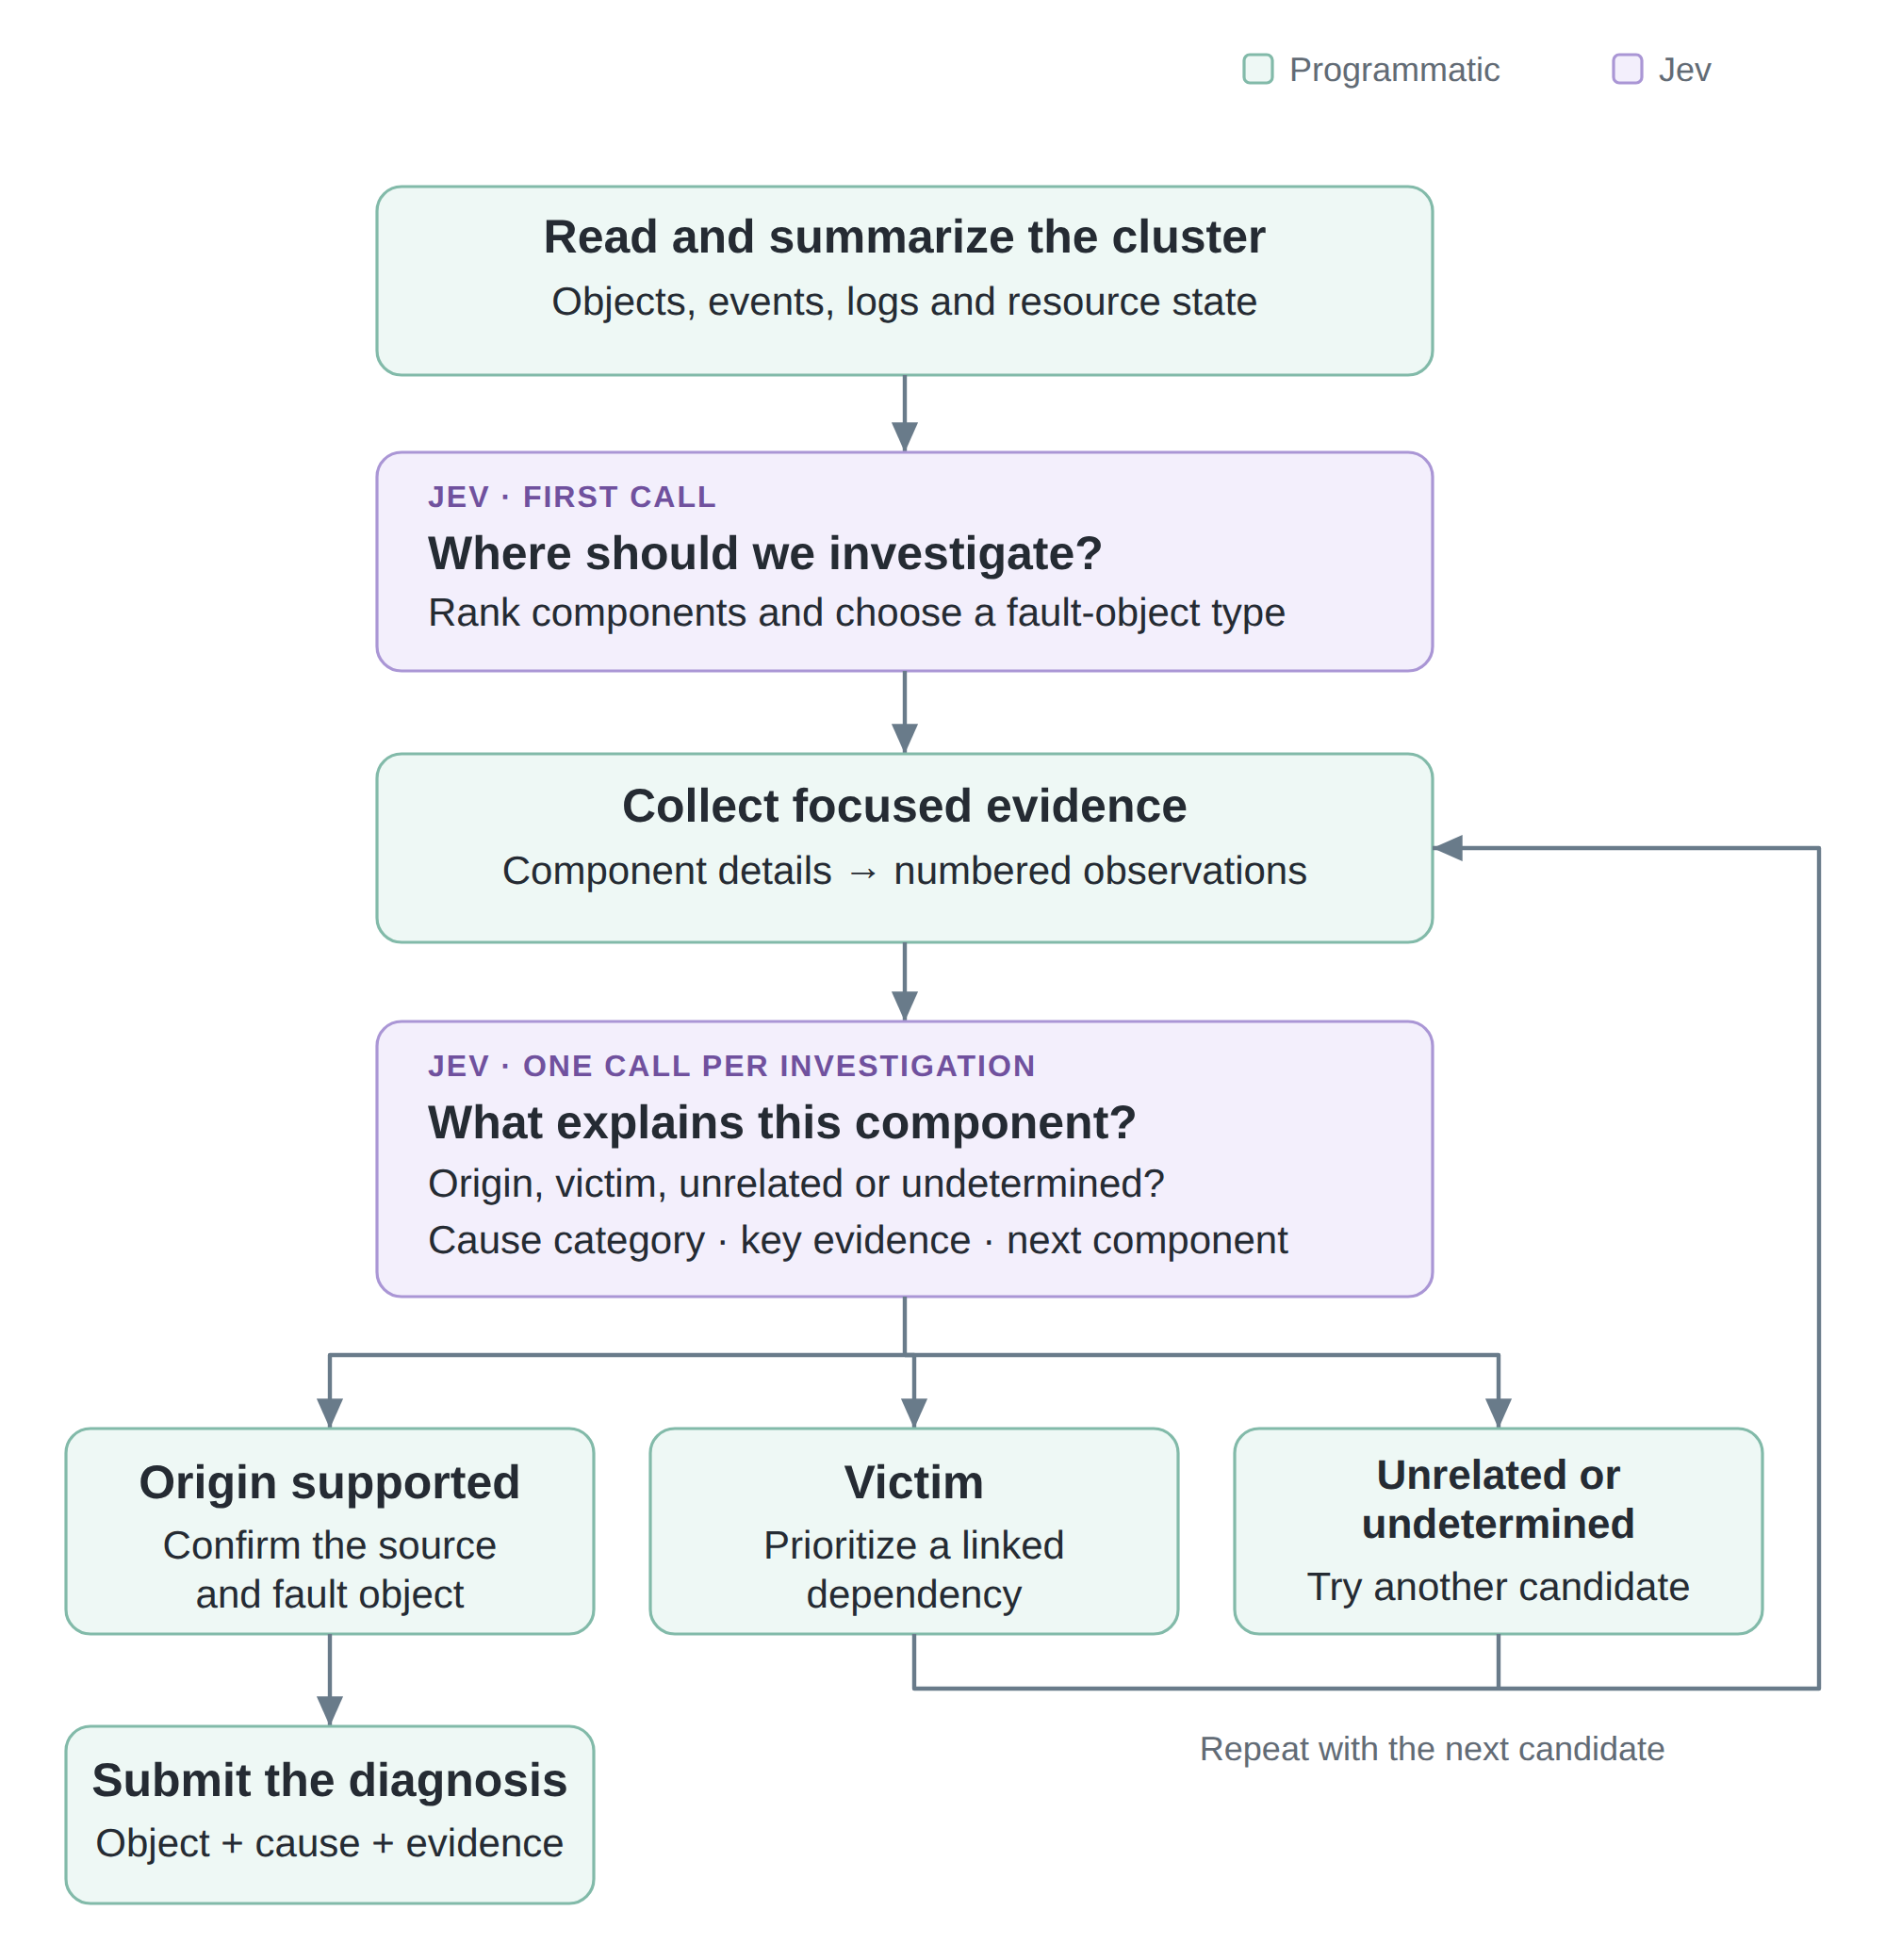
读图:绿色框是程序采集和路由,紫色框是 Jev 选择;证据支持起因时提交,受害者指向关联依赖,无关或未确定时继续调查候选。
这类设计把动作空间变小:模型不必自行发明命令,也不用自由生成最终诊断文本。工程上的好处是执行路径更容易约束,输出可以追溯到提供过的证据编号。但代价也明确:选项集合决定了哪些答案能够被表达,采集器决定了哪些现象能够被看见。
因此,成功率属于整个流水线。把采集器换成简单日志截断,或移除它对配置差异的解析,即使 Jev 不变,也不是同一个诊断系统。理解这一点,才能正确判断哪些能力来自模型,哪些来自领域知识与确定性代码。
成功案例里,采集器做了多少工作
文章用一个 webhook 修改内存限制的故障说明分工:Deployment 模板为 256Mi,新 Pod 却只有 16Mi,随后出现 OOM。采集器找到模板与实例之间的差异,并缩小匹配 webhook 的范围;Jev 再选择组件与关键证据。最终报告解释了限制被改写的机制。
从工程角度看,这比单纯把 OOM 日志交给模型更有信息量。OOM 是结果,模板与实际对象不一致则指向了配置生效过程。采集器把分散在多个对象中的关系整理好,减少了判断器必须自行寻找的步骤。
但这种收益也有维护成本:对象版本、策略类型和应用结构改变后,关系提取规则是否继续有效,需要重新检查。一个擅长识别配置差异的采集器,未必同样擅长识别只在时间序列中出现的反馈环。这是从成功案例推得的适用边界。
数字说明了覆盖面,也说明了稳定盲区
作者用 Jev 1.13.0,对 9 月 4 日历史 SREGym-Lite 队列的 21 类故障各运行五次。诊断由 gpt-6-astra 在 high reasoning effort 下按九问 rubric 评分,通过阈值为 0.70。80/105 次通过,即 76.2%;中位诊断时间 14.6 秒。16 类故障五次全过,另外五类五次全失败。
105 次尝试合计 252 次 Jev 调用、348 万输入 token;按公开价格估算的 Jev 推理费用合计约 0.15 美元。这个费用口径不包含集群、采集、工程维护或评分成本,也不是修复一次生产事故的全成本。诊断通过更不等于自动修复成功。
原文与相同 21 个故障上的另一组 LLM Agent 实验比较,报告相近通过率下约 7× 更快、约 200× 更低推理费用。Jev 每个故障五次,LLM Agent 每个故障三次;它们是分开的实验,不能当作同步受控的逐次对照,也不能代表当前排行榜队列。
这种全过或全败的分布,比单一平均成功率更有启发。重复同样流程并没有消除某些故障的盲区。对部署者而言,需要按故障类型看覆盖和失败原因;用多次重试把平均数凑高,可能只会重复同一个错误解释。
选错线索与缺失线索,需要不同改进
第一类失败是证据已经存在,但 Jev 选错。CPU 饱和案例同时提供昂贵正则与资源限制变化,模型选择后者,定位了受影响组件却没有解释真正机制。这里可以追问的是候选证据如何比较、是否需要更强的因果检查,而非继续收集同样的配置。
第二类失败是关键动态证据根本没进入输入。重试放大案例中,队列、超时和跨服务重试形成反馈;流水线没有提供队列深度与重试次数等指标,又要求选择单一根因组件。即使判断器总能选出当前选项中最合理的一项,正确的跨服务解释也可能不在可表达范围里。
由此可以得到一个实用的诊断顺序:先检查报告所需事实是否出现,再检查选项能否表达机制,最后检查选择是否合理。否则,所有失败都会被归到“模型不够聪明”,更换模型却未触及真正限制。
作为快速入口,而非完整故障处理闭环
把这类流水线放在调查前端,有机会快速整理常见配置故障的证据,让更灵活的 Agent 或人员处理复杂情况。但升级条件不能简单依赖它是否生成了报告:固定模板总能生成完整句子,证据却可能不足。更有意义的条件是证据覆盖、解释是否跨组件,以及是否出现未能解析的状态。
还需要区分观察与行动权限。诊断报告给出候选原因,不意味着应该立即修改线上配置。若要扩展到自动修复,需要另行设计动作验证、影响范围与恢复路径;本次文章没有用诊断分数验证这些能力。
评价这一设计时,还应观察无法得出结论的情况。允许系统承认某个候选证据不足,可能比强制选出一个原因更适合后续调查,但也会降低立即给出答案的比例。因此应把正确定位、错误解释和主动保留判断分开统计,而不是只优化报告提交率。这个判断来自流水线的有限选项结构;原文的通过率尚不能回答不同升级策略之间的取舍。
优先读工作流程与两个失败案例。 这项探索的价值,是把快速判断与证据工程的关系讲得具体:低成本模型能在明确边界内有效工作,而复杂事故往往要求改变采集粒度、时间视角和答案结构。更丰富的跨服务、随时间变化的证据,是文中下一步方向。