没有真实 GPU,也可以先验证多租户 GPU 平台的控制路径。CNCF 这篇实验把 Kamaji 的托管租户控制面与 HAMi 的分片资源调度接起来,重点检验 API server 能否穿过 Konnectivity 调到租户侧 webhook,以及显存和计算配额是否影响调度。它的成果是可观察的接线与资源决策,适合在采购硬件前检查平台组合。
原文:Multi-tenant GPU Kubernetes on simulated hardware with Kamaji and HAMi
Anish Bista · CNCF · 2026-10-23
两个项目分别解决哪一层问题
每团队一套独立集群能提供独立 API 和控制策略,但控制面也占资源;把团队放进共享集群,则需要另外设计租户边界。Kamaji 把租户 Kubernetes 控制面作为 Pod 放到管理集群,保留各自 API server、scheduler 和 controller-manager,以共享承载方式减少专用控制面机器的需求。
HAMi 处理租户内部 GPU 资源粒度。工作负载可申请显存 MB 与计算百分比,同一卡可以放多个 Pod,避免每个小任务都独占整张卡。两个项目并不替代对方:Kamaji 管理集群和控制面边界,HAMi 决定某个租户节点上的 GPU 份额如何分配。
实验中 tenant-a 和 tenant-b 分别拥有 worker,不共享节点或 API server;共享的是管理集群和 kamaji-etcd 存储服务,租户数据分开保存。这不是两个租户在同一物理 GPU 上竞争的演示,也没有证明管理基础设施不存在共同故障点。隔离范围应按组件理解,而非一句“完全隔离”覆盖所有层次。
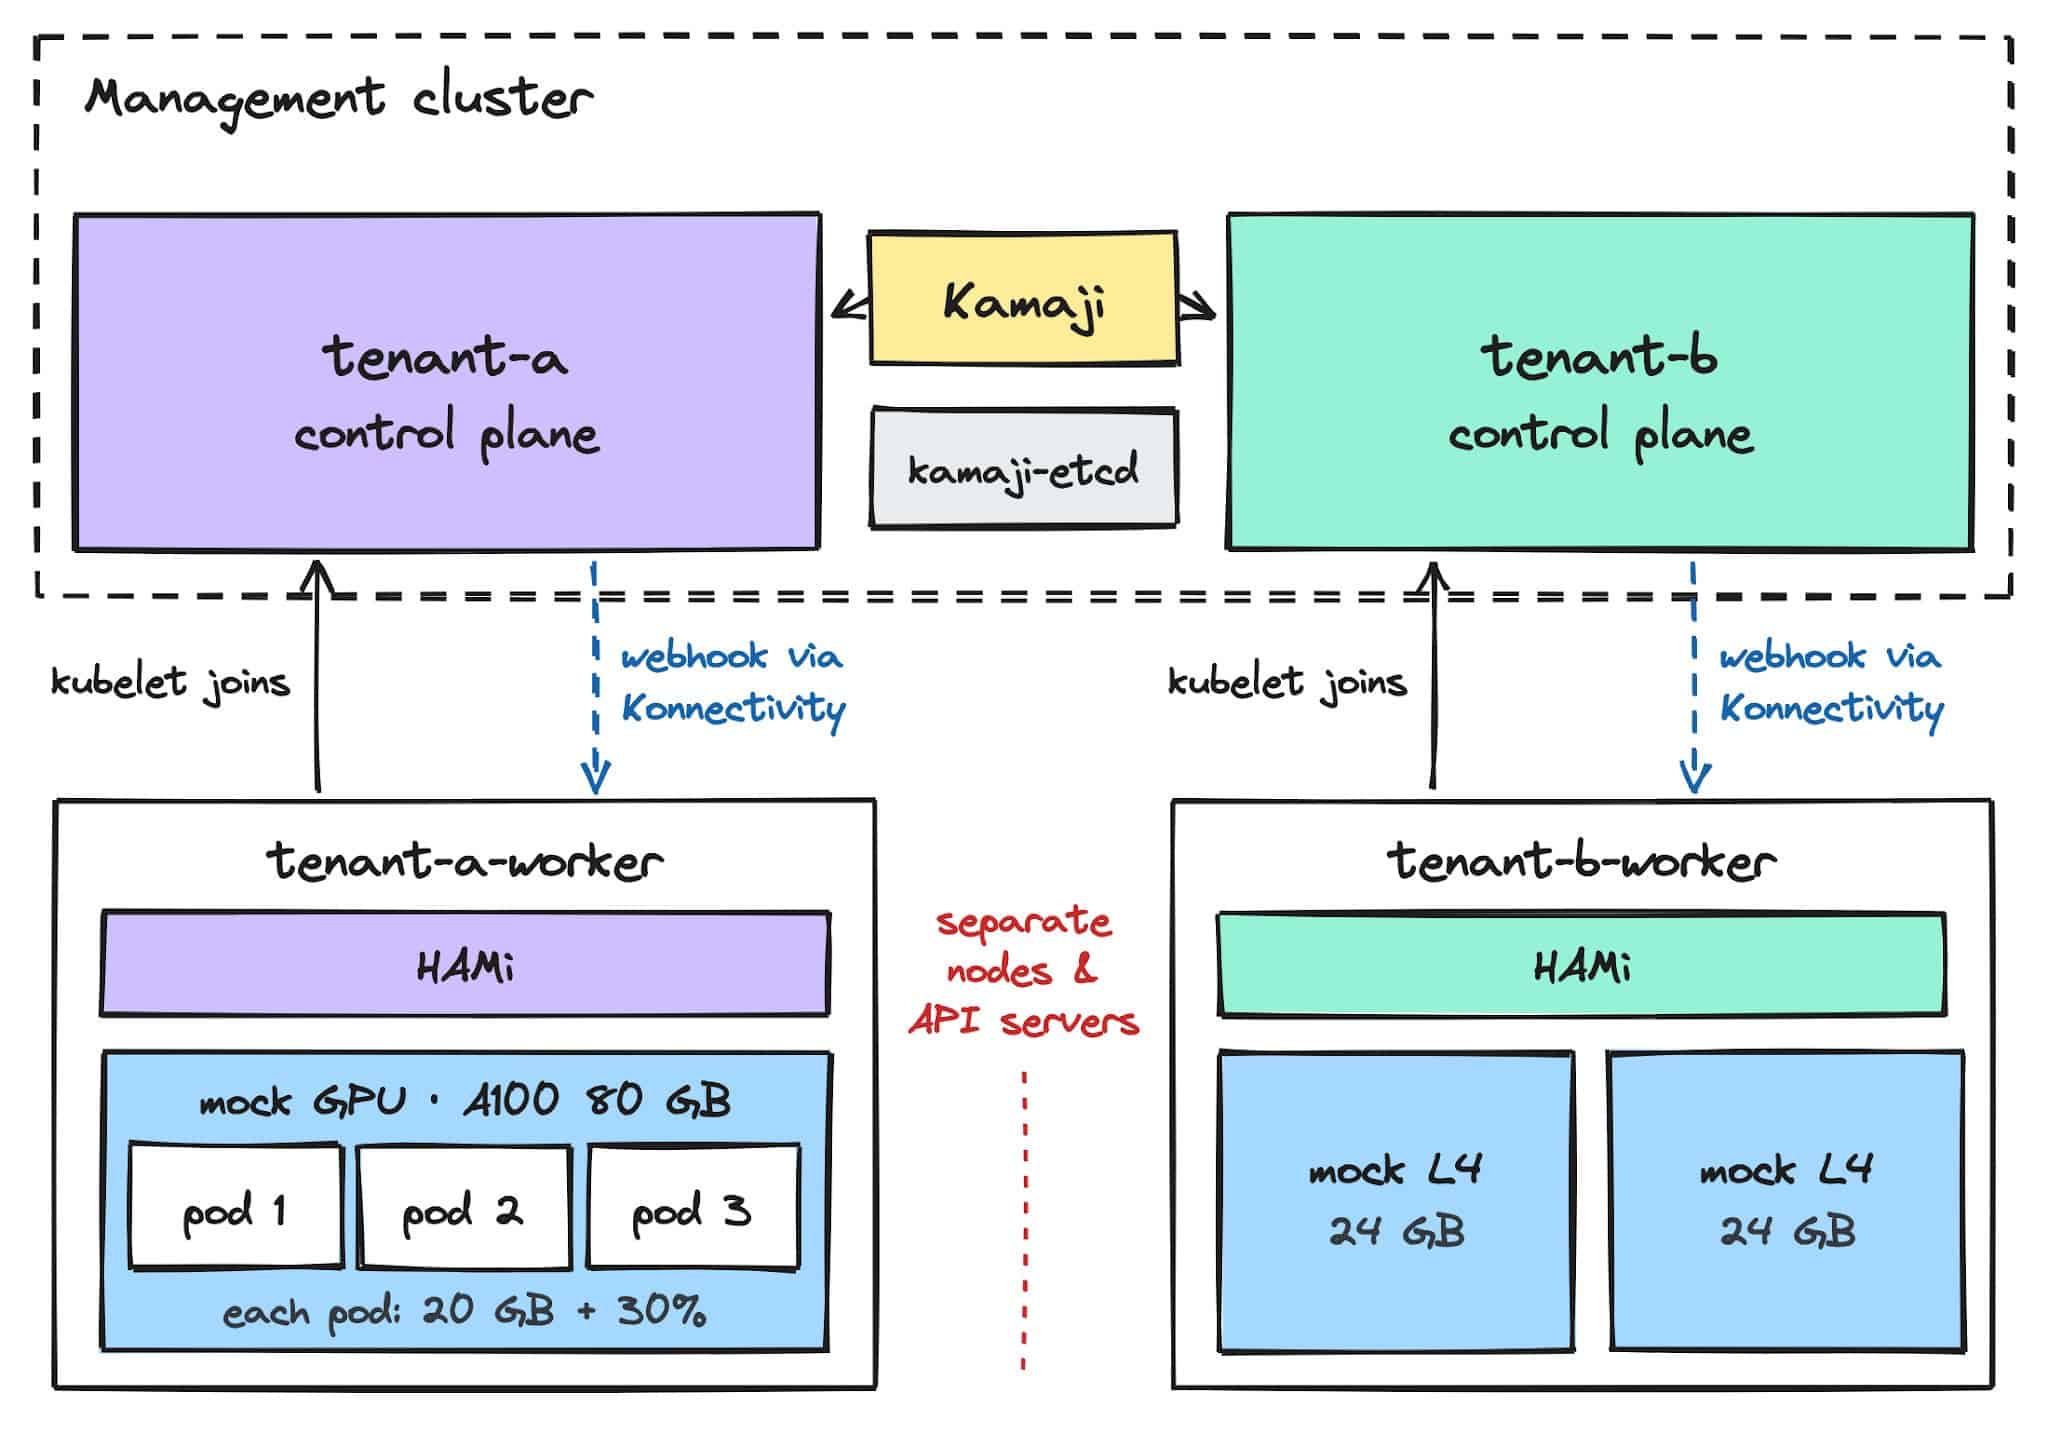
上方托管两个独立控制面;下方各 worker 运行 HAMi 和模拟 GPU,虚线表示 webhook 的隧道路径。
最关键的跨边界调用
租户 API server 在管理集群内,HAMi webhook 却在租户 worker 上。创建 GPU Pod 时,准入请求必须经 Konnectivity 隧道进入租户网络,让 webhook 设置相应调度路径,之后 HAMi 才能根据 GPU 资源信息选择节点。控制面托管得起来,并不自动说明这条反向访问能工作。
因此,本文的集成价值在于把 Pod 创建、准入、调度和绑定串成可检查过程。若 webhook 不可达,仅看控制面 Pod Running 无法解释 GPU 请求为何没有进入预期调度器;需要同时查看 schedulerName、分配注解和事件。对分离控制面与数据面的架构,这种跨域依赖比组件各自启动更值得优先验证。
Mock 设备到底模拟了什么
作者在一台 Linux 主机上运行 Docker 容器,建议至少 4 核 CPU、8 GB 可用内存和 20 GB 磁盘。一个 kind 集群承载管理组件与两个租户控制面,各 worker 是独立的 kindest/node 容器,通过 kubeadm 加入对应租户。网络还涉及 MetalLB、Calico 与 Konnectivity。
真实 HAMi device plugin 需要 NVIDIA 驱动。Mock plugin 跳过硬件发现,根据节点注解注册假卡容量;webhook、scheduler 和配额逻辑则沿真实软件路径工作。tenant-a 模拟一张 A100 80 GB,容量 81,920 MB、100 个计算单位;tenant-b 模拟两张 L4 24 GB,总计 49,152 MB、200 个单位。这里单位来自资源模型,不能当成实际硬件核心数量。
节点上 nvidia.com/gpu 的容量值还代表可分配的共享槽位。实验把一张模拟卡设为 10,两张设为 20;若只看这个整数,就会误以为创建了十张或二十张物理卡。理解设备标识、容量和槽位之间的区别,是核对分片调度结果的前提。
八项测试支持什么结论
作者报告八项测试通过。最直观的是三个 Pod 各申请 20,000 MB 与 30% 计算份额,在 tenant-a 的同一模拟卡上获得调度,共占 60,000 MB 和 90%。第四个同样请求会把计算份额推到 120%,因 CardInsufficientCore 保持 Pending;单个申请 90,000 MB 的 Pod 则超过整卡容量,以 CardInsufficientMemory 被拒绝。
这两种失败分别检验计算与显存约束,而不是只证明“能启动几个容器”。租户可见性测试还分别向两个 API server 查询节点、Pod 和资源容量,每边只返回自身 worker 与对象。它证明展示配置中的 API 可见性边界,尚不覆盖底层网络攻击、存储隔离或真实 GPU 运行时干扰。
一个重要人工步骤隐藏在连续调度之间:真实插件分配完成会释放节点锁,mock 插件不会。作者手动标记 bind-phase 成功并删除锁,使后续 Pod 继续绑定。若不做,可能出现五分钟的锁等待。这个现象属于 mock 生命周期不完整,不能直接归因于 Kamaji 或 HAMi 的生产故障;手动解锁也不是可原样搬到真实集群的常规策略。
从控制路径验证走向真实平台
实验没有执行 CUDA 工作负载,没有真实显存限制或计算份额执行,也没有吞吐与 noisy-neighbor 数据。容器里运行的是等待进程,即使 Pod Running 也不代表 GPU 份额已得到运行时保障。真实部署仍需验证驱动层执行、资源回收、并发干扰与故障恢复。
worker 容器加入方式属于实验路径,Kamaji 的受支持路线是实际机器上的 kubeadm 或 Cluster API。共享管理层的容量、可用性与租户升级,也属于接线通过之后的新问题。它们不会削弱这个实验的价值,而是明确下一阶段该测什么。
值得借鉴的是验证顺序:先确认托管 API 到租户 webhook 的可达性,再测试允许、拒绝和租户可见性,最后用真实 GPU 验证执行隔离与性能。本文把“两个项目应当能协作”推进到一个有故障现象和检查证据的实验,而非给出了可直接宣称生产隔离的 GPU 平台。
为什么负向测试比 Running 更有信息
只让三个 Pod 运行,可能无法辨别它们是经过 HAMi 分配,还是被其他调度路径放到了节点上。第四个计算请求和超大显存请求被拒绝,再结合分配注解与事件,才形成更完整的因果链:请求进入了预期调度器,容量被累计,超额条件触发了对应判定。这里的因果链限于控制逻辑,不涉及真实设备执行。
租户检查也可以沿相同思路理解:分别查询两个 API,确认对象与容量不同,比只看两个控制面名称更有说服力;但这些查询并未模拟恶意管理员或管理集群失陷,不能扩展成安全攻击面的完整验证。原文的八项测试更适合被视为功能回归的起点。
从实验移到硬件时,最先补上的应是 mock 所缺的生命周期:设备发现、分配完成通知、锁释放、进程退出后的资源回收,以及驱动故障时容量如何更新。若这些事件没有进入观察,即便静态配额正确,长期运行仍可能遇到资源被占住或状态与设备不一致的问题。这些是由模拟边界推导出的检查方向,并非本文已测出的生产缺陷。