Agent 把工具结果放回对话,再把轨迹用于 RL 时,一个隐蔽风险是:生成过的 token 经过解码和重新编码后,文本不变,token ID 却变了。Sasha Rush 的原型将 tokenizer 与消息渲染一起纳入形式化规格,试图让训练和推理共享的历史不再依赖“看起来相同”。
原文:Lean Verified Tokenizers · Sasha Rush;作者于 2026-10-27 公开介绍该原型。
证明针对的是具体实现和具体规格
实现使用 Rust,通过 Aeneas 提取为 Lean,再证明提取后程序的性质。BPE 规格明确规定每次选最低 rank 的可合并相邻对,平局取最左位置。连接实现和规格的定理,比“很多样例都能往返转换”更强,但仍依赖合并规则有效等前提,并信任 Rust 到 Lean 的提取过程。
消息渲染采用固定的 Qwen 风格分隔符和转义处理,不使用任意修改整段历史的全局模板。相应性质包括消息渲染后解析可以恢复角色与内容,以及追加消息时,旧字节序列保持为前缀。它们不是对所有现有 Jinja 模板的证明。
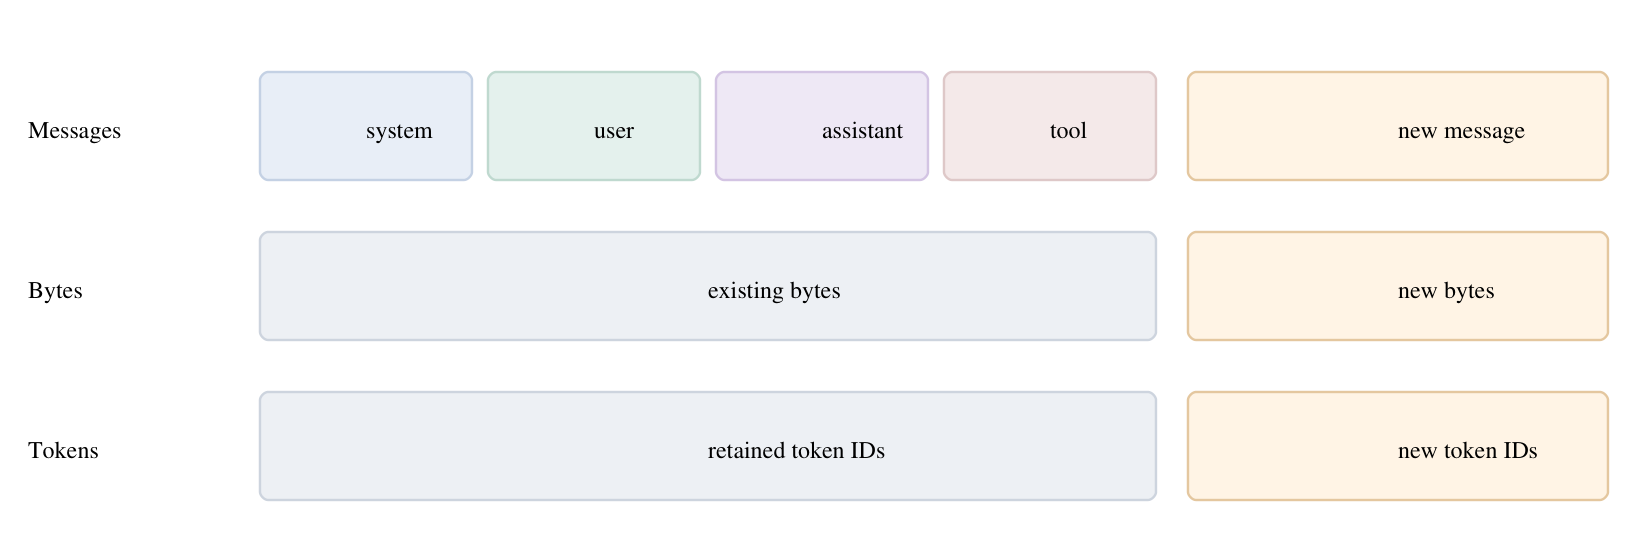
每行右侧仅追加新内容,左侧原有消息、字节和 token ID 保持前缀;关键是不要重分词已经生成的 token。
不重分词,才能保住生成轨迹
应用遵循 Tokens In, Tokens Out:模型生成的 token 原样保留,新增工具消息只把新字节编码为新 token,连接到旧流后面。消息、字节和 token 三种表示同步扩展。这里保证的是已保留 token 的一致性,不是声称 BPE 对任意字符串拼接都天然可交换。
原型还讨论在历史中插入消息:在固定 renderer 的局部性、有效性和长度条件下,插入新增内容的 token,仍可保留两侧原 token ID 并恢复编辑后的对话。这个性质可能用于换上下文重新评分,但不能外推到所有 tokenizer 的任意编辑。
值得关注的是证明边界足够具体:验证过的操作、有效输入和规格假设构成保障,整个 RL 系统并未被证明无误。当前实现受 Aeneas 支持的 Rust 子集限制,不支持多线程 tokenization,也没有给出完整训练收益或吞吐结论。它为 Agent 基础组件提供了一个可检查的接口契约范例。