多轮 Agent 把推理服务从一组独立请求变成带有历史状态的工作流:下一步会重复很长的前缀,工具调用结束后突然回来,一批后台任务还可能与交互用户争抢同一批加速器。llm-d 1.0 值得关注的地方,是把缓存、路由、流控和模型服务器编排放进同一个 Kubernetes 服务体系。它处理的是多个引擎如何协作,单个引擎的 token 生成速度只是其中一部分。
原文:Announcing llm-d 1.0: Open distributed inference for agents on Google Cloud TPUs and GPUs
Mark Lohmeyer、Sean Horgan · Google Cloud · 2026-10-20
一次请求,至少有三个决策
可以从三个工程问题理解这套栈:现在是否允许请求进入,送到哪份副本,以及让哪一组资源处理输入和生成。原文将前缀与负载感知路由、分层缓存、阶段拆分和优先级控制组合起来。它还报告了 1,000 个沙箱 Agent 访问统一端点的演示,但演示规模并不等于所有模型、硬件与流量组合都已获得同样服务质量。
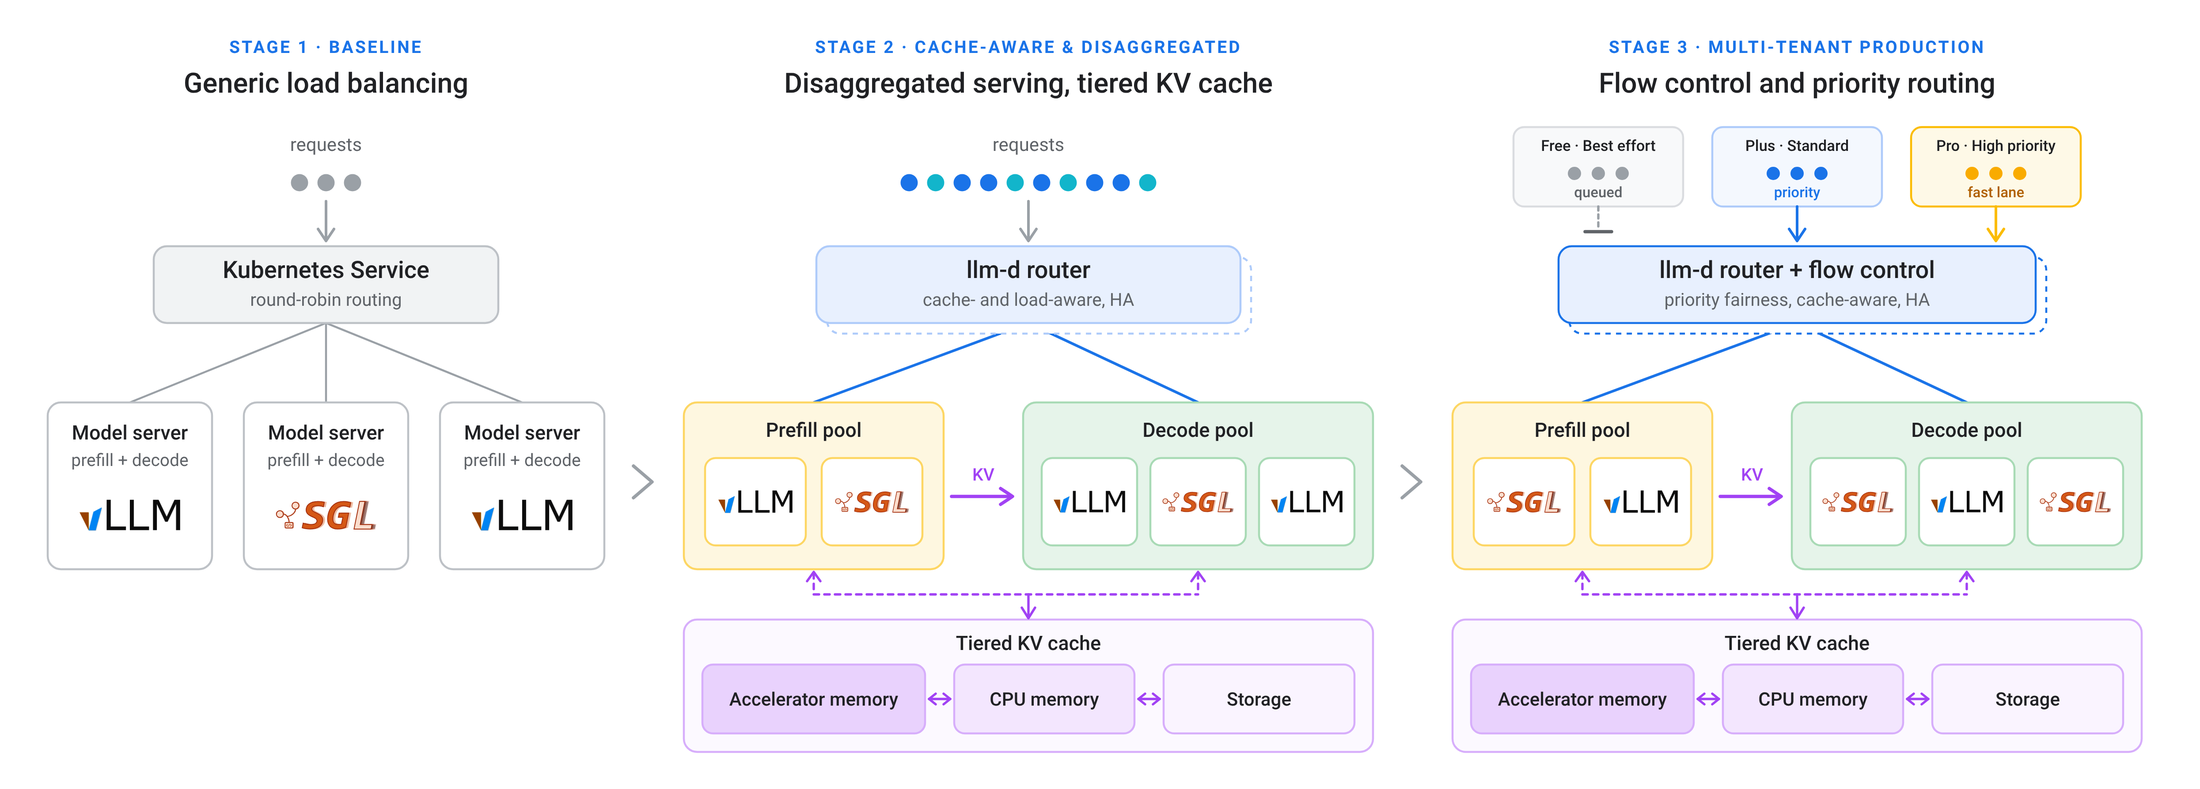
读图:左边是普通副本分发,中间加入阶段分离与缓存层,右边在入口区分请求优先级;三列表示能力演进,不是同一条件下的性能曲线。
这三个决策不能各自只优化一个局部指标。缓存最热的副本可能排队最长;最空闲的副本可能需要重算大量上下文;一味追求设备利用率又可能让交互请求等待后台任务。因此,评价调度效果应回到完成时间与服务目标,而不只看命中率或利用率。
缓存扩容之后,还要知道去哪里找
分层前缀缓存指南说明,模型服务器可以把从加速器内存逐出的 KV 块卸载到主机内存,并可继续扩展到共享文件系统;后续请求复用前缀时再装回。路由还会考虑 CPU 层缓存的位置。这样,扩展缓存容量与寻找已有状态成为相关的两个问题。
是否值得取回,仍可用一个简单的工程关系判断:查找、排队和搬运缓存的总耗时,应小于重新计算前缀的耗时。长前缀和重复轮次增加潜在收益,但存储拥塞、低复用率或过热副本可能抵消收益。这个关系用于解释设计,不是 llm-d 对任意请求的延迟保证。
指南还指出,vLLM 的主机缓存会计入 Pod 内存限制。把 HBM 压力转移到 CPU 内存,并没有消除容量约束;缓存大小、容器资源限额和路由索引容量需要协调。仅看到推理请求成功,也不足以证明卸载和重用路径正在发挥作用。
阶段拆分使升级变成跨角色问题
Prefill 建立输入的 KV 状态,decode 逐步生成后续 token;两者的计算与内存访问特征不同。分开资源池能独立配置容量,却增加状态传输和生命周期协调。DisaggregatedSet 设计文档用一个上层资源管理不同角色对应的 LeaderWorkerSet,让滚动升级考虑多个角色之间的关系。
其运维含义是“某个 Pod 已就绪”不等于完整服务路径可用。如果旧 prefill 已退出,而兼容的新 decode 尚未准备好,局部健康仍可能对应整体中断。这里应把发布时的容量、版本兼容和路由切换一起验证。设计文档属于 dev 版本,具体可用性预算应按部署版本核查;不能把公告中的平滑升级表述当成任意配置都零中断的保证。
后台吞吐需要明确的准入边界
Async Processor 文档描述了从消息队列取任务、经准入与容量检查后发往推理网关的路径。队列层检查可以拒绝并重新投递,资源池层检查可以等待容量;请求带有截止时间,失败后的重试受截止时间约束。这让延迟不敏感工作能够利用剩余容量,而不必在提交时就占住全部执行资源。
工程上,这类等待应进入任务端到端耗时,而不能只报告模型实际生成阶段的速度。还需要区分延期、拒绝和失败:交互流量得到了保护,不代表后台任务仍能在可接受时间完成。评估多租户策略时,既要检查高优先级延迟,也要检查低优先级完成量与最长等待。
缓存收益要放回完整会话中衡量
一个可用于评估的假设场景是:同样的请求集合,一次连续提交,一次在工具执行后间隔数十秒再回来。第二种情况下,缓存可能已经逐出,副本负载也可能改变;即使前缀相同,收益也未必与第一种相同。因此,多轮基准应保留轮次间隔,而不是把会话压成一串没有等待的调用。
冷启动也应单独观察。新副本加入后没有已有上下文,路由若持续偏向旧副本,扩容效果可能延迟出现;若立即均匀分流,又会增加重算。这是缓存局部性与容量扩张之间的自然张力,需要通过负载与缓存状态共同判断,而不是把固定会话绑定当成普遍答案。
此外,模型或配置升级会改变状态兼容条件。前缀文本相同并不足以说明旧 KV 一定能复用。系统需要把命中、状态有效性与版本切换分别处理;否则性能优化可能跨过本应保持的正确性边界。
公开数字说明到哪一步
Google Cloud 报告,在 Ironwood TPU(TPU 7x)的 Agent 编码工作负载上,前缀感知路由加主机内存卸载,相比普通 Kubernetes Service,使中位首 token 延迟下降超过 85%,总吞吐提高 2.4 倍。这里比较的是一组组合优化与一个基础路由基线,不能把收益分别归给路由或缓存,也不能外推到无重复前缀的请求。
文章没有在该结果旁完整列出模型版本、并发与提示分布,因而不足以单独建立可移植的性能预期。阅读价值仍然明确:先看自身流量是否存在重复上下文与冷热不均,再判断路由和缓存是否解决主要瓶颈;只有在阶段争用成为问题时,再评估拆分资源池的收益与传输成本。
对推理基础设施而言,这次发布把优化重点扩展到了状态位置、流量公平性和升级过程。合理的采用顺序是逐层加入能力,并在相同工作负载下观察首 token、后续 token、完成率与成本的变化。这样才能分清节省了重算,还是只是把等待移动到了另一个队列。