LMCache · 推理系统入门与工程解读 · 2026-10-01
原文:Intro to KV Cache and LMCache (Part One) · 项目
先抓住这篇文章的定位
这是系列的概念入门,不是一份新增缓存算法的性能报告。它从注意力计算解释 KV cache 为什么存在,再引出 LMCache 想解决的状态管理问题。最值得建立的认识是:缓存保存的是模型已经算出的中间状态,保留这些状态能避免重复计算,但会占用内存,搬运和匹配也有成本。
对多轮 Agent 来说,这个问题尤其直观:系统提示、仓库上下文和之前的对话不断出现在后续调用中。如果每次都重新处理相同前缀,GPU 会反复做已经完成的工作。反过来,把所有状态永久留在最快内存里,又会挤占新请求的空间。
以下将原文的概念说明与工程推导结合起来;本文的估算例子用于理解,不是 LMCache 的实测结果。
缓存存的不是权重,也不是最终回答
在注意力层中,输入表示经过固定权重投影,产生 Query、Key 和 Value。新位置的 Query 与允许读取的历史 Key 比较,再对对应 Value 加权。模型权重在推理时固定,而 K/V 随请求内容、token 位置和层变化。
对标准因果自注意力,在相同执行条件下,追加未来 token 不会改变已经算好的历史 K/V。因此,生成下一 token 时可以复用历史状态,只追加新位置的 K/V。当前 Query 在这一步使用后,通常不需要像历史 K/V 那样长期保存。
这里的“相同执行条件”很重要。相同的一句话放在不同前文后面,其中间状态未必一样;可复用前缀还要匹配模型及相关执行配置。语义相似的文字也不等于相同 token 前缀。KV 缓存不同于“这个问题以前回答过,直接返回答案”的响应缓存。
Prefill 和 Decode 怎样使用同一份状态
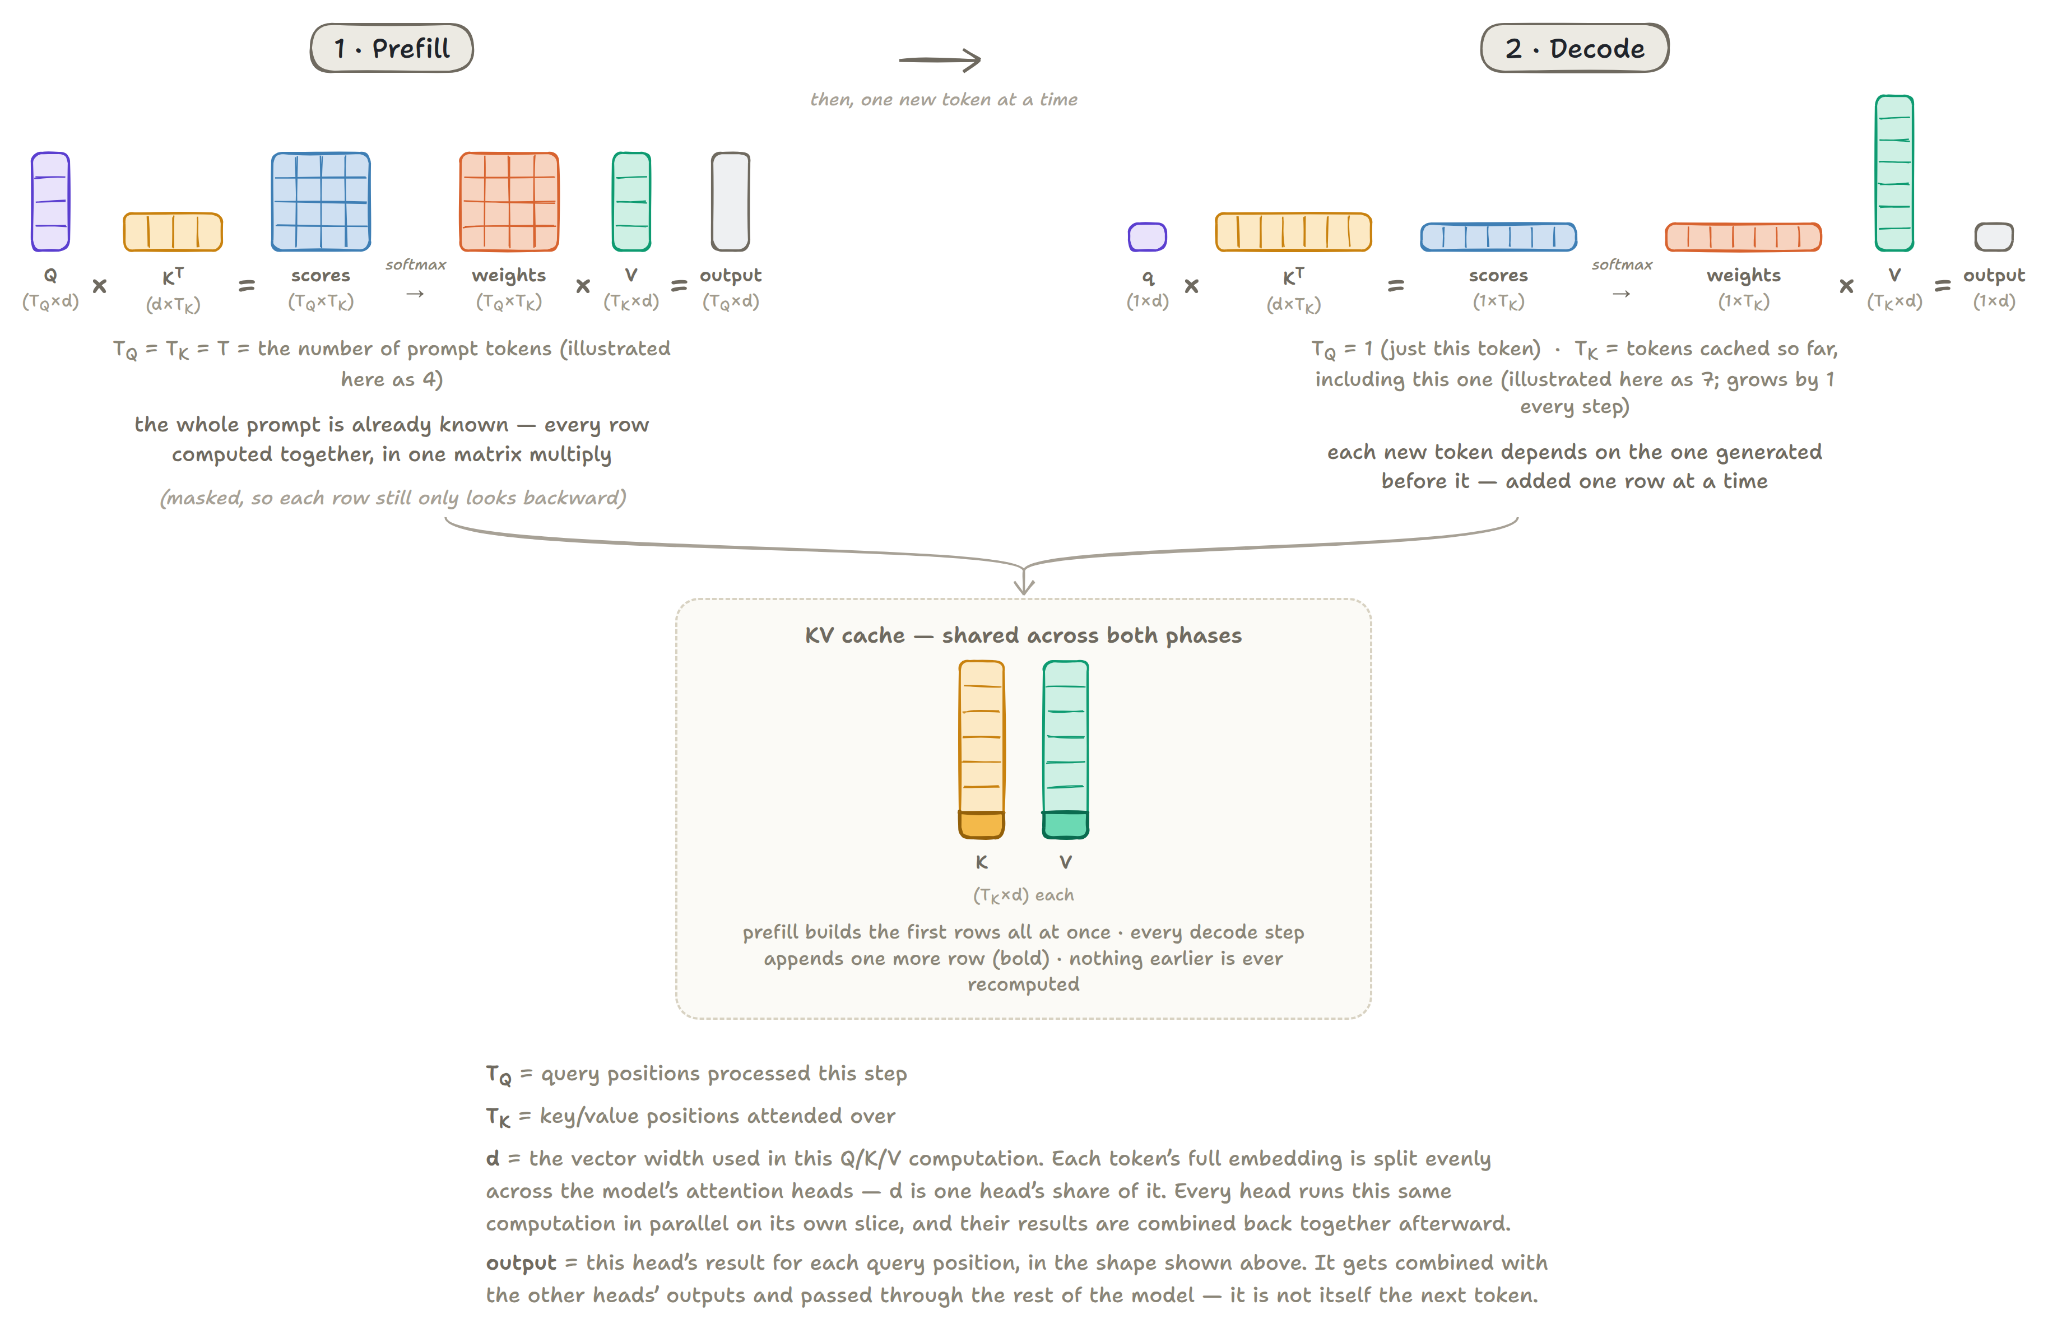
读图:左边 prefill 处理输入序列并产生各层 K/V;右边 decode 处理新位置,读取已有缓存,再追加自己的 K/V。底部缓存连接两个阶段。
Prefill 可以并行处理已知的输入位置,建立上下文状态;decode 则沿自回归依赖逐步产生后续 token。缓存省掉的是为旧位置重新执行模型以重建状态的工作,并没有消除新 token 对历史上下文的注意力计算。
所以,“用了 KV cache,之后每个 token 都一样快”并不成立。在全注意力设定下,随着上下文变长,每步仍要读取更多历史 K/V。多轮对话中的时间变化,还可能叠加批处理、调度和显存压力,不能仅凭缓存开启与否解释。
从观测角度,应分开看首 token 延迟(TTFT)、后续 token 延迟和吞吐:避免一段重复 prefill 主要影响前者;缓存读写、并发与调度则可能同时改变后两者。
用一个估算看清内存从哪里来
对标准、各层配置一致的全注意力模型,未考虑分片、量化元数据与分配开销时,可以用下面的近似式估算一条序列的 KV 存储:
其中,2 表示 K 与 V 两份状态,L 是层数,T 是已缓存 token 数,H_{KV} 是 KV 头数,d_h 是每头维度,b 是每个数值的字节数。GQA 中应使用 KV 头数,不能直接代入 Query 头数。
一个假设配置: 24 层、4 个 KV 头、每头 128 维、BF16,每 token 需要约 48 KiB;8,192 token 约占 384 MiB。若 16 条这样的序列完全不共享缓存,合计约 6 GiB。这只是公式估算,尚未计入权重、激活、通信和分配器开销,也不适用于所有采用压缩或特殊注意力结构的模型。
这解释了为什么长上下文与高并发会同时挤压容量。模型参数装得下,不代表目标并发的 KV 状态也装得下;减少 KV 头数、降低缓存精度或复用共享块,影响的也是不同资源维度。
从单次请求的缓存,到可复用的存储层
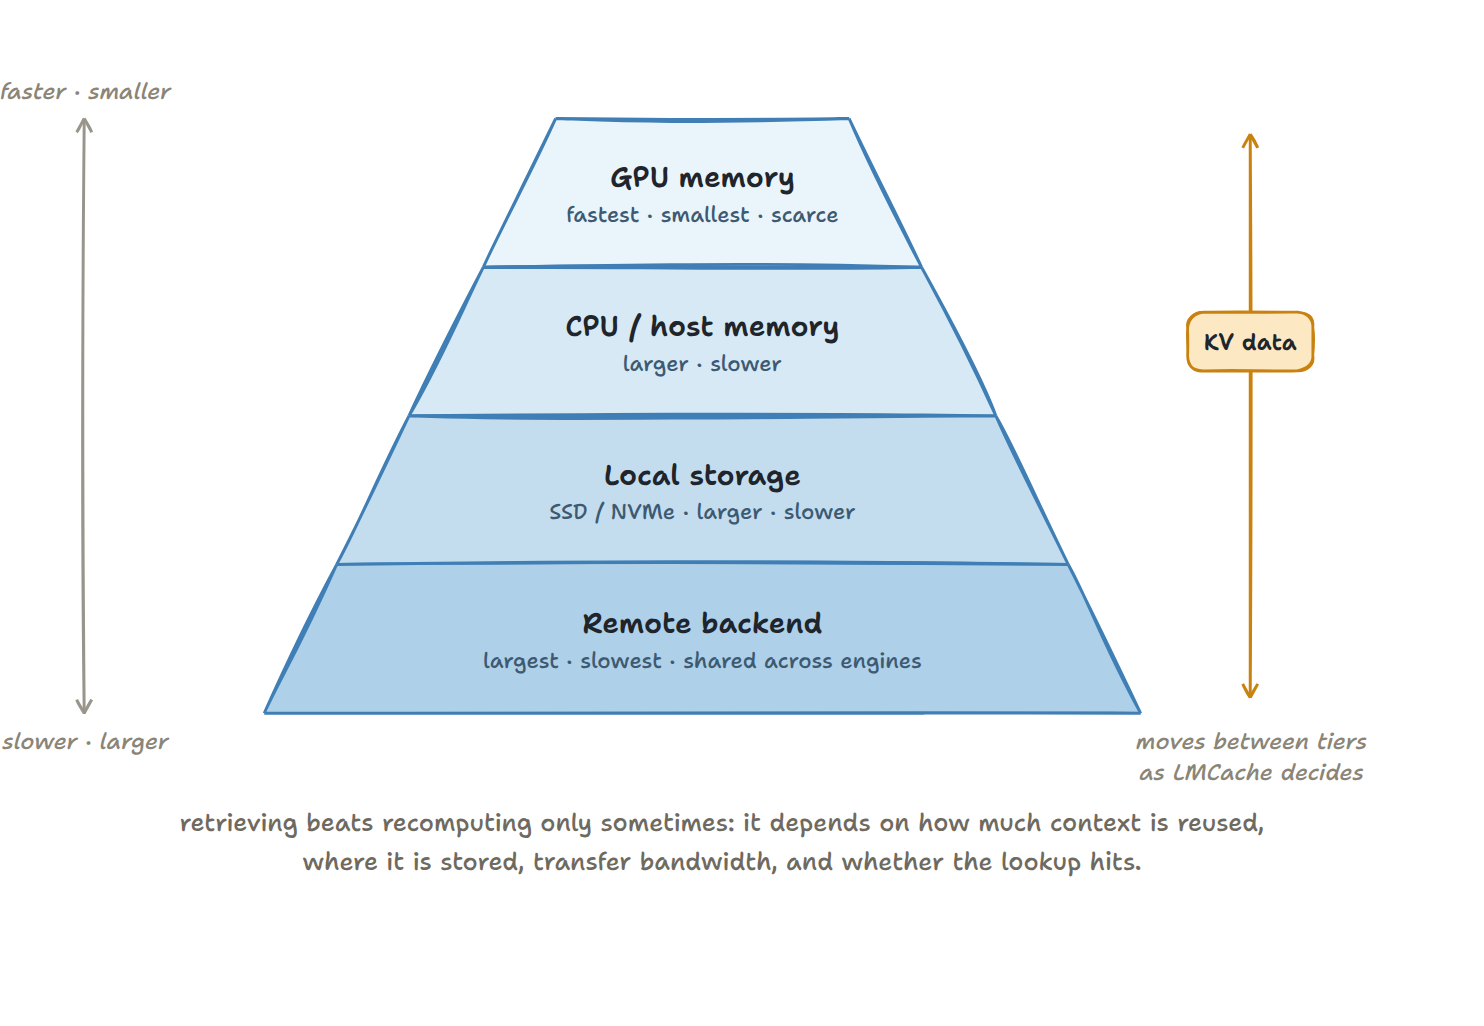
读图:GPU 内存最快但稀缺,向下是主机内存、本地存储和远端后端。往更大层级保留数据,意味着以后取回时要付出额外搬运成本。
原文将 LMCache 定位为把 KV 状态带到单次 GPU 分配、请求或引擎进程生命周期之外的工具。它可以在存储层级间保留和传输状态,让后续匹配请求取回已有上下文,而不是全部重新 prefill。
这不等于每次缓存都该卸载到最慢、最大的层级。热点状态留在近处可能更合适;很少再次访问的状态,保存和索引它未必值得。第一篇主要建立问题背景,详细的协调、传输和存储实现并没有在文中逐项展开,因此这里也不将概念图当作完整部署方案。
什么时候取回缓存才划算
一个便于思考的工程条件是:查询、搬运和安装缓存的总成本,应小于省下的重算成本。 它不是文中的性能承诺,而是评估缓存是否有意义的基本比较。
例如,仅作算术示意,取回 384 MiB 状态,若有效传输速率为 8 GiB/s,单纯搬运约需 47 ms,还没算排队、查找和安装。如果重算本来只需 20 ms,命中也不必然更快;如果能省掉明显更长的 prefill,情况就不同。实际值需要在目标硬件、并发和缓存层级上测量。
命中率同样要解释清楚:命中了多少请求、多少 token、节约了多少计算,并非一回事。一个很短前缀的高命中率,可能不如较少但很长的前缀复用有价值。只展示命中率而没有用户延迟,很难说明系统是否改善。
对 Agent 工作负载意味着什么
多轮 Agent 可能反复携带稳定的系统说明和任务上下文,也会因为工具结果、历史裁剪或提示重排而改变前缀。缓存潜力要从真实序列结构判断,不能把“同一个用户会话”直接等价为“所有状态都能继续使用”。
这也与本期 RETIRE 的问题相接:用户改口后,有些前缀仍有效,有些旧工作必须失去作用。缓存命中解决性能机会,状态有效性解决能否安全使用;两者需要共同成立。此处是跨论文的阅读联系,不表示 LMCache 已集成 RETIRE。
阅读建议: 先理解 K/V、prefill/decode 与内存估算,再查具体版本的集成文档。实际评估应同时比较正确性、冷热缓存、TTFT、后续 token 延迟、并发吞吐和搬运字节数。本篇没有运行服务基准,也不据此给出通用加速倍率。