Siddhant Ray · LMCache 官方技术文章
原文:Finding Reusable KV Caches Across a Fleet of Servers: LMCache’s MP (MultiProcess) Coordinator
本地未命中,不代表整个集群没有
长提示、检索文档和多轮历史可能已在某个推理进程计算过,但请求被分配到另一进程后仍然重算。问题不只在缓存容量,还在缓存是否可见。LMCache 的 MP 模式把管理移出推理进程,多个 vLLM 进程可以连到同一独立服务器,共享缓存服务。这样先跨过进程边界,再留下节点之间如何发现状态的问题。
MP Coordinator 面向第二层边界:维护有哪些服务器、它们报告了哪些缓存及其位置。它不保存 KV 张量,也不是新增的存储层。这个划分很关键,因为缓存元数据与大体积张量有不同的扩展瓶颈;若所有数据都经过中心节点,控制服务本身就可能成为带宽与延迟热点。
从注册到目录,四步各管一件事
服务器先注册并发送心跳,文中当前默认间隔为五秒。注册是尽力而为的:协调器暂时不可用时,MP 服务器仍可继续处理请求。这种可用性边界保住了数据服务,但不意味着协调器失联后仍能获得同样的全局发现能力。
接着是缓存事件。开启事件报告后,STORE、ACCESS、DELETE 分别描述对象加入、访问和删除,可通过 HTTP 或 Kafka 传递。仅注册只能知道“谁活着”,不能知道“谁拥有什么”。这也是部署时最容易误判的一点:实例列表正常,并不证明目录已经收到缓存生命周期。
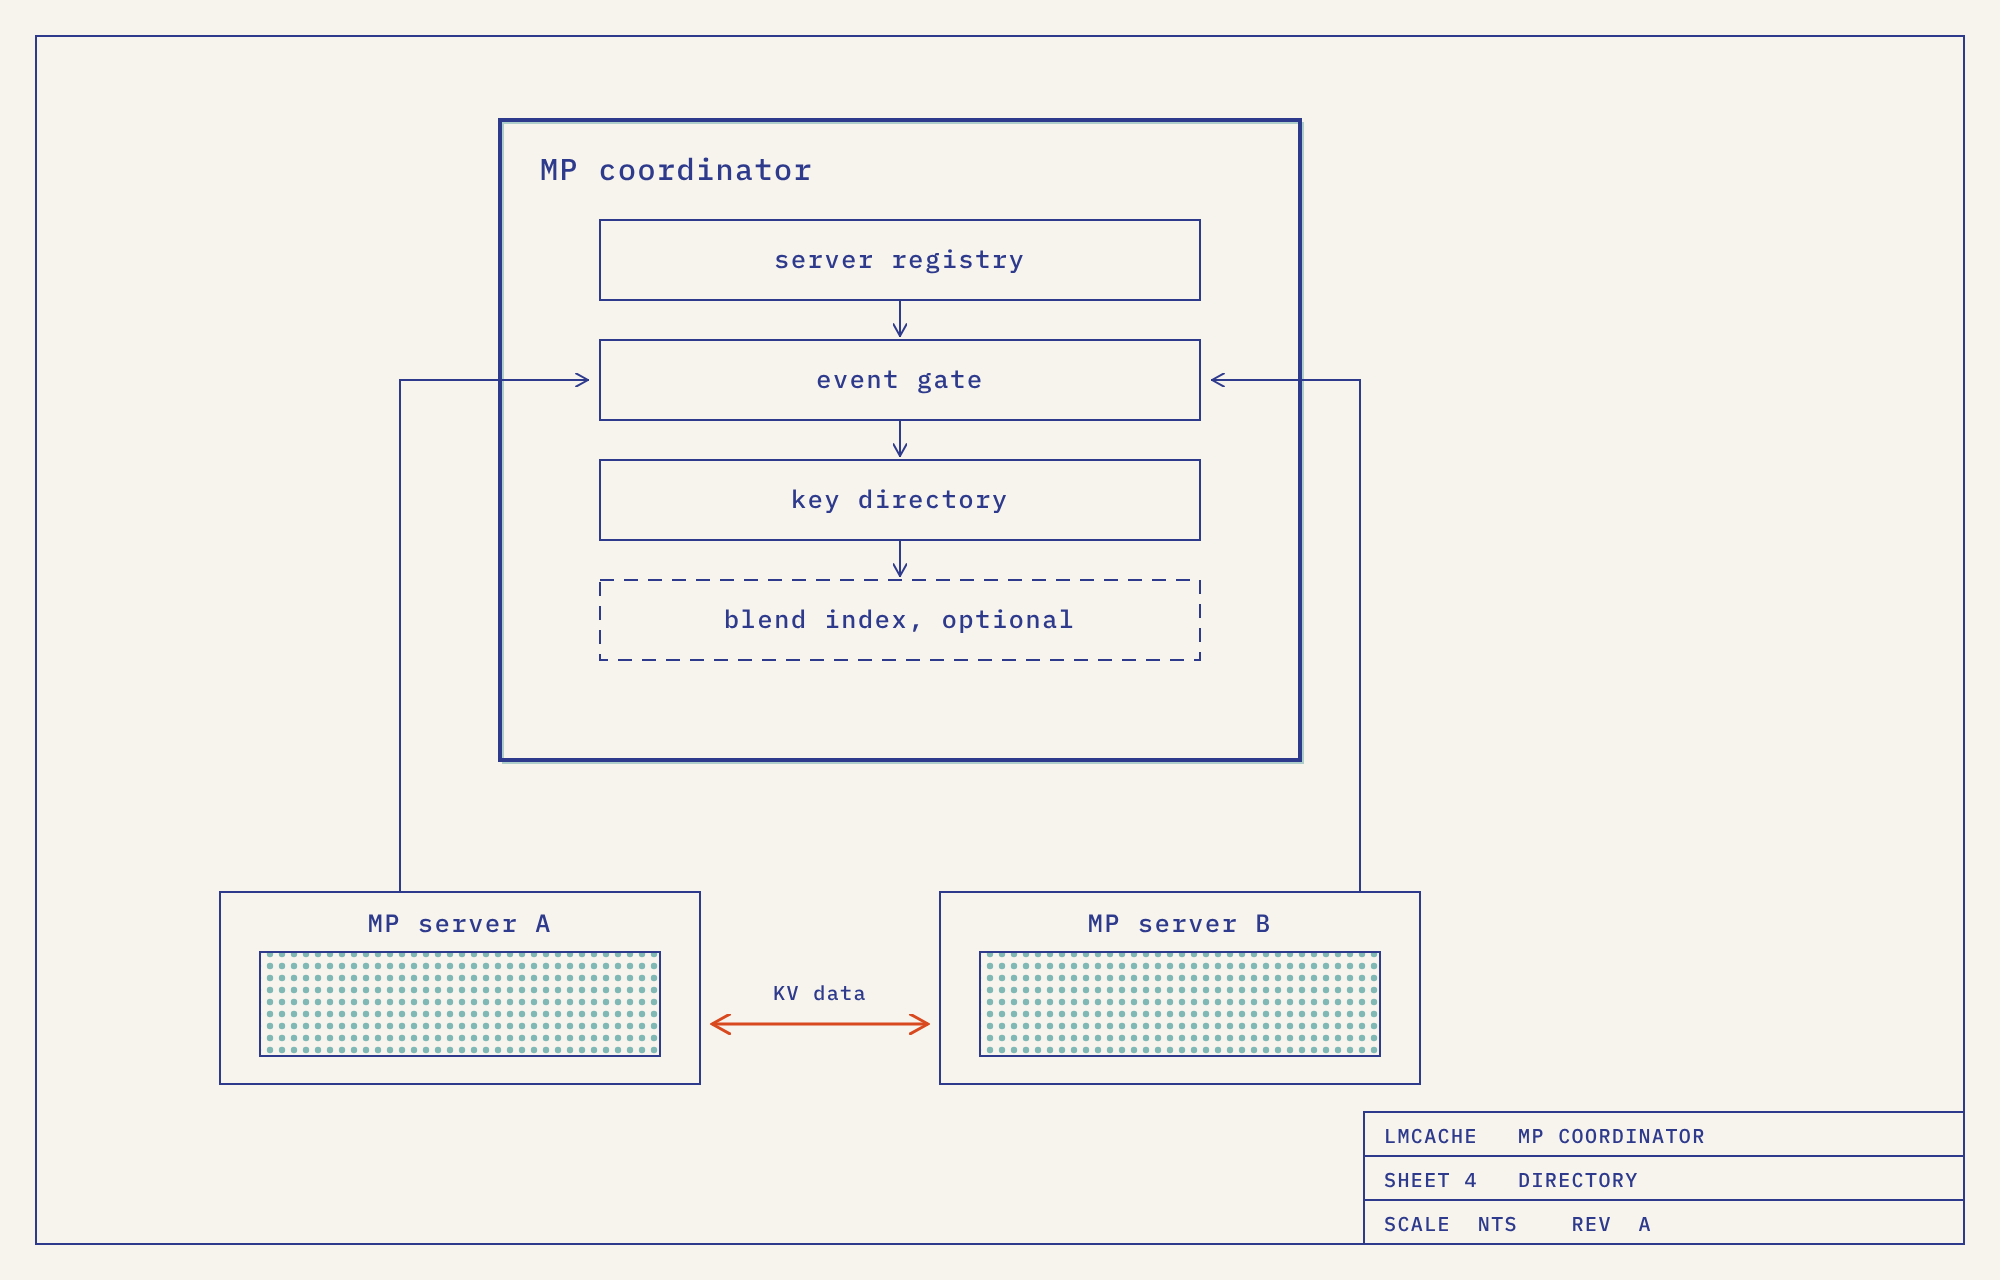
读图:两台服务器向上发送事件,经过 event gate 更新 key directory;底部橙色箭头直接搬运 KV,绕过协调器。虚线 blend index 是可选扩展。
第三步是 Event Gate。网络重试、延迟和进程重启会产生重复或过期事件,门控跟踪每台服务器的事件序列及 incarnation,用来拒绝重复消息和旧进程实例的消息。否则,一个晚到的 STORE 可能把重启前已失效的缓存重新写进目录。这是在状态变更入口处理顺序与身份,而不是给每份张量做一致性复制。
最后,Key Directory 将缓存键映射到放置位置,包含实例、层级、后端和对象大小,并保存 chunk 与 token 的关联索引。普通查询从 token 序列导出完整 chunk 的键,返回已知位置。收到位置后仍需访问拥有者,目录本身不能证明对象此刻还存在。
非前缀发现不等于任意复用已经正确
共享系统提示通常适合前缀命中;检索到的同一文档却可能在不同请求中出现在不同位置。启用 Blend lookup 后,协调器增加内容索引,发现新序列任意位置出现的已缓存 chunk,并返回原位置与新位置。它扩展的是发现范围,与 CacheBlend 的非前缀复用机制相接。
工程上应把“找到片段”和“正确使用片段”分开理解。普通因果注意力的 KV 与前文和位置有关,文本相同不意味着可以把任意中间状态直接搬入。文章介绍目录接口,没有在这里证明所有模型、位置变化和混合方式的精度保持;实际采用仍要依照具体复用机制及兼容条件验证结果。这是根据机制做出的阅读判断,而非原文新增性能承诺。
为什么允许目录暂时不准确
官方将目录设计为最终一致的 soft state:它提供放置提示,拥有缓存的服务器负责验证。如果提示过时,对象已经驱逐,系统可尝试其他副本或重算。允许损失一些命中机会和查询时间,换来不必让每次缓存操作都经过事务一致性协调;正确性要求是失败的提示不能让错误状态进入生成。
当服务器消失或重启,反向索引可集中失效其 L1 放置记录,无需扫描整个集群目录。L2 可能独立持久存在,因此通过自身事件管理,不能把服务器重启简单等价为所有层的数据消失。故障处理的单位必须符合存储寿命,这比“一键清空缓存”的直觉更细。
这里仍有一个容易读过头的地方:当前 P2P 路径使用协调器发现成员,再由 MP 服务器建立连接、直接查询和传输。默认传输引擎为 NIXL,有支持时可用 RDMA。协调器并不是每次 P2P miss 的统一查找服务;目录查询能力和当前 P2P 接入路径要分别看,不能从架构图推断所有请求都已经经过全局键目录。
数字说明扩大复用域的价值
文中引用的 MP 模式实验使用 Qwen3-235B-A22B-Instruct-2507-FP8、八张 H100。基线每 rank 有 50 GB 主机缓存,总计 400 GB,比较方案用同容量共享 MP 服务。平均 TTFT 从 3.98 s 到 0.29 s,P99 从 13.55 s 到 1.30 s,平均解码速度从 9.81 到 37.47 token/s。它说明共享容量与复用方式可能改善服务,不是新协调器让查询快了 13.7×。
另一项更早的 P2P 实验在单机不同 GPU 上运行两个 vLLM 实例,第二个复用第一个已经缓存的上下文。查询轮平均 TTFT 为 0.490 s 对 2.028 s,轮次耗时为 7.964 s 对 38.323 s。作者明确称其为完全复用的刻意构造负载,而且早于 MP Coordinator。两组实验都不能替代协调器自身的规模、故障恢复或目录陈旧度评测。
真正需要验证的运行路径
阅读部署示例时,可按三个问题检查:实例是否注册,事件报告是否开启,KV 数据最终由谁验证和搬运。开启 Blend 索引与配置跨节点 P2P 又是各自独立的步骤,不能认为连上协调器就自动拥有所有功能。本文没有运行原文命令或启动缓存服务。
对于实际评估,除平均与尾部 TTFT 外,还应观察目录命中但拥有者失效的比例、心跳延迟、重启后的清理、跨节点传输字节与重算回退。这些是从 soft-state 设计推导的验证重点,原文没有提供相应完整基准。它最值得关注的变化,是让缓存位置成为可查询的集群信息,同时把大数据传输和最终可用性判断留在服务器。能否节省成本,仍取决于真实前缀复用、传输成本与目录维护负担。