miniTE 报告中最有价值的结果,不只有 NVFP4 learner 比 BF16 更快,还有“局部更快,整轮仍可能更慢”的反例。低精度 RL 同时连接采样、概率重算、反向传播和权重同步;不同阶段即使标着同一种精度,也不保证对同一个 token 给出相同概率。
原文:miniTE Technical Report: Stable and Efficient Reinforcement Learning with Native NVFP4 · LMSYS / InfiX.ai · 2026-10-25。
差异要沿实际执行链定位
报告区分量化相对高精度的误差、检查点转换引入的额外误差,以及 learner 与 sampler 真实执行之间的差异。激活缩放粒度尤为关键:采样逐 token 推进,训练常一次处理整条响应;若外层缩放使用整个张量的最大绝对值,同一个 token 会因为同批的其他 token 不同而得到不同尺度。逐 token 缩放消除了这一项依赖,却不会消除所有舍入、KV 精度、归约顺序和 MoE 路由差异。
因此,miniTE 在比较中先对齐 token 和 expert 身份,再检查量化编码与尺度、expert 输出和 token 对数概率。否则,路由重排造成的排列差异会被误报为数值误差。严格对齐实验将所测区间的概率差异压至约 10⁻⁸,但多项实现选择同时改变,不能视为某个单独算子的因果消融。
TRIAGE 控制残余风险,miniTE 减少执行差异
TRIAGE 根据概率差异和 advantage 的方向调整更新:负 advantage、负 gap 的高风险片段可能进一步放大 learner 的低估,门控只衰减相关 token;另一条有界修复项处理正 advantage 响应里的负片段偏移。64-token 风险分段与 128-token 修复分段承担不同职责。平均 gap 很小,也可能隐藏少量危险尾部。
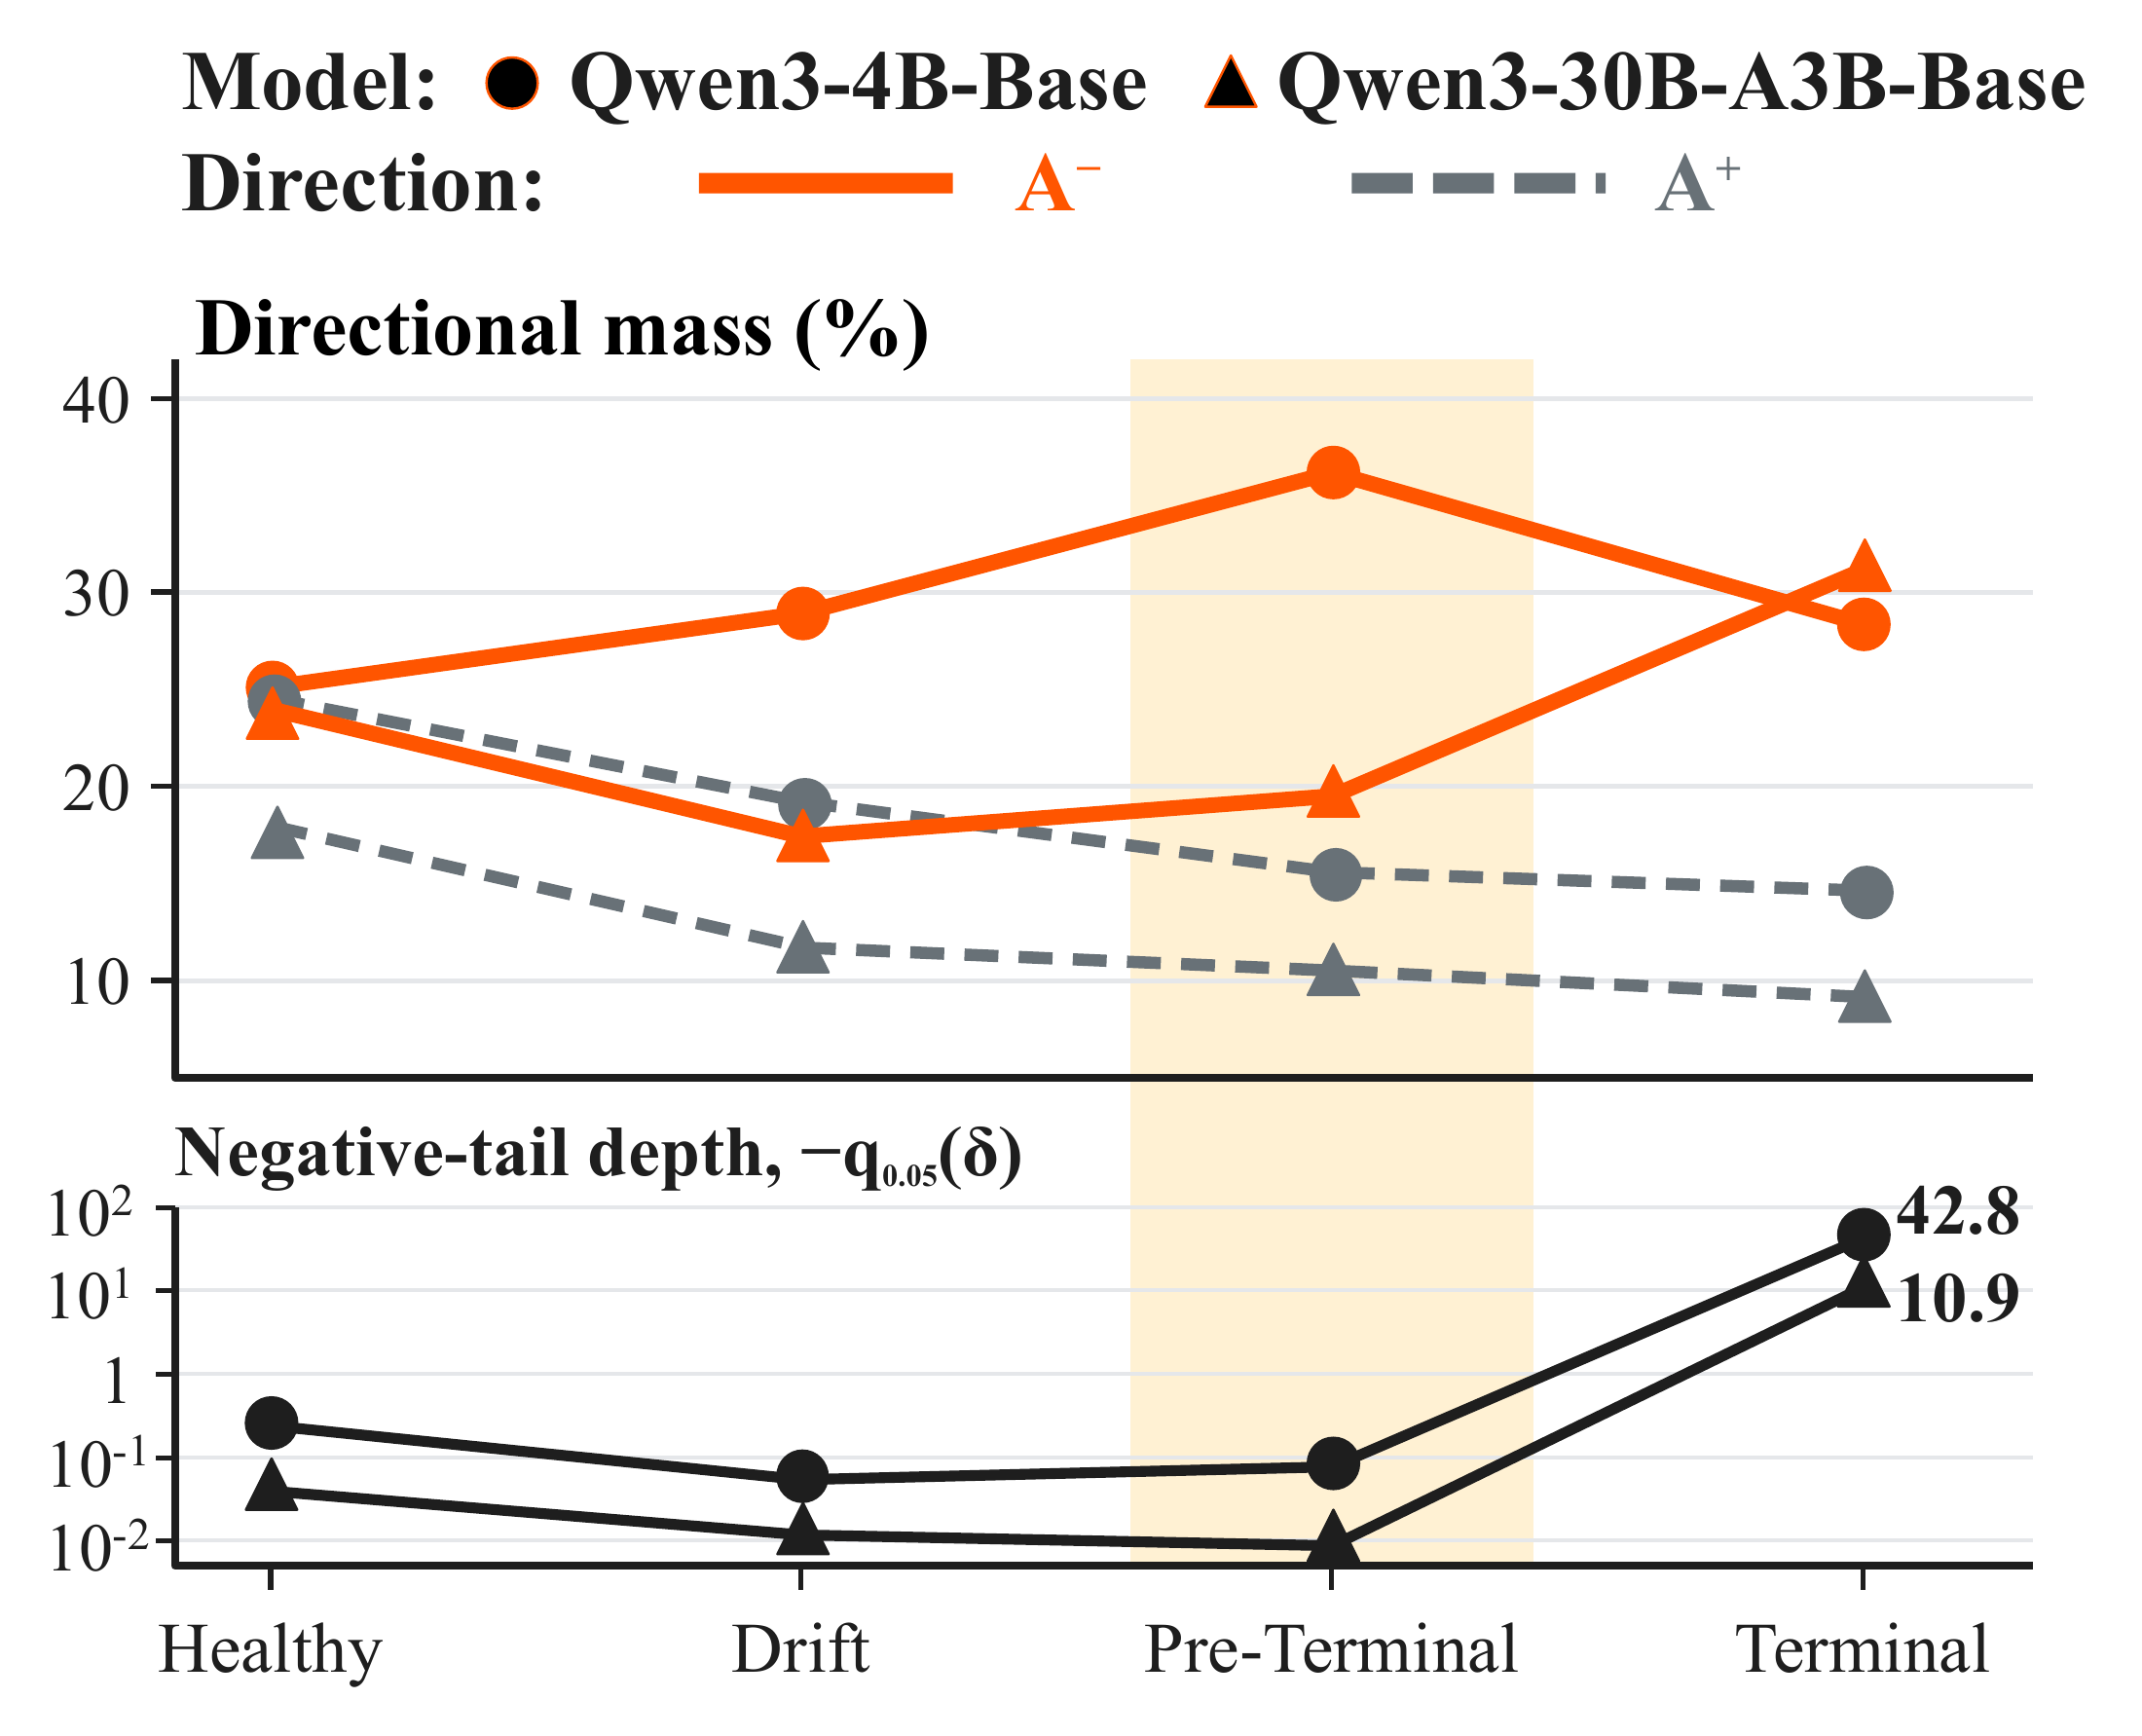
上图按 advantage 方向观察风险分布,下图跟踪负 gap 尾部;每个模型是一条诊断轨迹,不能把阶段曲线当成多次训练的置信区间。
miniTE 则将模块封装、量化策略与 GEMM 后端分开。连续缓冲区和设备侧元数据减少 expert 张量拆分、列表构造与重新拼装;在 permutation 或加权 SwiGLU 产生数据时顺便计算 amax,避免再次完整扫描;将尺度布局转换与量化融合,减少额外访存和启动。前向 NVFP4 和反向精度独立选择,低比特反向并非必然更快。
两条路线的结果来自分开的配置。不能把 TRIAGE 的质量、严格对齐的极小 gap 和 miniTE 的最高吞吐拼成一个已经实测的系统。
看清加速数字包含什么
主要 learner 测试使用 Qwen3-30B-A3B、8×B300、序列长度 4096、micro-batch 1、global batch 128。十次独立运行中,两个 miniTE 路径采用 BF16 backward,配对加速为 1.334× 和 1.369×。计时包括前反向、通信、优化器和数据加载,排除 rollout 与权重同步。
另一个固定输出 serving 测试约为 BF16 的 1.64×,使用八个引擎、每请求强制生成 1,024 token。这是采样栈吞吐,不是整轮训练收益。在线 RL 记录中,miniTE 的训练阶段从 47.04 秒降至 42.56 秒,转换与同步却由 9.94 秒升至 55.26 秒;两阶段合计增加 40.84 秒,且它们仍不是完整迭代计时。报告明确表示该次运行的 rollout 收益没有抵消同步成本。
学习效果也要独立比较:另一组 step-999 检查点的五任务均分,miniTE+TIS 为 56.35%,优于原生 NVFP4 的 54.57%,但低于 BF16 的 58.84%。这些是各配置单条训练轨迹后的重复评测,不是多训练种子的稳定性结论。
最值得带走的是分层验证方法。 算子一致性、长期任务质量、完整 learner 时间和权重转换同步,分别回答不同问题。报告提供了很丰富的机制与负面发现,但最终目标仍是相同质量与资源预算下更有效的训练,不能由一个漂亮的局部倍率代替。