Prefill 与 decode 分开部署以后,两个阶段可以各自扩容,但请求必须把上下文状态从前者送到后者,才能继续生成。vLLM 的 NIXL Push connector 改变的是这次交接的时序:目的端提前准备,生产端在数据就绪后主动写入,将串行等待改为能重叠的工作。
原文:Push-Based KV Transfer to Improve TTFT and TPOT for Disaggregated Inference in vLLM
Sunita Nadampalli(AWS)、Nicolò Lucchesi(Mistral)· 发布:2026-10-14
为什么传得快,首 token 仍可能慢
NIXL 负责 KV 块在实例间搬运,可利用支持 RDMA 的互连。原文在 AWS EFA 上讨论设备内存直接传输,避免先经主机内存中转。然而链路快只是一个条件,发现源地址、分配目的块、准备描述符和提交传输,同样可能卡在关键路径上。
默认 pull 流程中,prefill 完成后,router 才将源端元数据转交 decode;decode 再分配空间、准备传输并发起 NIXL READ。下一阶段等待的不只是数据跨网时间,还包含这些串行控制步骤。如果描述符准备在 decode 主循环同步执行,正在服务的其他请求也可能受影响。
Push 并没有更换整套网络,而是把目的端设置尽量放到 prefill 计算期间完成,并把传输提交交给 prefill 的后台线程。因而它既可能减少首 token 延迟(TTFT),也可能减轻 decode 主循环负担,改善每输出 token 时间(TPOT)。
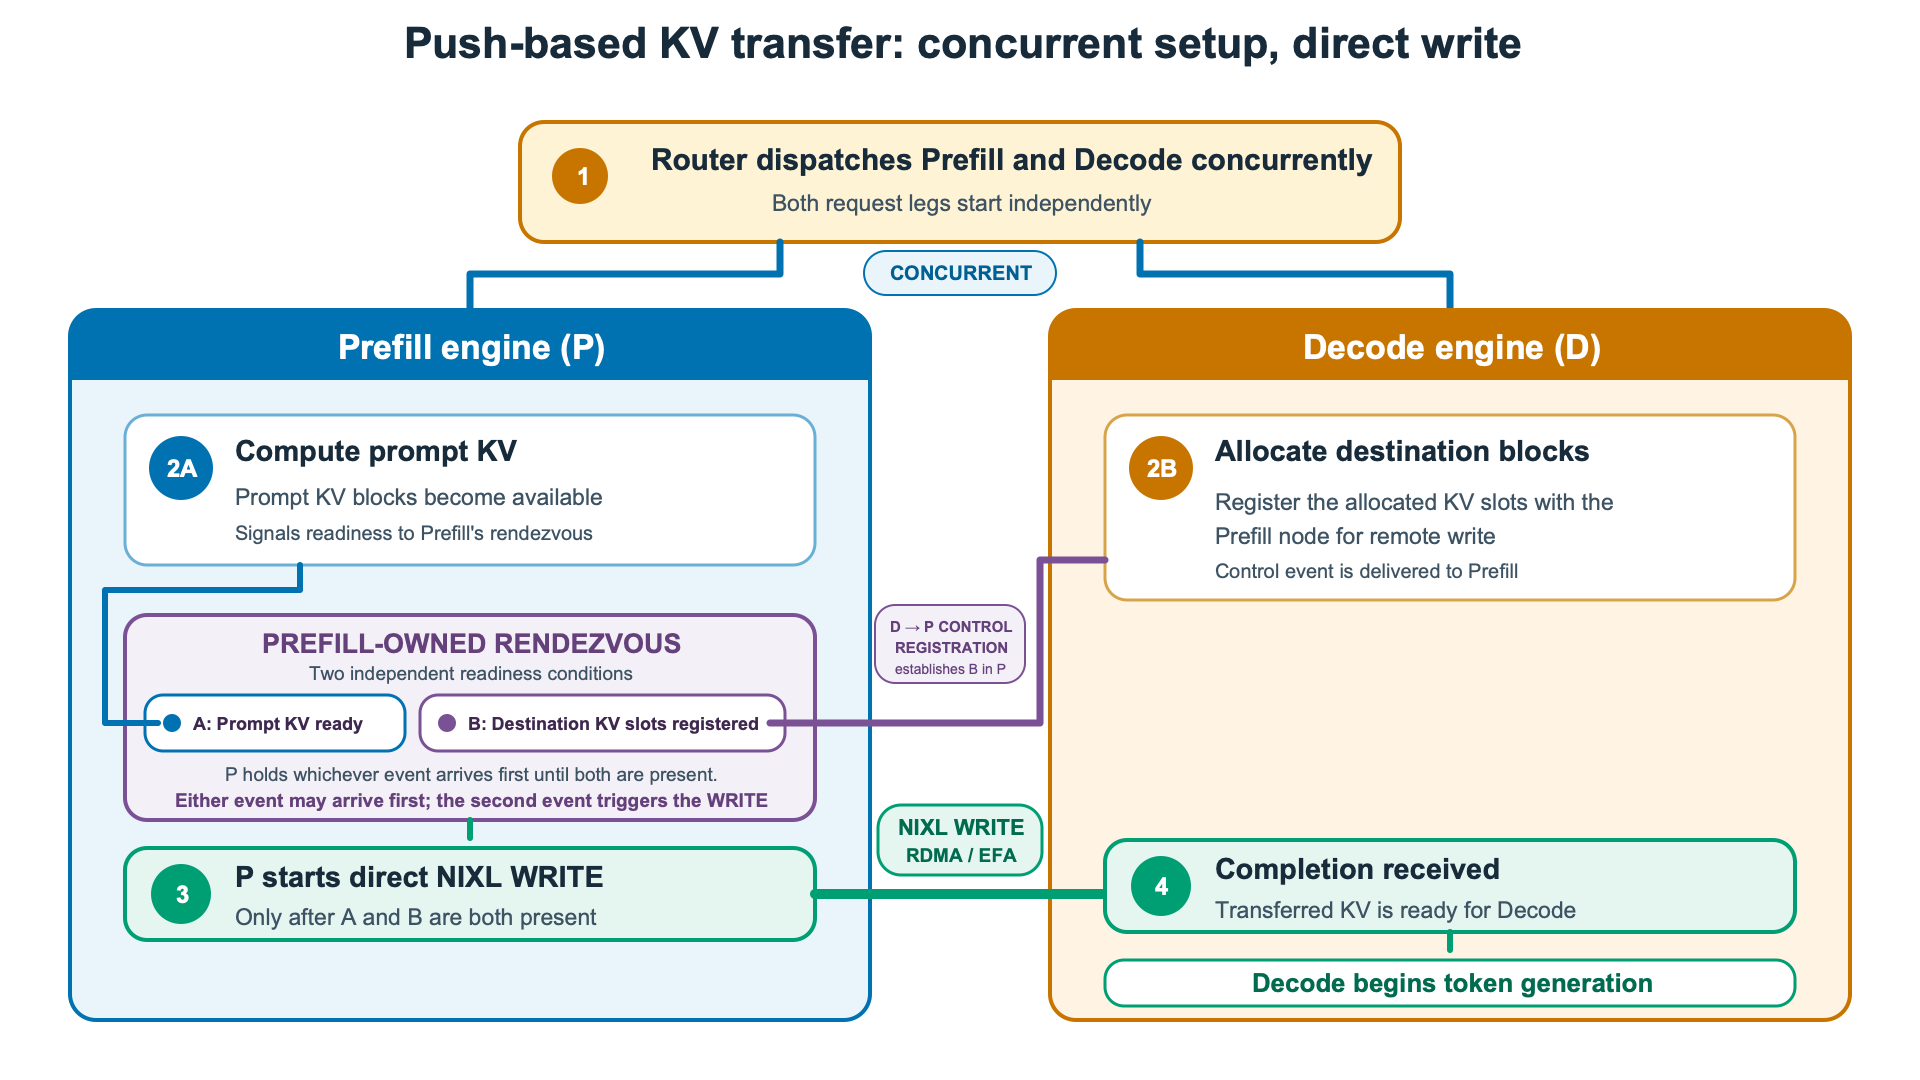
router 同时启动两端;左侧计算 KV,右侧登记目的块;两个条件在 prefill 会合后才发起 WRITE,完成后 decode 开始生成。
协议的核心是两个条件会合
首先,decode 为需要远端 prefill 的请求分配本地 KV 块,向生产端发送含自身身份与块位置的登记。此时 prefill 可以还在计算,两边并行推进,不必等到源端完全完成才开始找目的地址。
其次,prefill 端按请求标识匹配“目标登记已到”和“本地 KV 已就绪”。两个事件可以任意顺序到达:先登记就等计算,先计算完就保留块等登记,第二个事件触发传输。匹配还需处理抢占或重试后重新发出的请求,不能把旧请求的地址误配给新的执行。
最后,生产端建立或复用连接,向各目的 tensor-parallel rank 发起 NIXL WRITE。两边可以有不同块大小与内部布局,各自在传输时映射物理位置。目的端不能收到任意一个通知就开始生成,而要收齐预期写入它的所有生产 rank 的完成通知,才把 KV 标为可用。
这种设计的可靠性依赖完整的交接协议。提前知道地址,并不等于数据已经可读;收到部分完成,也不意味着所有分片就绪。架构图里短短一个完成箭头,实际承载的是从“预留内存”到“可用于 decode”的状态变化。
后台线程改变了谁承担准备成本
prefill 主循环在两个条件满足后把工作交给后台线程,尽快返回模型执行。线程负责连接、块地址到描述符的转换、连续区域合并及 WRITE 提交。原来压在 decode 关键循环里的每请求准备开销,被移到另一端和另一条执行路径。
这并不意味着复制没有成本,也不意味着后台工作不会竞争 CPU、链路或内存。它解释的是为什么同样的数据通道会得到不同用户延迟:当准备工作与计算重叠,且 decode 不再被同步准备打断,暴露给请求的等待会变少。优化应关注端到端时间线,而不能只比较网卡带宽。
三倍结果对应什么配置
作者在 1P1D 拓扑、Amazon EC2 P5en 与 EFA 上评测 Qwen3-32B。附录使用两台 p5en.48xlarge,各有八张 H200,模型以 BF16、TP=8 运行;输出长度为 128 token。输入从 1k 到 16k、速率从 1 到 8 QPS,decode 关闭前缀缓存,以迫使每次请求都走完整 P→D KV 传输。
低负载、短输入时,两模式接近;在 8 QPS、16k 输入时,pull 的 TTFT 约 1,744 ms,push 约 540 ms,即大约三倍差距。同样的长输入高负载区间,pull 的 TPOT 约 10.4 ms,push 约 7 ms;轻载时约为 5.6–5.8 ms,差距小得多。这些条件说明收益来自压力下的控制开销,并非固定附赠的倍率。
关闭前缀缓存有助于隔离传输效果,却也限定了结果的含义:真实系统若经常命中 decode 本地缓存,部分请求根本不必搬完整 KV,整体收益会改变。作者在 Trainium 集群构建并验证功能,但这里的性能图来自 P5en GPU 集群,不能把这些数字直接移到 Trainium 或其他网络。
从结果回到可解释的时间线
评估这种改动时,可以把请求等待分成目的登记、源端计算、交接准备、实际传输和开始生成几个阶段。这个拆分是基于协议的分析方式:push 的主要机会在于让前两项重叠,再把准备开销从 decode 主循环移开。如果实际瓶颈已经是链路饱和,单改交接顺序并不能让相同字节凭空消失;如果主要时间在短请求的模型计算上,节省的控制时间也可能很小。
原文的环境细节进一步说明为何不能只摘取一个倍率。每台测试实例有十六个 EFA 接口,总标称带宽为每秒 3.2 太比特;NIXL 的 LIBFABRIC 后端打开所有接口作为通道,但每张 GPU 的 KV 只注册到与它共享 PCIe switch 的两个接口,保持传输的本地拓扑关系。这些硬件和注册策略会影响实际搬运效率,标称总带宽不等于单请求有效带宽。
对已有服务的阅读启发是,应先定位 decode 是否真的被描述符准备阻塞,再衡量提前预留空间的代价。若把网络、缓存命中、路由和线程模型一起改动,即使整体变快,也难知道哪个变化贡献最大。文章通过相同模型、输入长度、请求速率与输出长度的成对比较,使该机制更容易解释;它所提供的证据仍限于这套拓扑与关闭 decode 前缀缓存的实验条件。
提前承诺目的节点,要换来什么
Pull 可以等 prefill 完成后再选择 decode,更利于根据当时负载和服务质量策略路由。Push 为获得重叠,必须更早选定节点并预留块。这是实质取舍:长 prefill 期间,目的端负载可能变化,提前分配的资源也有占用时间。原文因此将要求延迟选择目的端或双向 KV 传输的工作负载留给 pull。
两端都需选择 NixlPushConnector,代理也要走对应协议。阅读时优先看登记、会合、完成通知与线程分工,再看性能图。原文还提出把后台 NIXL 线程方式带回 pull 的方向,意味着部分收益来自实现层面的异步准备,而非 push 在任何实现中都天然优于 pull。它提供的是一条清楚的工程经验:先找出哪些控制步骤暴露在 token 生成路径上,再决定值得为重叠提前承诺多少资源。