持久 kernel 如何同时执行三种工作
open-flapping-airplanes 根据公开视频独立重建一个演示:一次持久 GPU kernel 启动后,同时训练语言模型、用更新中的权重提供文本,以及运行 Doom。它未使用原演示代码,原模型和训练配置也未公开,因此首先是独立实现,而不是原系统性能复现。
每个 block 启动时读取 SM ID,按固定分区承担训练、服务或游戏。B200 实验给三者分别分配 116、24、8 个 SM,没有抢占式动态分配。训练和服务通过 ticket 计数器领取任务,各阶段完成后先执行内存 fence 再更新完成计数;依赖方用 acquire 读取进度,未就绪则等待。前向释放反向、一个 token 释放下一个 token,不需要主机逐算子启动。
省掉启动并不保证训练最快
162.4M GPT 的 B200 实验执行四千步、每步 4,096 tokens。三阶段 tcgen05 GEMM 版本训练耗时 48.1 秒,同时服务和运行 Doom。相同 SM 份额上独立运行的 eager Megatron 加 Transformer Engine 需 62.4 秒,但 CUDA Graph 版本只需 43.1 秒,比 megakernel 更快。
服务基线也受 CPU 资源影响:vLLM 在预留 16 核时达到 1,537 tokens/s,未预留时仅 684。作者采用更快对照,避免把容器 CPU 瓶颈误作 GPU 调度收益。顺序执行、并发独立进程和单 kernel 的总时长比较还含一个由独立运行推算的并发值,不能全部当成实测。
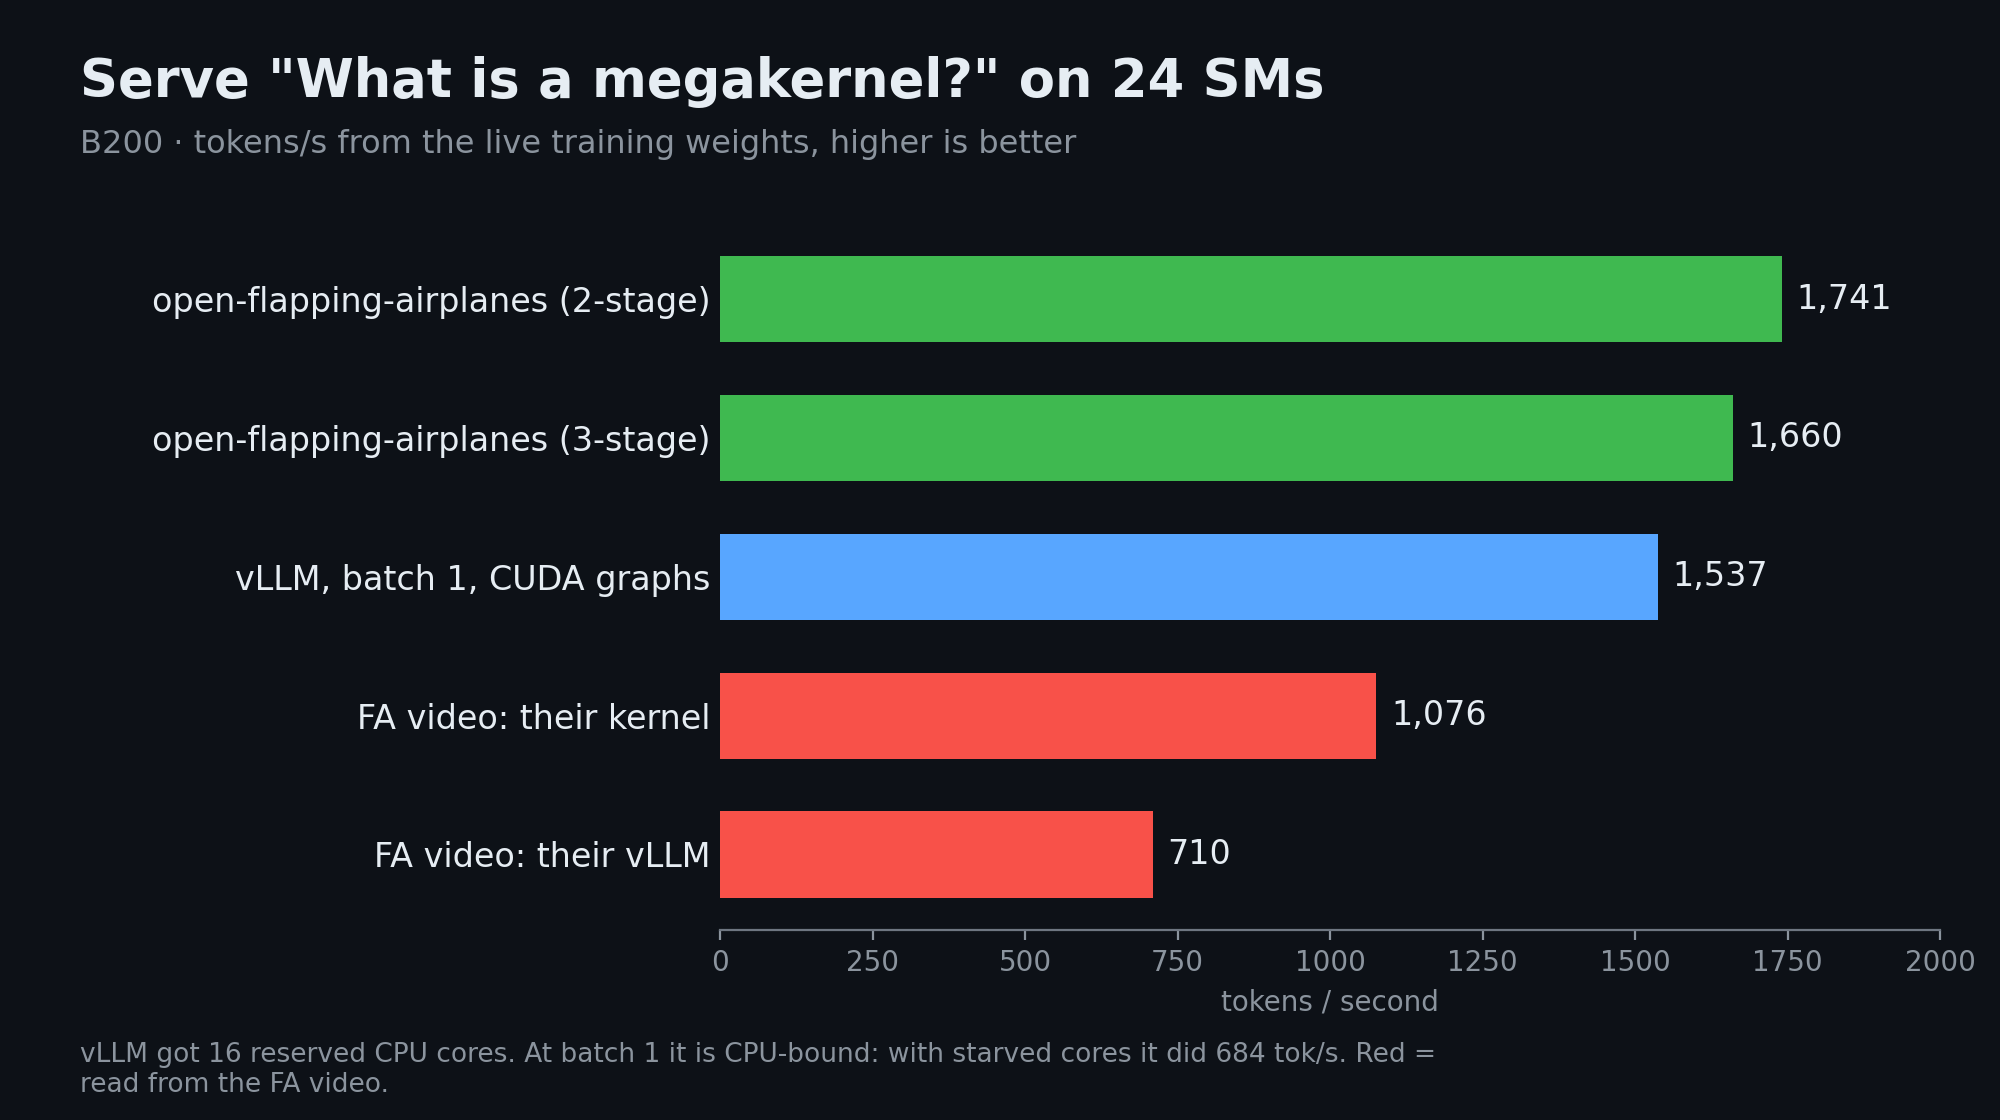
项目的 24 SM 解码实验:这是同一条提示下的 tokens/s 对比;图中来自原演示视频的两项读数与本项目实测有区别。
共享与通用调度之间的距离
Doom 被移植为 GPU 代码,逻辑线程将绘制工作交给其他线程;声音关闭,玩家脚本控制游戏。这是异构任务共驻的具体展示,但静态 SM 划分意味着资源份额并不免费,不能据此推出负载任意变化时仍能自动平衡。
我的理解是,应把它当作研究执行边界的可检查工件:什么时候主机启动是瓶颈,什么时候矩阵 kernel 或资源分配更关键。小字符模型与 162M 模型的结果、A100/B200/B300 结果均需分开;对这种演示,强 CUDA Graph 基线比夸张启动次数更能说明实际价值。
来源:原始工程文章