六步生成中,解码也可能比模型更慢
Pika H3 Flex 基于 MiniMax H3 后训练,支持文本、首尾帧和多模态参考生成带声音视频。它采用六步采样、无 CFG 和稠密 attention。FastVideo 的单 GB200 测量中,五秒 768p 视频的六次 DiT forward 约需 20 秒,原实现 fp32 VAE 解码却需 38 秒。只优化 attention 会错过更大的等待段。
实现用 FlashAttention-4 替换 cuDNN SDPA,并融合 cat/mul、QKV 前处理、归一化、调制和 SwiGLU 等操作。解码先转 BF16,再使用 NVFP4 decoder。十五秒片段有约 109K tokens,稠密 attention 的平方增长使它占到 forward 的约 75%,这时低精度 attention 才成为重要优化目标。
量化需要与音频和视频共同校准
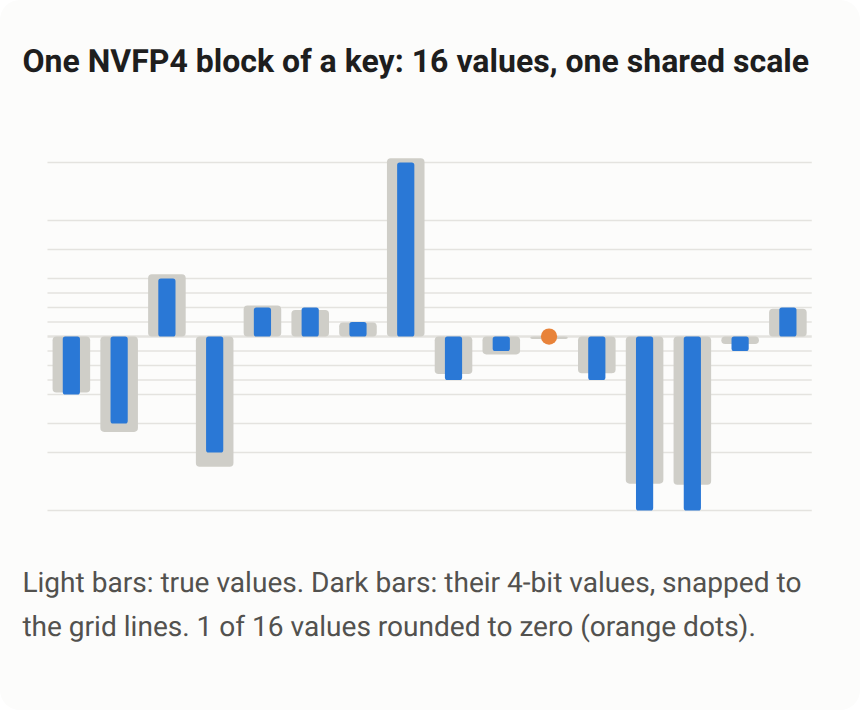
一个 NVFP4 key 块的 16 个值共用一个缩放值;图中有一个小值量化为零。
NVFP4 路径先在 fp32 合并 LoRA,再做一次舍入,避免合并误差混入量化。静态激活尺度按 Flex 自身六步轨迹校准;若只优化总体误差,大量视频 tokens 会淹没音频。因此每层裁剪要平衡两个模态。
QAD 让四位学生从第一步就使用部署数值,对齐冻结 BF16 教师的最终预测与逐块输出,并部分从学生自己的状态开始学习纠偏。FP4 attention 则先对 key 减均值,再对 Q/K 做相同正交 Hadamard 变换,减少异常通道影响;这些变换在量化前保持 attention 语义,但量化本身仍有误差。误差敏感的第 45、49 块保留 BF16。完整视频还检查首尾帧、运动和声音,避免仅优化蒸馏分数。
七倍标题的比较条件
文中端到端计时从提示到带音频 MP4,模型已驻留,报告 warm median,不含加载。四 GB200 的最快十五秒 768p 配置为 31.8 秒;相对单卡官方 225 秒是 7.07 倍,相对四卡官方 146 秒则是 4.58 倍,且 decoder 精度已改变。不能把七倍写成同资源 BF16 优化。
五秒 480p 的约 5.8 秒来自 NVFP4 模型和 Blackwell 硬件;它不代表更长或更高分辨率也近实时。我的理解是,这个案例应按 DiT、attention、VAE 和量化误差分开读:短视频先治解码瓶颈,长视频再看稠密 attention,并用完整音视频行为约束数值优化。
来源:原始工程文章