命中前缀之后,数据还必须就绪
HiCache 将 SGLang 的 GPU 前缀缓存扩展到主机与外部存储。长程 agent 重复发送历史,缓存能省去预填充,但并行执行让“命中”不再是单机查表。CP 各 rank 保持同一逻辑 radix tree,实际 KV 页按逻辑页号轮转归属;备份和恢复必须保留这个归属,否则下一次 gather 会找不到正确数据。
文章用 A/B/C 与 A/B/E 共享前缀说明这一点。恢复可以换物理地址,但不能任意换页所属 rank。每层先恢复本地页,再 gather 历史 KV,最后运行 attention;流之间以完成事件建立顺序。两个临时缓冲交替容纳相邻层的 gather,容量计入调度预算。缓存省的是重计算,仍需付出收集分片的通信成本。
为什么流水线阶段不能各自处理完成事件
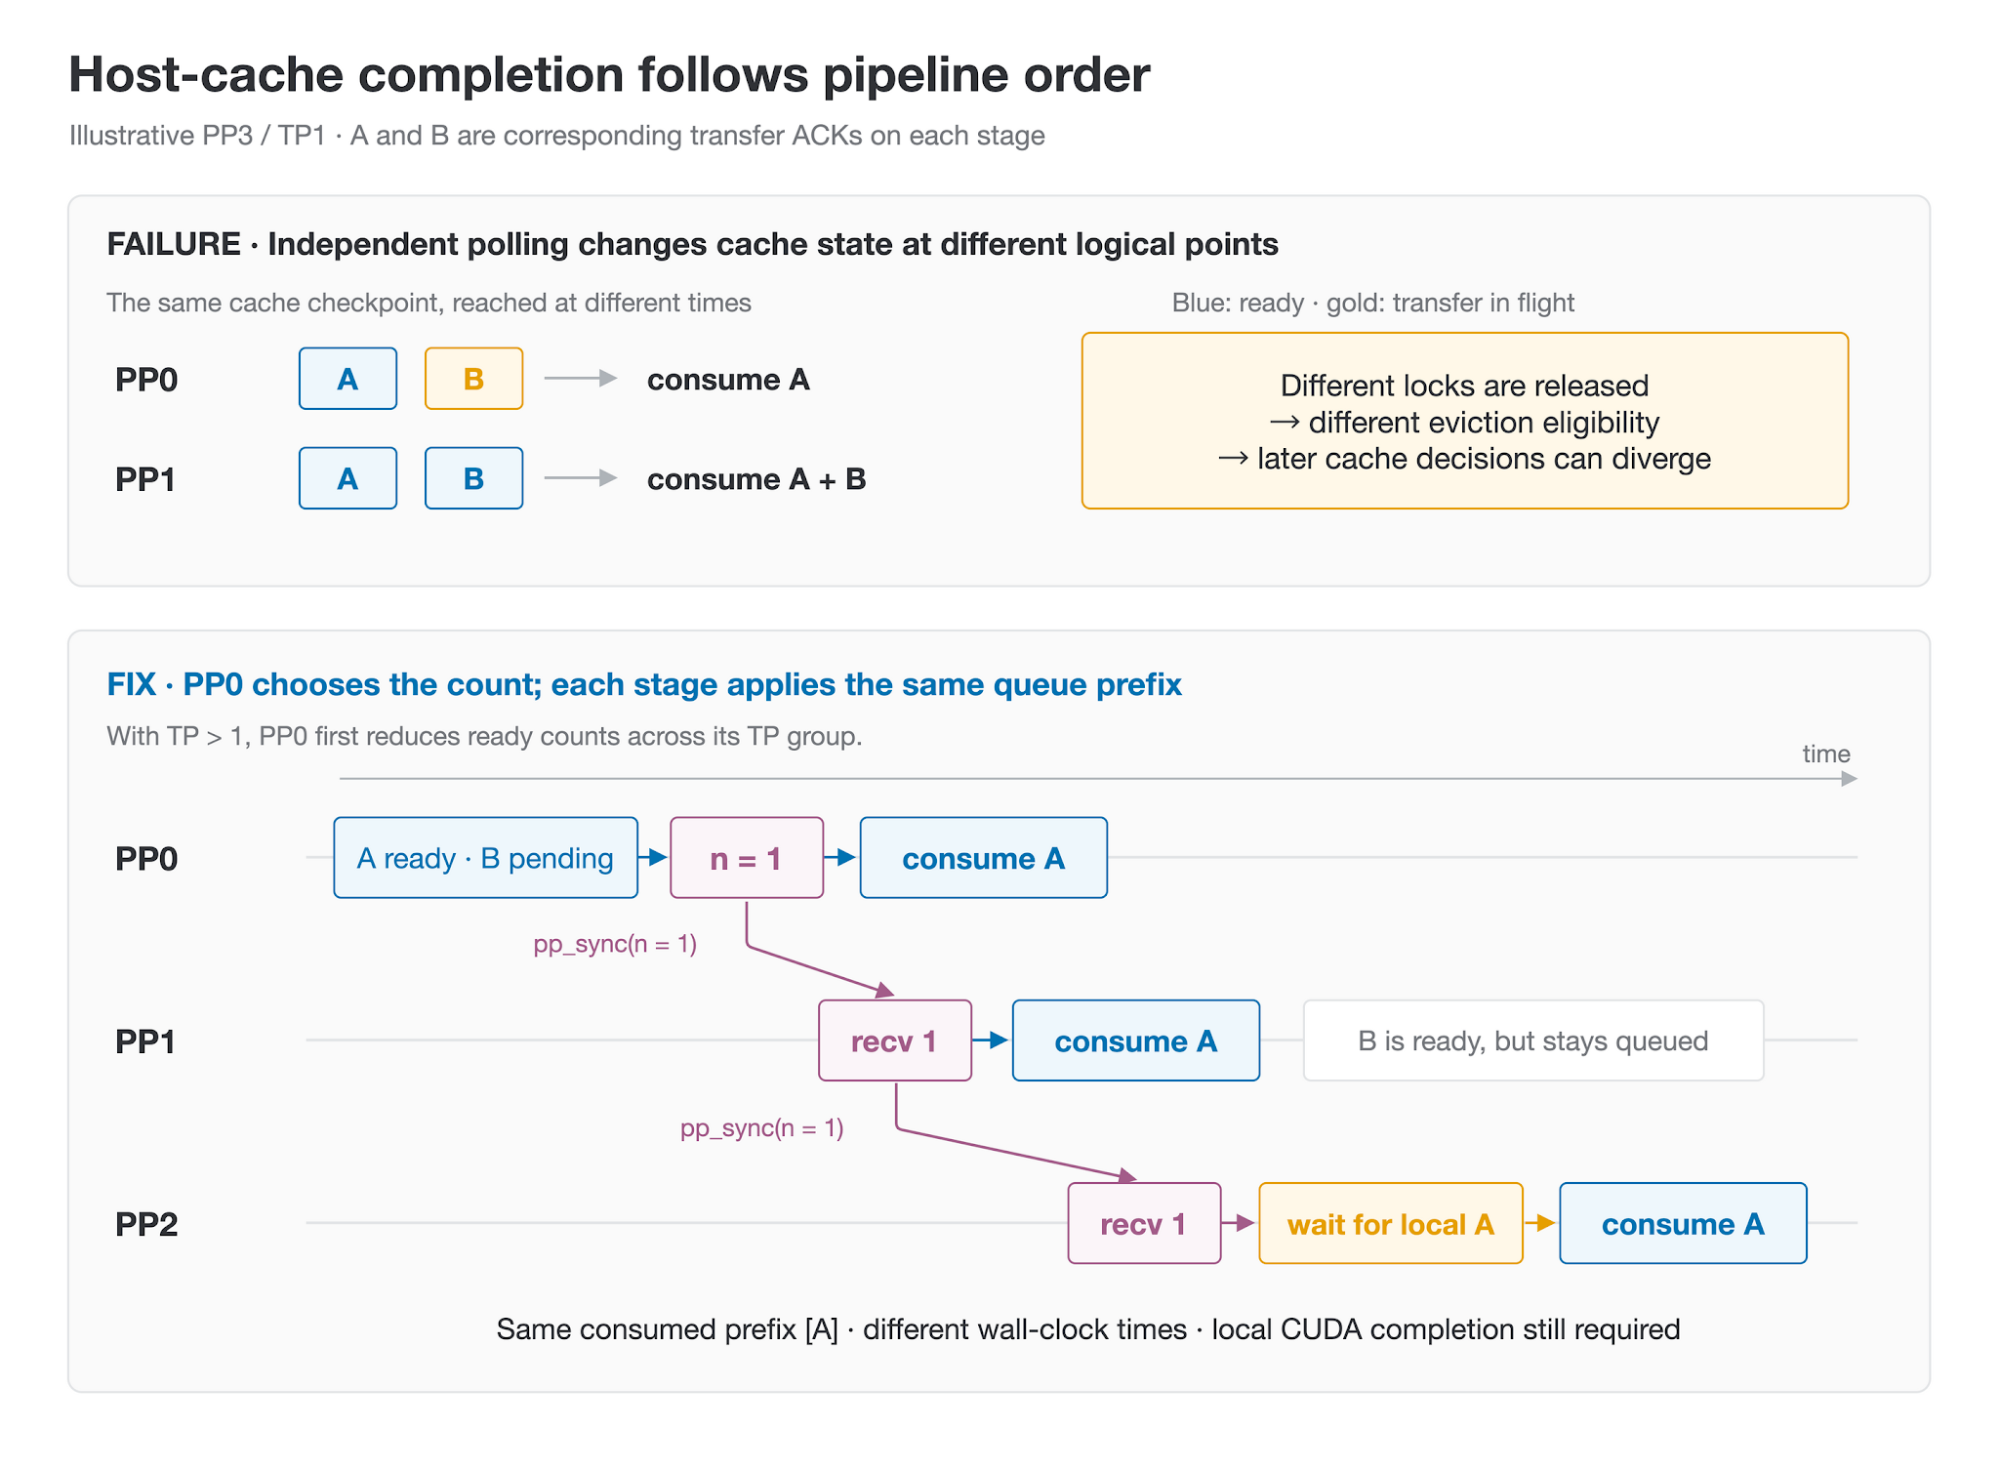
各阶段独立轮询会得到不同的缓存完成状态;PP0 传递可消费的前缀长度,各阶段按同一顺序推进。
PP 各阶段存不同层,异步复制完成时间自然不同。假设 PP0 只看到 A 完成,PP1 已看到 A、B 都完成;若各自释放已完成传输的锁,后续淘汰资格和命中长度就会分歧。pp_sync 由 PP0 决定本次消费多少个 ACK,将数量逐级传递。较快阶段留住额外 ACK,较慢阶段等选中传输本地完成后才更新账本。
外部存储还先对命中与完成长度取跨 rank 最小值,把共同进度排成有序 ACK。PP0 本轮选了四页,后级即使已有六页也使用同样四页。这里同步的是逻辑操作顺序,不要求所有阶段同时停在一道屏障。文末 rank_consensus_checker 对照对应调用及返回值,帮助定位早于 shape mismatch 或 collective hang 的首次分歧。
草稿、跨拓扑与解码端复用的边界
投机解码不能只恢复目标模型 KV;草稿模型需要的 KV、索引和循环状态也要一起恢复。兼容布局可用 packed 路径共享 host 映射,不兼容状态采用 sidecar 独立池。跨拓扑的 unified layout 按全局层与 head 分块,以模型、dtype、页大小等命名空间字段约束复用;原文当前范围是特定集成构建、file 后端和单 MHA/MLA 池,不能理解为任意并行组合互通。
P/D 场景则在 decode 端匹配并恢复前缀,只接收缺失后缀。文章的 CP 对照使用 GLM-5.2-NVFP4、TP4/CP4、相同主机缓存目标和各两组四卡 GB300 prefill 引擎;约三小时流量中组合命中率仍近 93%,收益主要是命中从主机迁回 GPU,而非总命中率暴涨。我的理解是,应把缓存布局、状态就绪与事件一致性共同作为复用契约,不能仅凭命中率判断正确性或 TTFT。
来源:原始工程文章