当代码产出超过开发基础设施的承载力
Anthropic 的 Scion 案例值得关注,因为它展示了编码 Agent 普及后,瓶颈如何从写代码转移到保存、分发和验证代码。团队报告,日合并量从 2026 年 5 月约 2,500 次增长到 9 月超过 30,000 次,五个月内完成了 monorepo 到自研版本控制系统的迁移。理解这次变化,要同时看数据结构、取回协议和开发流程,单纯增加镜像已经无法解释其解决路径。
原文:Redesigning source control at Anthropic
Nick G. 与 source control team(S.G., R.K., Dan C., Garrett H., Ben L., Colin M., Joe P.)· 首发 2026-10-13,更新 2026-10-15
为什么按需取回还不够
原文给出的压力是:主分支历史接近 100 GB,压缩工作副本超过 25 GB,CI 每天约执行 2,500 万次 checkout。如果简单地每次完整传输,流量会超过每天 600 PB;这是解释规模的估算,不是其实际网络流量。
浅克隆、稀疏检出、promisor remotes、镜像和仓库快照都曾缓解问题,但提交增长使快照更快落后于主线,部分克隆上的历史查询也更难维护。Scion 因而调整系统假设:Agent 和作业通常在线,客户端无需独立承担完整版本控制能力。提交、合并、rebase、历史和 blame 查询放到服务端,客户端保留有界对象缓存、工作目录和文件变动监测。
这将瓶颈从“每个消费者维护一个仓库”转成“共享服务回答问题”。需要 diff 或祖先关系的 CI 可以直接查询 API,连工作目录也不必建立。代价是操作依赖可达的服务端,离线自治不再是核心设计目标。
增量写入与查询结构分离
Scion 的基本单位是 changeset,作为预写日志条目记录相对第一父节点发生变化的文件,以及指向压缩文件内容的内容寻址引用。提交在服务端创建,设计目标是让写入成本随本次修改大小增长,减少随着仓库总规模增长而反复进行的工作。
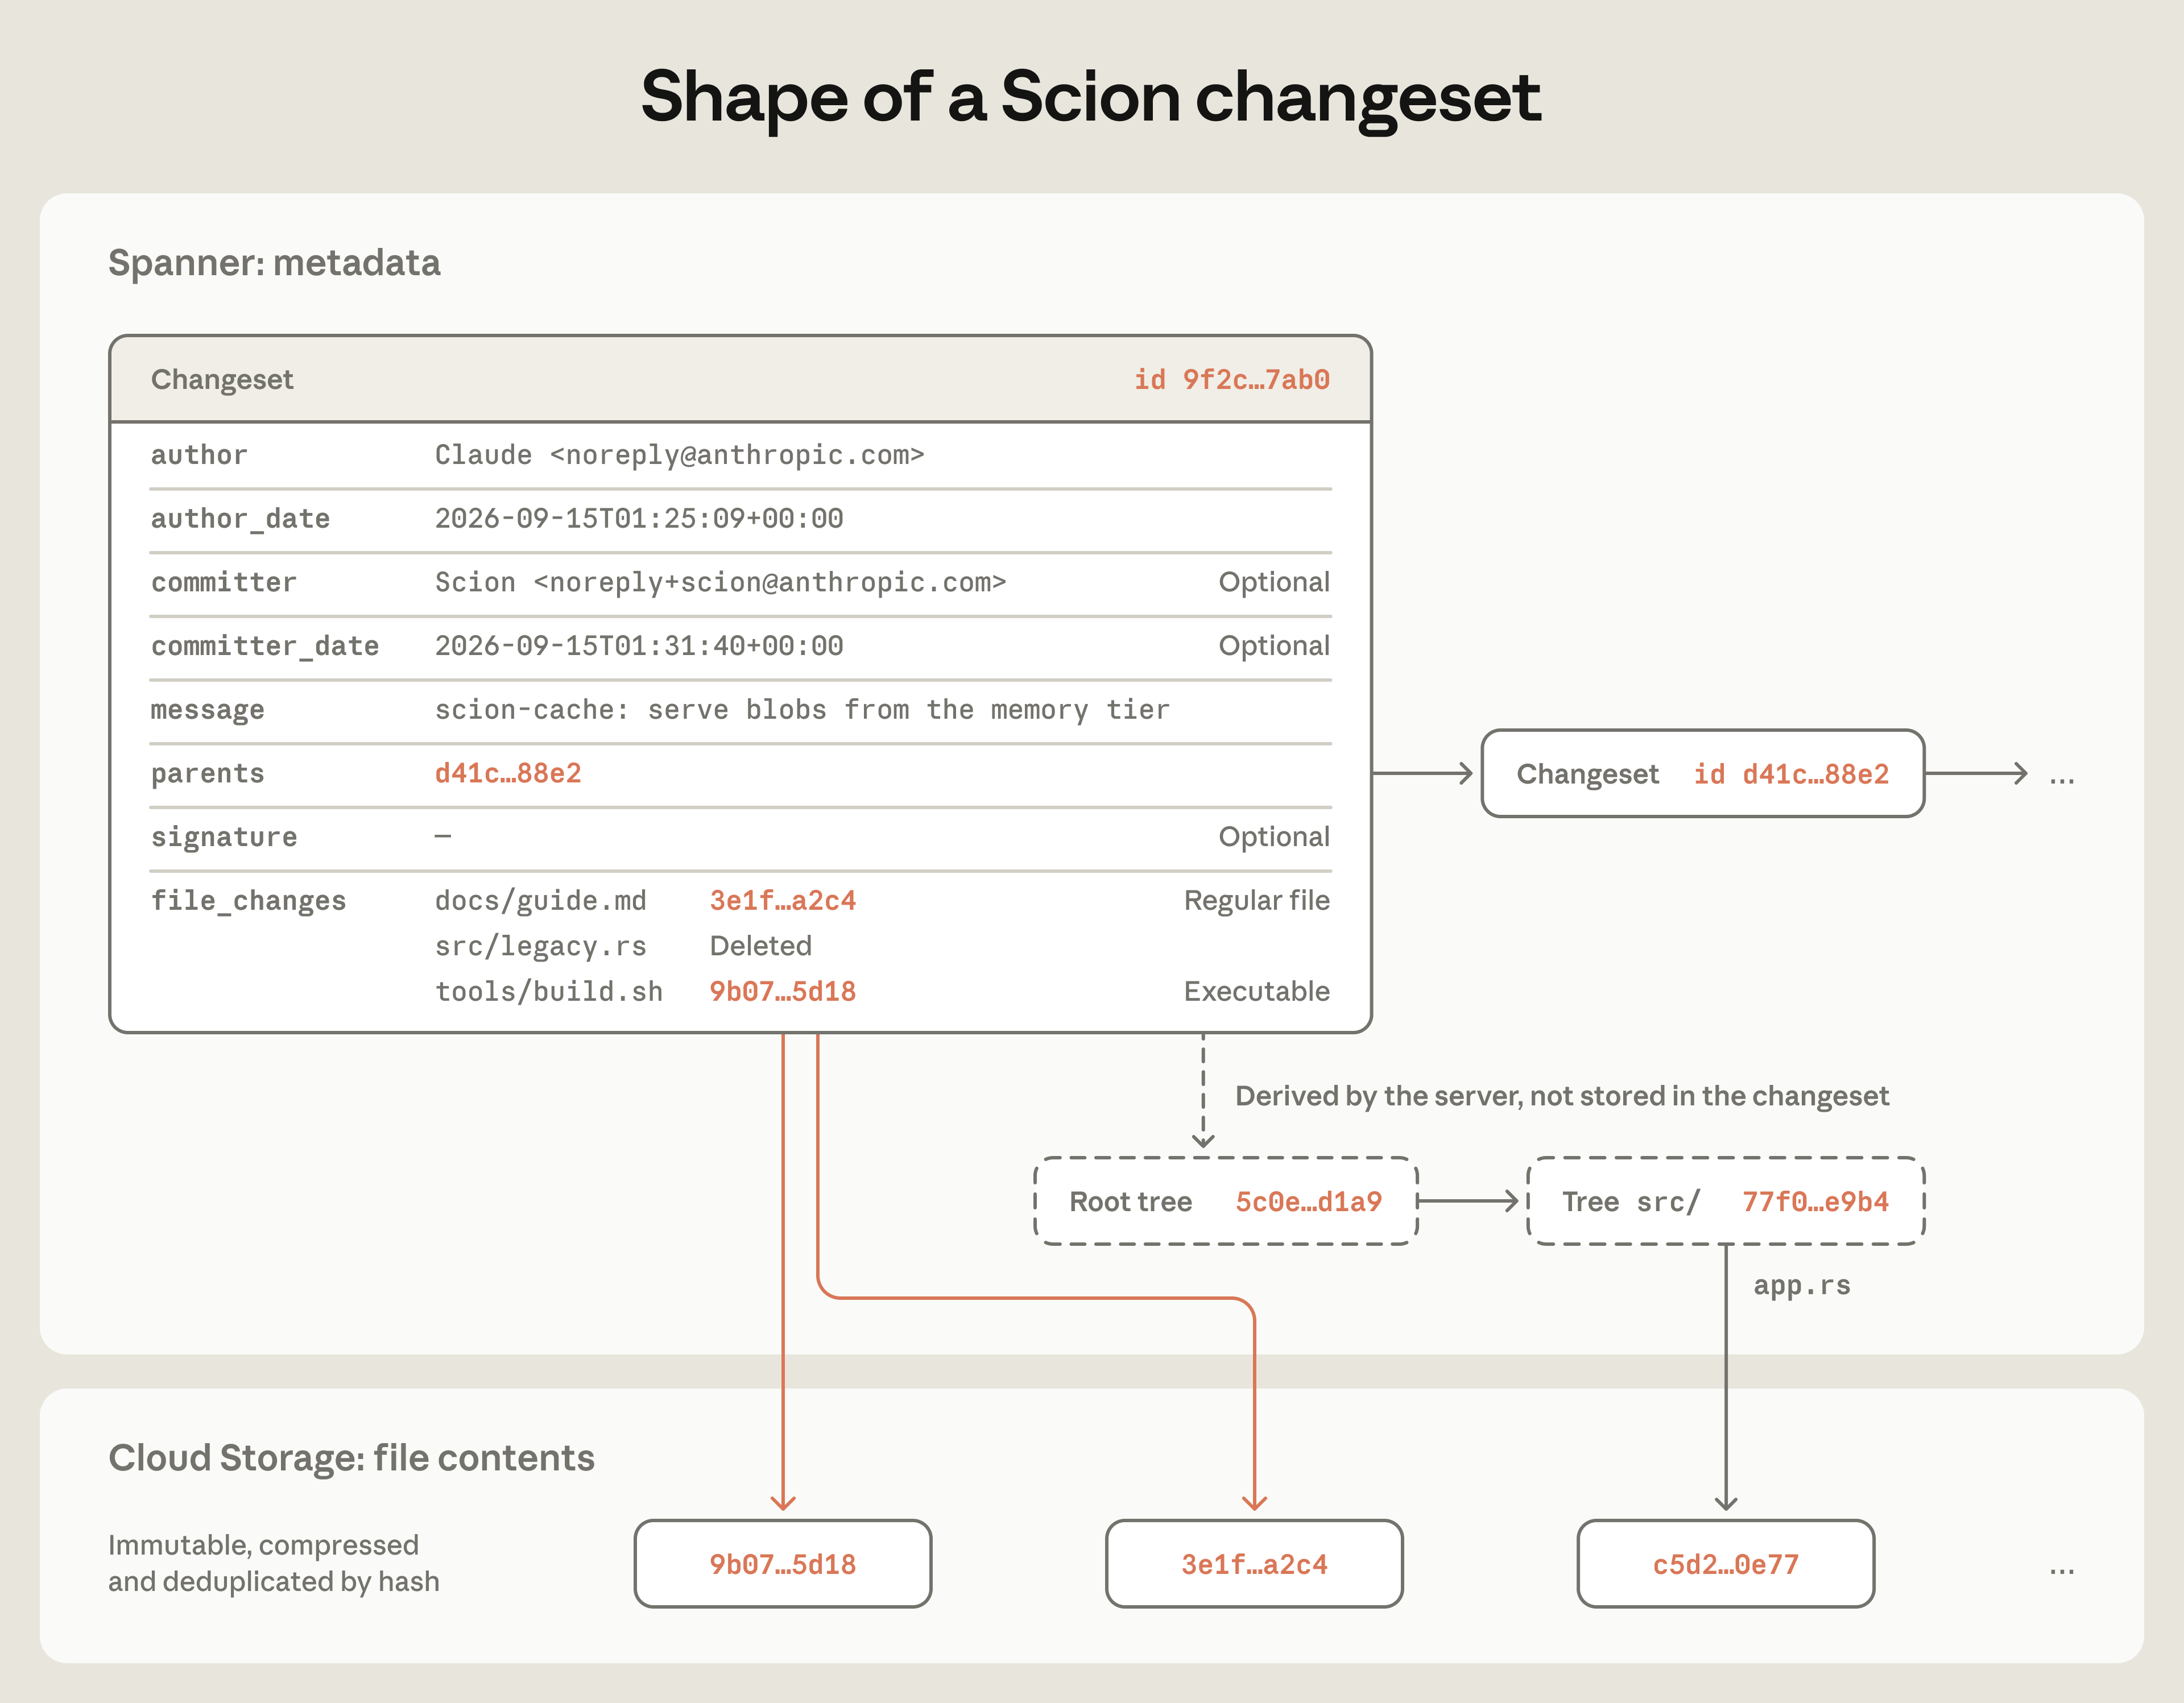
读图:上方在 Spanner 保存 changeset 元数据和文件改动,底部云存储保存不可变内容;虚线框中的树由服务端派生。
单有改动列表无法快速回答所有历史问题,所以系统另建 blame、路径历史和提交图索引等派生数据。每类派生数据可从父 changeset 的结果递归计算,按需要选择提前计算或延后生成;客户端不依赖内部格式,服务端便能独立更换索引。这是把写入简单性与读取效率分开管理,而非省掉所有索引成本。
团队还限制日常流程对 refs 的依赖。创建 changeset 与移动分支指针分开,后者用 Spanner 单行 compare-and-swap 完成。因此,文中的“低协调、无锁提交”不能理解为整个系统没有一致性协调:可变指针仍需独立更新。
让取回协议适配共享缓存
客户端从所需根树出发,只递归请求本地缺失的树和文件对象。请求描述的是“我要哪个不可变对象”,服务器无需先为每个客户端计算差异,再打包一个巨大的响应;失败后也能继续取回缺少的对象。稀疏和虚拟化检出由需求本身表达,不需要的目录不请求,未读取的文件不必立即落盘。
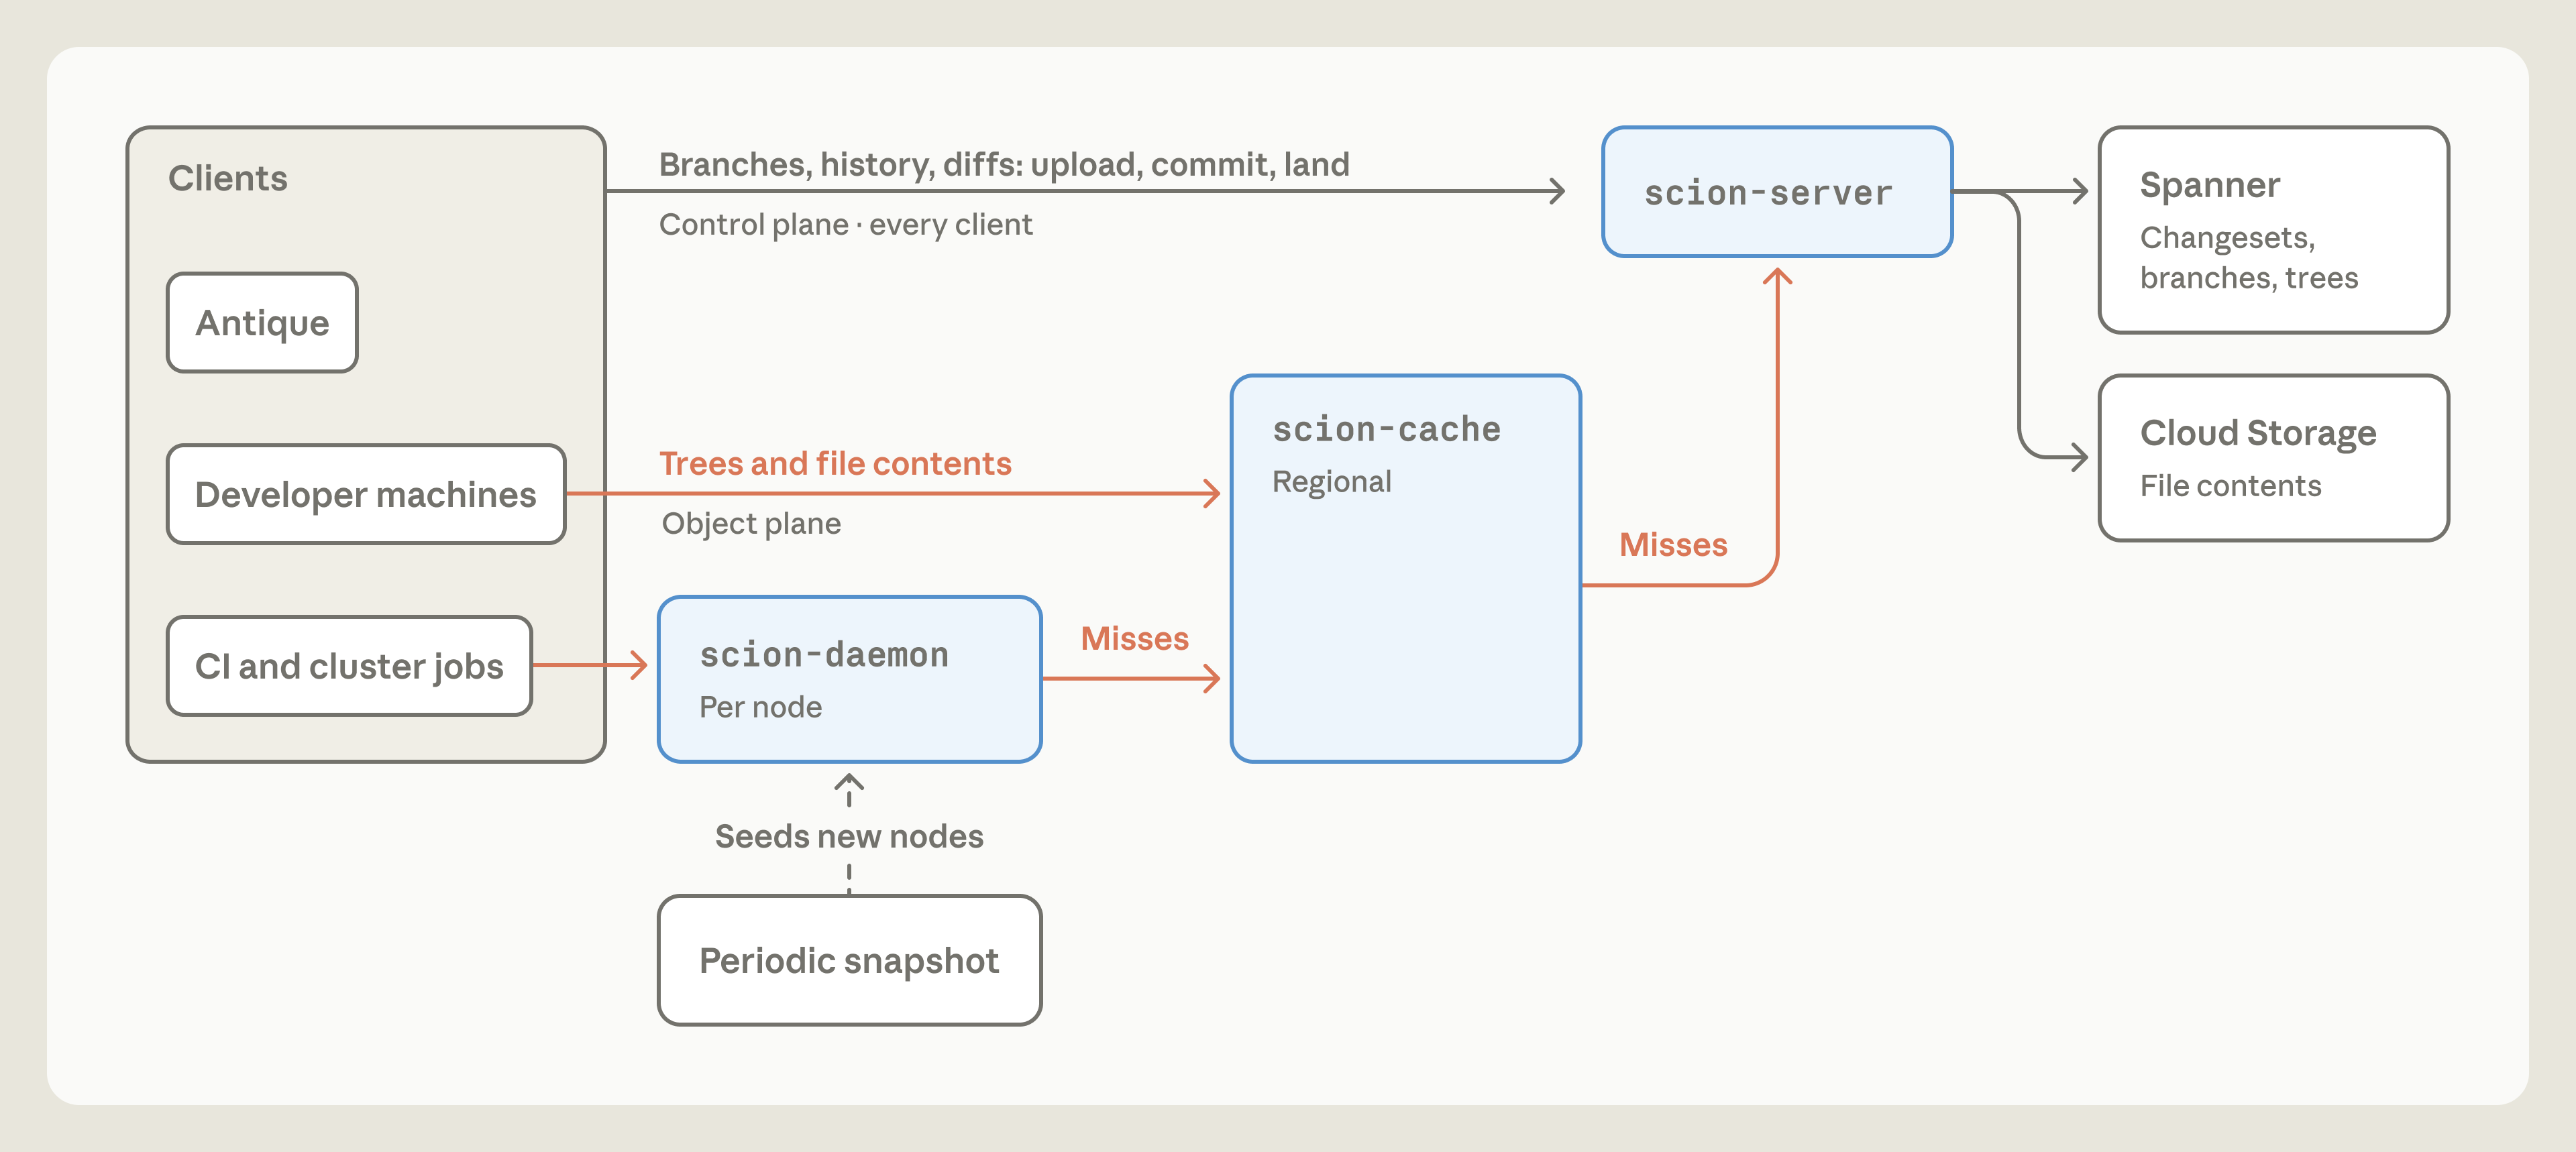
读图:上方控制操作直达服务端,橙色对象请求沿节点与区域缓存逐层查找,只有未命中才继续访问上游。
集群节点上的 scion-daemon 共享同一节点各作业使用的对象,定期快照为新节点预热。未命中再进入区域 scion-cache,最后到 scion-server,由其访问 Spanner 或云存储。区域缓存按 daemon 使用的磁盘格式直接从内存发送对象,减少重复压缩与客户端差异计算。
三层采用相同 RPC,但运行时严格限制层级关系。这个细节很关键:区域缓存故障时,若所有请求都任意绕过缓存冲向上游,原本局部故障会变成全局过载。内容寻址降低了缓存一致性负担,却没有消除容量规划和故障隔离的责任。
性能数字对应哪些成本
作者报告各缓存层命中率超过 99%,Scion 基础设施的 CPU 与内存需求约为旧 Git 镜像体系的 1/200;CI 和研究作业 checkout 快两个数量级,从分钟级降至秒级,CI 释放了 25% 的 CPU 容量。它们分别描述服务基础设施、单项操作和整个 CI 的资源收益,不能混成“所有研发成本减少 200 倍”。
这些是内部迁移结果,文章未提供可供外部复算的统一负载、尾延迟分布或成本拆分。读者可以从机制上理解为什么共享对象和省略 checkout 有效,却不能直接把倍率迁移到规模较小、缓存局部性不同的仓库。判读时应先区分取回数据、查询元数据和执行构建各自占了多少时间。
从这一设计可以推得,缓存收益还取决于作业之间是否反复读取相同对象。同一节点上的任务共享大量代码时,daemon 能减少重复取回;若任务主要读取互不相同的新内容,压力仍会传向区域缓存和存储。这也是把内部高命中率当作工作负载特征、而非协议固有保证的理由。
版本控制变化会传导到 CI 与审查
Scion 并不是单独替换一个命令。团队同时建设了 Antique 代码审查、代码搜索、权限系统与合并流程;七人团队在日合并量增长十倍期间完成五个月迁移。原文承认,测试运行时可能又合入数百甚至数千个改动,因此他们增加合并后及部署前测试,而没有成功复制常见的全局仓库锁式合并队列。
这种选择把一致性风险和修复负担移到后续环节,并未证明更高提交吞吐自动带来更高软件质量。文章也描述了模拟、模糊测试、限流和按目录授权,但没有给出统一的缺陷率或事故率改善指标。工程师仍审核每个变更请求,并约束 Agent 的设计取舍,例如阻止它绕过既有服务、线性扫描提交日志寻找本可直接查询的信息。
最值得带走的设计判断
这是一份特殊规模下的工业经验:超大 monorepo、大量在线客户端,以及 Anthropic 自身很高的内部 token 投入共同塑造了方案。作者明确表示 Scion 不适合作为通用 Git 替代品,完整迁移还涉及审查、搜索和 CI 等定制系统。
更可借鉴的是三个判断:先确定作业是否真的需要工作副本;把高频历史查询变成共享服务;让不可变对象的取回能被多层缓存直接回答。进一步阅读可从 changeset 与 checkout 两部分开始,追踪“哪项工作被省掉、哪项工作移到服务端”,再回头看开发流程改变所付出的协调成本。