Datadog AI Research · 2026-10-15 · 原文
Scout 1.0 把 SRE 调查当作需要后训练的专门能力,而不只是给通用模型接几个查询工具。Datadog 报告,它在内部 AlertEval 上改善了诊断质量与估算推理成本的关系。这里的分数衡量结论与参考解释的吻合程度,不是故障解决率;成本也不是包含工程团队与遥测平台的总拥有成本。
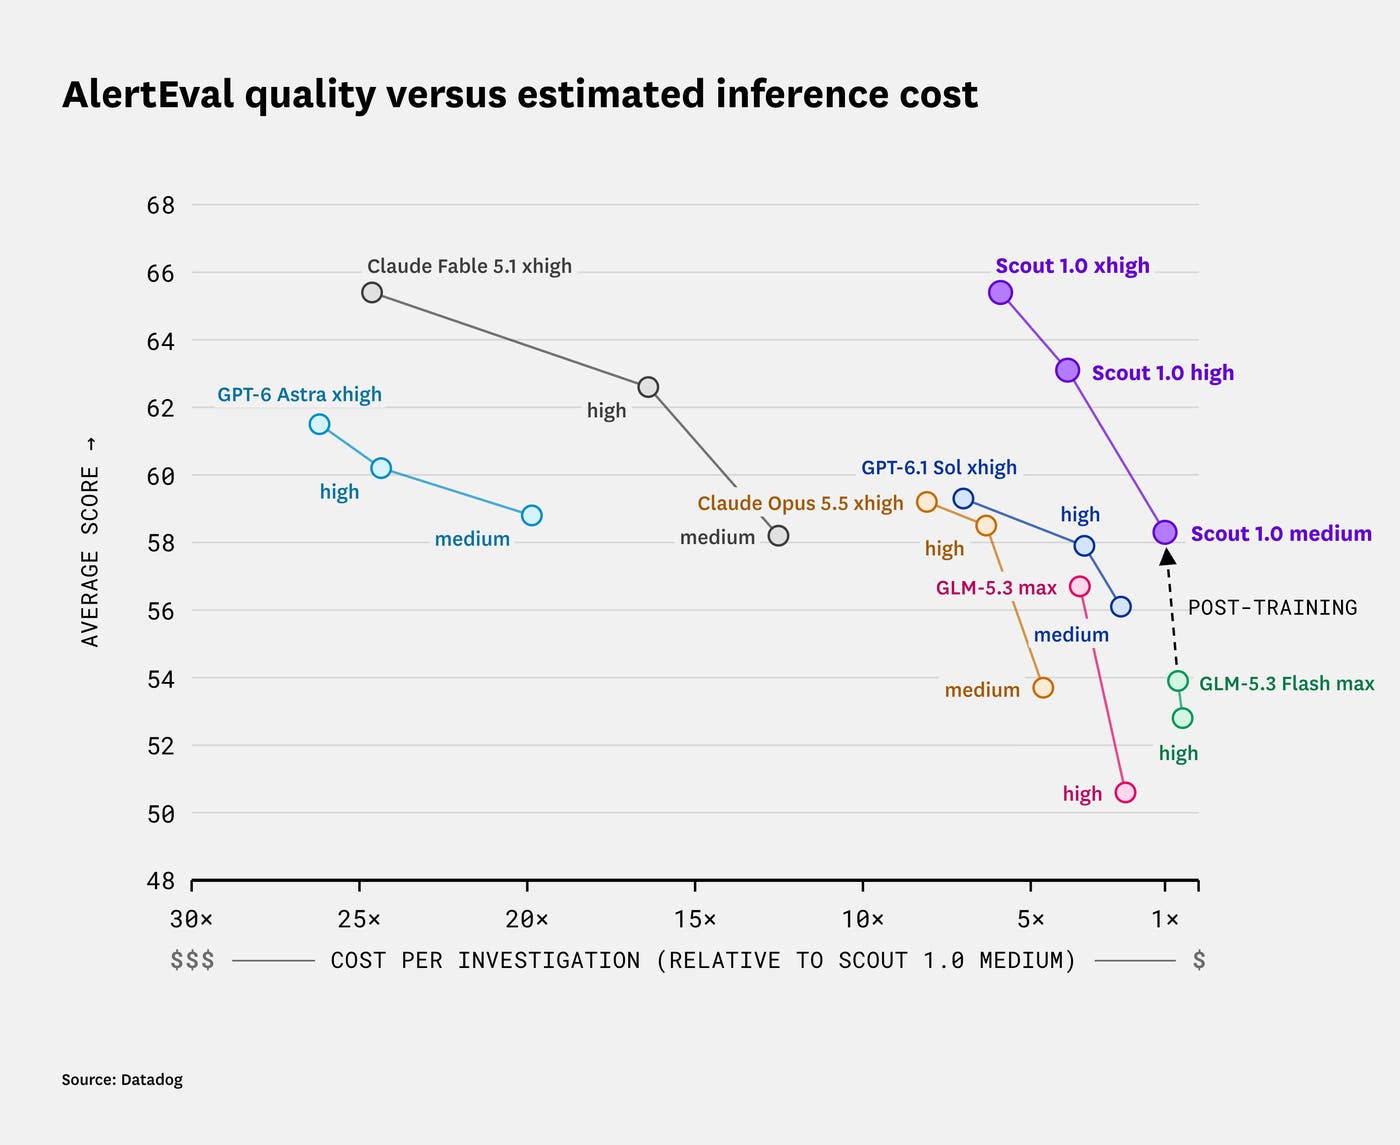
原文AlertEval质量—成本图:分数不是解决率,横轴向右成本更低。
真正值得读的是训练任务怎样构造
技术报告介绍了两条 GenSim 路径:CausalGen 执行应用并注入故障,SynthTel 直接生成遥测。两者都要提供可查询证据和已知根因。混合奖励同时关心正确性、探索与证据支撑;训练时还改变可选工具及交互预算。报告的 SREGym 实验则使用90个无噪声任务、Stratus 框架,其端到端任务结果与 AlertEval 分数是两种口径。
这让“训练数据质量”成为一个比模型尺寸更具体的问题:场景是否真的可解?信息是否通过工具暴露?故障描述、资源命名或注入器日志有没有把答案直接泄露给模型?一个运行成功的模拟系统,仍可能产生很差的学习样本。
工程推导:把场景有效性拆成三道检查
第一道是机制有效性。注入操作需要真实改变系统行为,而不只是留下一个带故障名称的标记。可以先检验症状是否出现、受影响服务是否符合预期,再检查回滚后症状是否消失。对直接生成遥测的场景,则要验证不同信号的时间与实体关系,而不能用“文本看上去真实”替代。
第二道是证据可达性。记录正确诊断至少需要哪些观察,以及这些观察是否能通过给定工具取得。若调用权限、保留窗口或查询接口挡住了关键证据,低分首先说明任务条件不充分,而不一定说明模型不会推理。
第三道是答案隔离。评测端可以掌握完整注入记录,调查端只能看到事发时本应可见的信息。把部署标识、文件名、工单备注和工具错误消息也列入泄漏检查,比只检查提示词更有用。
奖励信号需要和调查行为一起看
一个可迁移的实验设计是,把“最终判断是否正确”和“是否取得支持判断的证据”分别记录。只有最终结果,无法识别碰巧猜对的模型;只有过程分,又可能奖励形式完整但没有解决问题的调查。
还应留出“证据不足”的合法出口。可以构造表面症状相似、关键证据不同的成对任务:一例证据完整,一例故意缺失。希望观察到的行为是前者做出准确判断、后者保留不确定性,而不是两例都自信输出同一个根因。
成本比较也需要统一边界:同一案例集、工具权限、时间预算与终止条件下,再比较结果质量、模型调用和查询成本。更便宜的模型若需要大幅增加工具请求,平台的实际负担未必更低。
对研究和落地最有价值的验证
可以把故障机制留出、服务拓扑留出和工具接口变化分开测试。它们分别检查模型是否记住某类故障、是否依赖固定环境,以及是否适应调查条件变化,不能用一个总体分数替代。
混沌工程在这里提供的是可控制的因果变化与可重复观察。注入越丰富并不自动意味着评测越可信;更关键的是确认每个案例的症状、证据和参考答案彼此一致。Scout 值得关注,因为它把这些环节纳入了专门训练流程,但厂商在特定框架上的结果还需要由独立环境检验。