SGLang 对 DeepInfer 的跟进,把“模型执行得快”和“能作为完整服务运行”放在一起讨论。文章用相同硬件上的对照说明核心执行性能已接近参考引擎,再解释缓存、P/D 分离、路由与输出解析如何接成服务。值得关注的是这两层证据之间的连接,同时保留微基准与真实负载的区别。
原文:More Than DeepInfer: What SGLang Delivers
The SGLang Team · 2026-10-24
接入 kernel 之后,还要处理状态与调度
SGLang 集成了 FlashMLA、DeepGEMM、DeepEP、DeepSelect、TileLang 及 Mega 系列。MegaMoE 把 token 分发、专家 GEMM 和结果合并融合在一个 kernel 中,减少中间传输和启动;MegaAttention 成为 B300、GB300 上的默认注意力路径。文章还描述 Mega-mHC 直接向 MegaMoE 供给数据、注意力以 MXFP8 输出给投影层等改动。
这些改动的共同目标,是缩短算子之间的空隙与中间数据往返。它们依赖模型形状与硬件能力,不能抽象成任何模型都能获得的固定倍数。DSpark 则从另一侧减少目标模型 forward 次数:草稿先提议一个块,目标统一验证,实际收益仍受接受情况影响。
调度层采用 CPU 准备下一步、GPU 执行当前步的重叠方式。这个设计隐藏的是可重叠的主机工作;当 CPU 工作超过 GPU 执行窗口时,仍可能留下等待。把它理解成一种流水线组织,比把“zero-overhead”当作任何负载都没有调度成本更准确。
两种 replay,解决两种缺失
V4.1-Flash 的后段 decoder 层只需要处理有界后缀。Decoder replay 因而让早期源层处理完整输入,晚层只处理最后 128 个 prompt token,避免重复执行对当前结果不再必要的部分。Encoder replay 处理另一种情况:前缀缓存命中,却缺少滑动窗口 KV 时,从缓存前缀最后 128 token 重建缺失窗口。
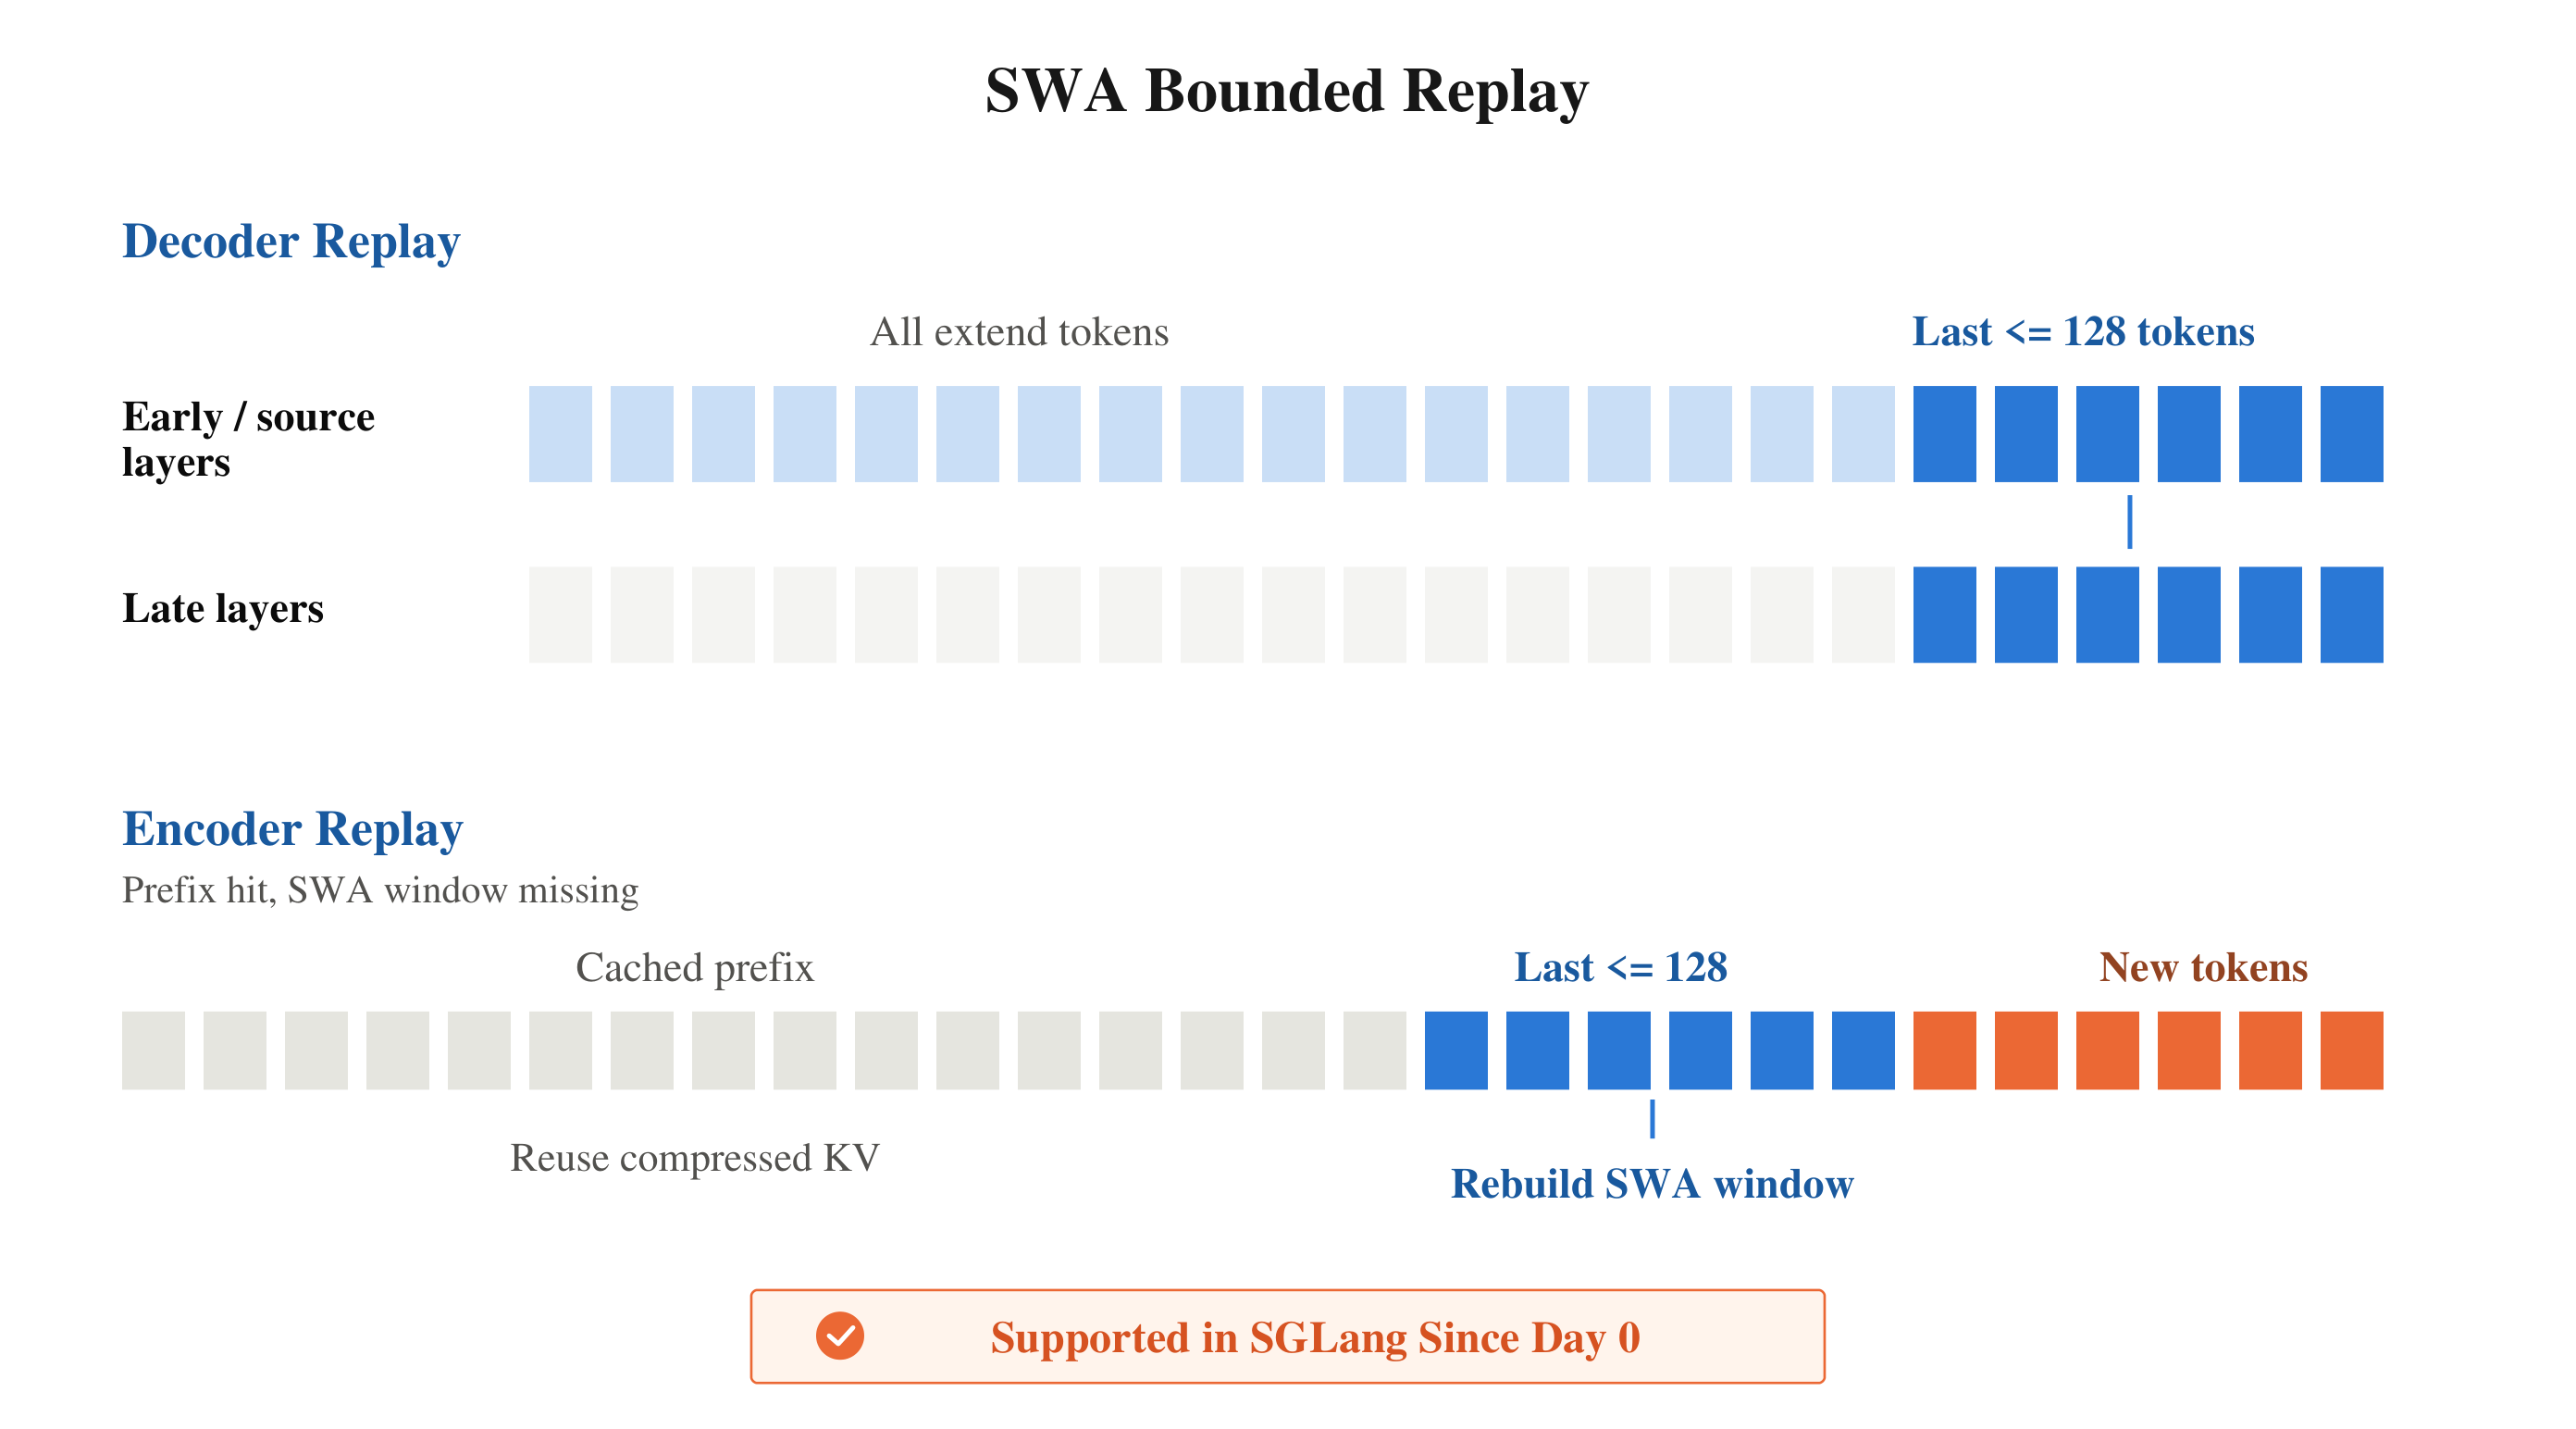
上半部仅让晚层处理最后 128 token;下半部在前缀命中后补建滑动窗口状态。
两者都叫 replay,却有不同触发原因。一个减少长 prefill 的后层计算,一个补回缓存体系没有保留的状态。混合模型的缓存命中不是简单的“全部跳过”;哪些层的状态被保留、哪些能由短后缀重建,决定实际需要做多少工作。
CUDA graph 也顺应这个边界:可中断图覆盖每 GPU 最多 8K token 的 prefill,后段 replay 使用单独的有界图。即使大 prefill 的其他部分改为 eager 执行,后层仍可复用合适大小的图。这种分拆把模型的结构信息直接带入执行调度。
Engram 表放在哪里,是容量与访问的取舍
文章给出主机内存与 GPU 分片两种方式。主机方式让每节点保留一份 Engram 表,为 KV 留出更多 HBM;设备方式把表分到多张 GPU,利用 NVLink 直接从对端读取所需行,避免在查表周围做 all-gather 或 reduce-scatter。
因此,设备表的优势必须和显存占用一起判断,主机表的优势则要和远端访问成本一起判断。原文并未声称某一种在所有并发与硬件下都最优。这也是阅读后续对照的必要背景:两套引擎的某些测试使用不同表位置,配置差异并没有完全消失。
对照成绩与仍然存在的差别
Prefill 在同一四 GPU 节点、相同权重、DP4/EP4、均衡专家路由、关闭 EPLB 和 32 个冗余专家下比较。请求上下文 128K,每请求 4K 新 token,每 GPU 每步处理 4K–64K 新 token。GB300 与 B300 上 SGLang 最高达到测得 DeepInfer 吞吐的 1.04 倍,其余点大体持平。
这里 DeepInfer 在每点取测试过的不同 Engram 配置中的最快值。测量方式仍有差异:DeepInfer 约测 GPU 0 上九个 batch;SGLang 在请求完成 20%–90% 的区间平均所有 GPU 的完整 batch;前者重复同一提示,后者为请求使用不同新 token。1.04 倍因此应连着这些条件读,避免把几个百分点扩大成普遍领先。
Decode 使用 64 张 GB300、16 个节点、DP64/EP64、128K 共享缓存前缀,每步 3 个草稿 token,固定验证完整草稿块和均衡专家路由。16–256 请求/GPU 时步时缩短 1.1%–7.4%,8 请求/GPU 时持平。图中 token 速度按每步接受 3.25 个 token 换算,不是另一次线上实测接受率。
配置还存在两个差异:SGLang 的 Engram 表在设备,DeepInfer 在主机;DeepInfer 草稿有 64 个冗余专家,SGLang 草稿没有。文章提供 commit 和启动参数,使比较更可追查,但这些特例配置不等于生产推荐。
从执行能力到完整服务
SGLang 的 radix cache 在请求和多轮对话间复用状态;图示 Linker 将 L1 GPU 缓存直接接到共享 L3 存储,HiCache 还支持可选主机 L2。P/D 分离可选 Mooncake、NIXL 或 MORI 传输,模型网关在副本间分流并支持缓存感知路由。DeepSeek 自身格式包负责提示渲染与推理、工具调用解析,另有结构化输出约束。
这些组件解释了为何一个离线引擎的参考曲线不能覆盖完整 API 服务的价值;它们也增加配置和故障面,最终仍要看缓存冷热、请求分布和尾延迟。阅读优先级应是 replay 与 Engram 机制、测试附录,再看 headline。文章支持“通用栈接近专用执行性能”的判断,尚不能替代目标负载上的端到端服务评估。
把结果图里的线分清
原文结果图同时包含实测实线和从 DeepInfer 已公布图表读取的虚线。正文 prefill 的倍数以同机实测 DeepInfer 为分母,而不是任意选择一条较低的旧曲线。这个区分很重要:公开图表适合提供参照,同机对照更适合解释几百分点的执行差异,两种证据不能交换使用。
同样,固定验证会让每个请求都走完整草稿块,消除了实际拒绝位置带来的变化,均衡路由则降低了专家热点的影响。它们有助于比较稳定的执行成本,却会让真实流量中的某些难点暂时退出实验。生产环境里草稿质量、不同上下文长度与专家倾斜同时变化,服务排序可能与这个微基准不同。
因此可以把本文的结论分成两层:第一层是指定配置下的 forward 与 step 性能,已有参数与 commit 支撑;第二层是缓存、网关和分离部署等能力已经进入服务栈,说明功能覆盖,但没有被同一张性能图逐项量化。将两层一起看,既能理解通用引擎的进展,也不会把功能列表误当成每个场景的端到端成绩。
一个后续评估可以固定到达流量,分别改变缓存命中率和输入输出长度,并观察首 token、后续 token 与拒绝或重试行为。这里提出的是阅读结果后的工程检验方向;它不改变原文已经测得的核心执行比较,也不把未展示的线上结果补成事实。
缓存层级的名称也不能直接等同于每次请求的读取路径。图中直接连接共享存储是一种配置,可选主机层属于另一种部署选择;哪种更合适仍取决于复用距离、传输成本和可用内存。