SGLang X Ascend Team · 2026-07-28
原文:Toward a Cleaner Quantization Stack in SGLang
量化已经不只是选择一个低比特 kernel:服务引擎还要解释不同 checkpoint,注册参数、加载权重、转换布局,并在不同设备上执行。SGLang 这篇工程文章关注的是这些职责如何拆开,使新增格式和新增硬件不必反复修改同一个大类。
从一个类拆成四层
旧路径可能让同一个量化方法同时负责参数定义、权重加载、布局转换、后端选择和 kernel 调用。格式增多时,平台分支也会混进格式代码;即使底层操作相同,不同格式仍可能维护各自实现。
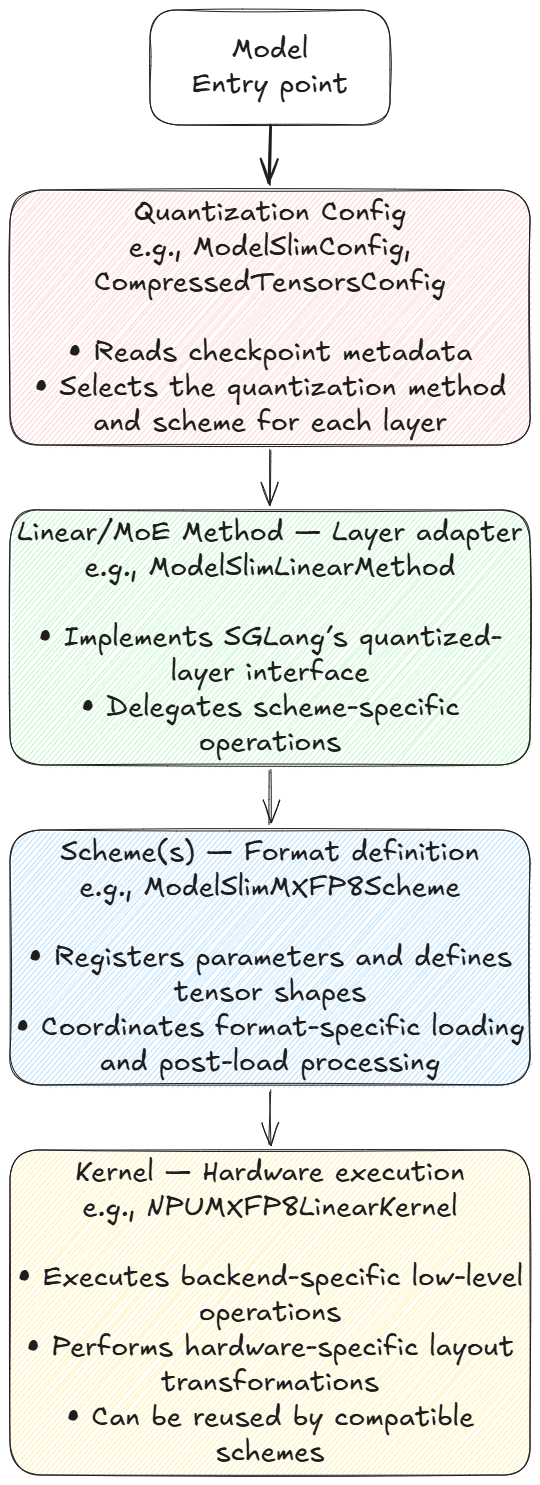
读图:Config 解释 checkpoint 元数据,Method 对接层接口,Scheme 描述格式与参数,Kernel 负责硬件执行。
Config 选择量化路径;Linear/MoE Method 适配 SGLang 的层接口,将具体操作交给 Scheme;Scheme 定义格式对应的参数、形状和加载方式;Kernel 则负责后端相关的权重转换和执行。关键边界是 checkpoint 的含义与硬件执行分离:多个兼容格式可共用同一个 kernel,而硬件代码不必埋在每个格式类中。
离线加载路径中,Scheme 负责参数定义和权重加载,Kernel 负责加载后的变换及执行。同一 kernel 也可作为在线量化路径的独立执行器。文章称迁移仍在逐步进行,未来希望将更多后端选择移到平台层;这不是所有格式与设备已经完成迁移的声明。
数据说明量化取舍,而非重构本身的加速
文章给出的 Qwen3-30B-A3B 对比中,BF16 权重为 61.08 GB,W4A4_W8A8 为 21.59 GB;平均 token 间延迟从 26.23 ms 降至 23.84 ms,GSM8K 从 91.1% 降至 89.4%。首 token 延迟则从 2084.41 ms 上升到 2299.51 ms,因此不能把节省权重空间直接等同于所有延迟指标都改善。
附录使用 Ascend NPU、张量并行度 4、64 个请求和最大并发 64,随机输入与输出长度均为 2048;GSM8K 使用 1319 道题。这组结果比较量化方案,并未隔离证明四层重构单独带来的速度收益。不同负载、模型和硬件的结果也需要分别验证。
工程意义和后续边界
拆分后,格式检测、参数注册和加载逻辑可以在 CPU 环境单独测试;硬件测试则聚焦转换正确性、kernel 正确性和性能。新格式或新 kernel 也更容易独立审查。这对多硬件推理服务的维护与故障定位有实际意义,因为格式问题与后端执行问题有更明确的责任边界。
路线图还包括能力注册表、更多低比特格式和设备覆盖,以及 MoE、KV cache、通信等路径。它们是后续工作,并非这篇文章证明已全部交付的能力。