Plawan Rath, Akhil Jindal, Ashwini Verma · Meta Engineering · 2026-10-19
原文:The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do
让中央 Agent 掌握全部领域知识,看起来能减少交接,却也可能让不同子系统的约定混在一起。Meta 的数据列接入流程跨三个代码仓库、三种编程语言,最多六个管道阶段;字段命名、代码生成和数据源规则彼此不同。团队把这些知识集中给一个 Agent 后,发现它会把 A 子系统的规则用于 B,更多上下文没有自动带来更可靠的修改。
Thin Orchestrator 的变化是重新分配职责:路由层只决定先后次序、收集输入、检查可靠性条件;领域推理由隔离上下文的专家处理。文章描述一个约 1,300 行的编排器,连接 14 个专家,支持 20 多种工作流。代码行数不是效果来源,真正可借鉴的是哪些决定可以从概率推理里移走。
先把流程中确定的部分固定下来
每次请求遵循七步协议:读取专家说明;检查目标是否已存在;收集必需字段;发现仓库类型和已有配置等可推断信息;检查警告及所需 reviewer;委派给专家;整理结果并报告错误或成功。作者明确说,只有委派后的专家步骤使用 LLM 推理,其余步骤按确定性逻辑执行。
重复对象检查意味着重试之前先确认已有状态;字段收集使专家不必一边猜需求一边修改代码;可靠性 gate 则让警告和审阅要求成为委派前的条件。它们降低的是错误进入下游的机会。这里的工程解释是:将能用程序判定的事实留在程序里,可以减少模型在流程控制上犯错的维度,但仍要正确实现这些检查。
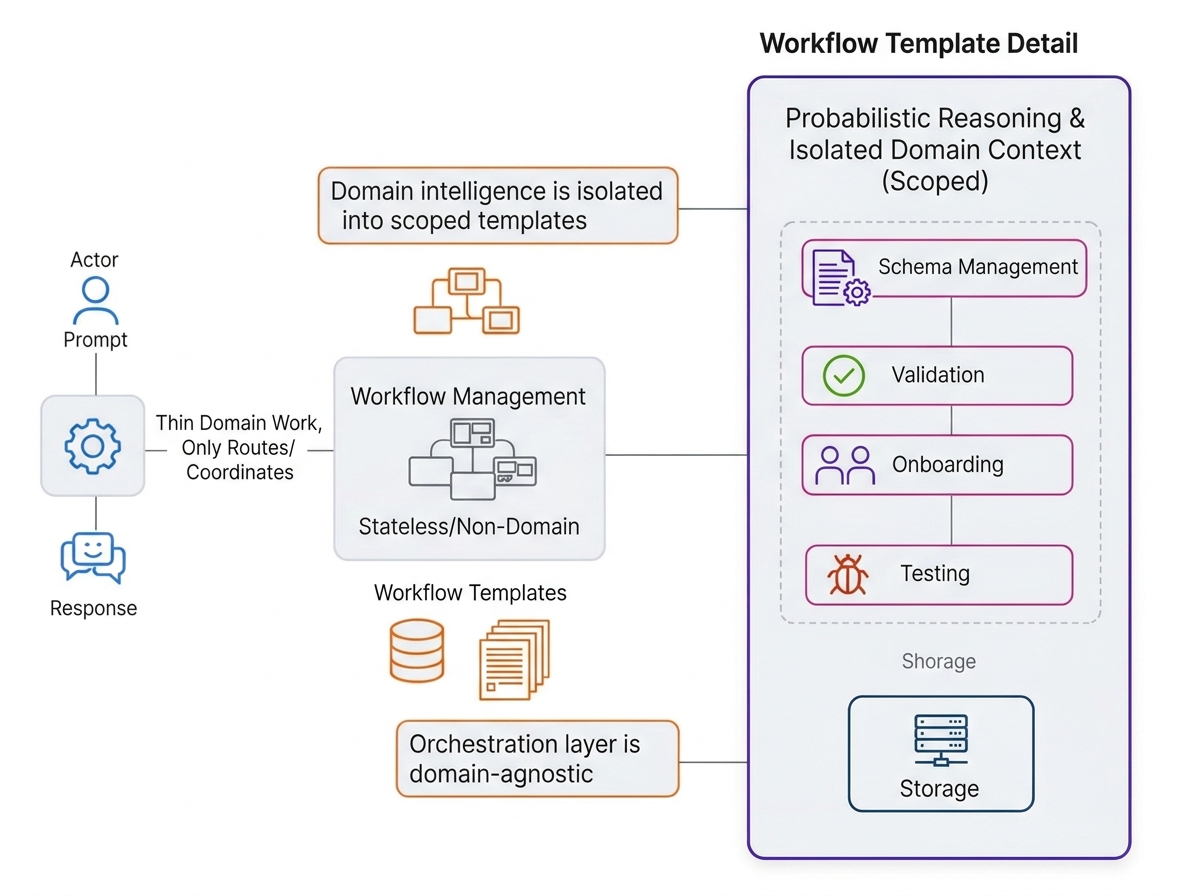
左侧路由层协调请求,中间选择工作流模板,右侧把 schema、验证、接入与测试放进受限的领域上下文。
工作流模板与专家池分开演化
列接入采用 schema→验证→population→测试;事件接入重新排列并增加事件处理;管道迁移则使用评估→规划→population→验证→监测。模板规定阶段顺序,同一专家可以被不同流程复用。文章称增加迁移场景时只需组合现有专家,没有增加新的 Agent 代码。
这种复用也意味着接口比角色名字更重要。每个专家有统一结构:运行时知识源、委派前必须收集的信息、执行步骤、仓库发现模式和故障处理办法。编排器因此知道该提供什么、如何判断结果;专家无需读取所有其他领域的细节。若两个步骤仍依赖未声明的共享假设,简单拆成多个 Agent 并不会自动消除耦合,这是迁移该模式时需要检查的地方。
知识被放在 25 多份按领域组织的文件中,执行时按需加载,单份通常数千 token。更新文件后,下次会话读取新知识,无需把全部说明重新嵌入编排器。这样的维护路径把领域变化和路由代码变化分开,但也引出版本一致性问题:跨阶段任务应知道自己依据的是哪套知识。后一点是从架构得到的工程判断,原文没有报告对应版本控制实验。
什么结果已经观察到
作者称,新列的配置准备人工需要三到四天,较早的配置驱动系统约一天,薄编排器系统缩短到一小时以内;约三分之二的修改无需显著人工编辑便能落地。这两个指标分别描述时间和人工修改程度,不能合并成全自动成功率,更不能当作所有六阶段端到端上线都在一小时内完成。
另一种单 Agent 方案在工程师逐任务定制提示后成功率为 70–80%,没有这种手工辅助时为 10–20%。这些数字帮助理解原有操作成本,但文章未给完整样本量、任务配对和统一成功定义,所以不能据此计算严格的因果提升。文中引用其他研究的准确率与 token 节省也不是 Meta 这套系统的测试结果。
更可信的解释是,专门化减少混杂知识,而固定状态机压缩不必要的控制决策。系统以领域覆盖面换取对具体管道的深入支持;一套非常稳定的内部流程,通常更容易获得这种收益。把它换成需求开放、探索路径不确定的研究 Agent,模板也许会过早锁定路线。
隔离上下文不等于自动隔离副作用
文章提出专家失败时由编排器重试或升级处理,减少错误污染其他上下文。这有助于推理隔离,但共享代码仓库、外部服务和半完成修改仍可能跨步骤留下影响。要把“失败被控制住”变成系统保证,需要知道哪些动作幂等、哪些结果可验证、重试从哪里开始;这些是模式落地时的接口问题,不是再增加一个角色就能解决。
判断一个步骤是否适合固定下来
这套模式并不要求所有分类都能靠几个关键词解决。更实际的划分方法是检查输入和输出是否有稳定契约:目标仓库是否能由已有元数据确定,必需字段是否有明确 schema,是否已经存在相同配置,哪些警告必须阻断流程。如果这些条件有权威来源,编排器就不需要让模型反复猜测。遇到真正无法确定的意图时,应把不确定性暴露出来,而不是以确定性名义隐藏另一段未受约束的推理。
同样,专家返回“完成”只是消息,不是工作已满足要求的充分证据。对于配置生成,可以检查产物和构建结果;对于迁移,可以明确哪些旧路径保留、哪些新路径启用。这些是依据文章边界划分提出的实施判断,并非原文额外报告的测试结果。它们解释了为什么薄路由层仍有重要工作:将每个阶段的结果变成下一阶段可依赖的输入。
因此推广时不应追求复刻十四个专家或一千三百行代码。更好的比较对象是同一任务在不同职责划分下需要多少人工澄清、失败后能否定位到具体阶段,以及知识更新是否意外改变其他流程。
未来计划包括从生产反馈识别失败模式、提出知识文件改进,并由人工审核后生效。它说明持续改进还需要独立的变更边界。最值得从原文带走的做法,是逐项列出路由、输入校验、领域推理与执行检查各归谁负责,再判断模板和专家是否真的可独立更新。对于流程清晰、领域知识庞杂的内部工程任务,这比单纯扩大中央提示词更有研究和实践价值。