PyTorch / Meta · GPU 内核工程实践 · 2026-10-01
原文:Optimizing Jagged Flash Attention with TLX: The Road Toward SOTA FA4 on Blackwell · 实现与适用条件
这篇报告值得看什么
这篇报告同时面对两个问题:注意力内核如何充分利用 Blackwell,以及模型工程师能否持续修改它。Meta 的推荐模型需要处理长短差异很大的用户序列,还会尝试不同窗口、精度和稀疏模式;一个只能由少数底层专家维护的快速内核,会让下一轮模型实验变慢。
TLX 是 Triton Low-level Extensions。这里的重要变化是,在 Triton 风格的代码中显式描述异步搬运、warp 分工、共享内存与 tensor memory 的使用。开发者获得更多控制,也承担更多调度与同步责任。它并不是换一个编译器开关就自动达到最佳性能。
阅读主线是“瓶颈怎样被定位、调度怎样随之改变”。 速度数字可以说明这次实现有效,但最可迁移的经验是识别等待发生在哪里,再选择合适的并行和缓冲方式。
不等长序列为什么改变问题
把一个 batch 全部补齐到最长序列,会花计算处理无意义的 padding。Jagged 表示将有效 token 连续存储,通过 offsets 记录边界。这样消除了补齐工作,却带来新的调度差异:不同序列对应的 tile 数量和计算量并不相同。
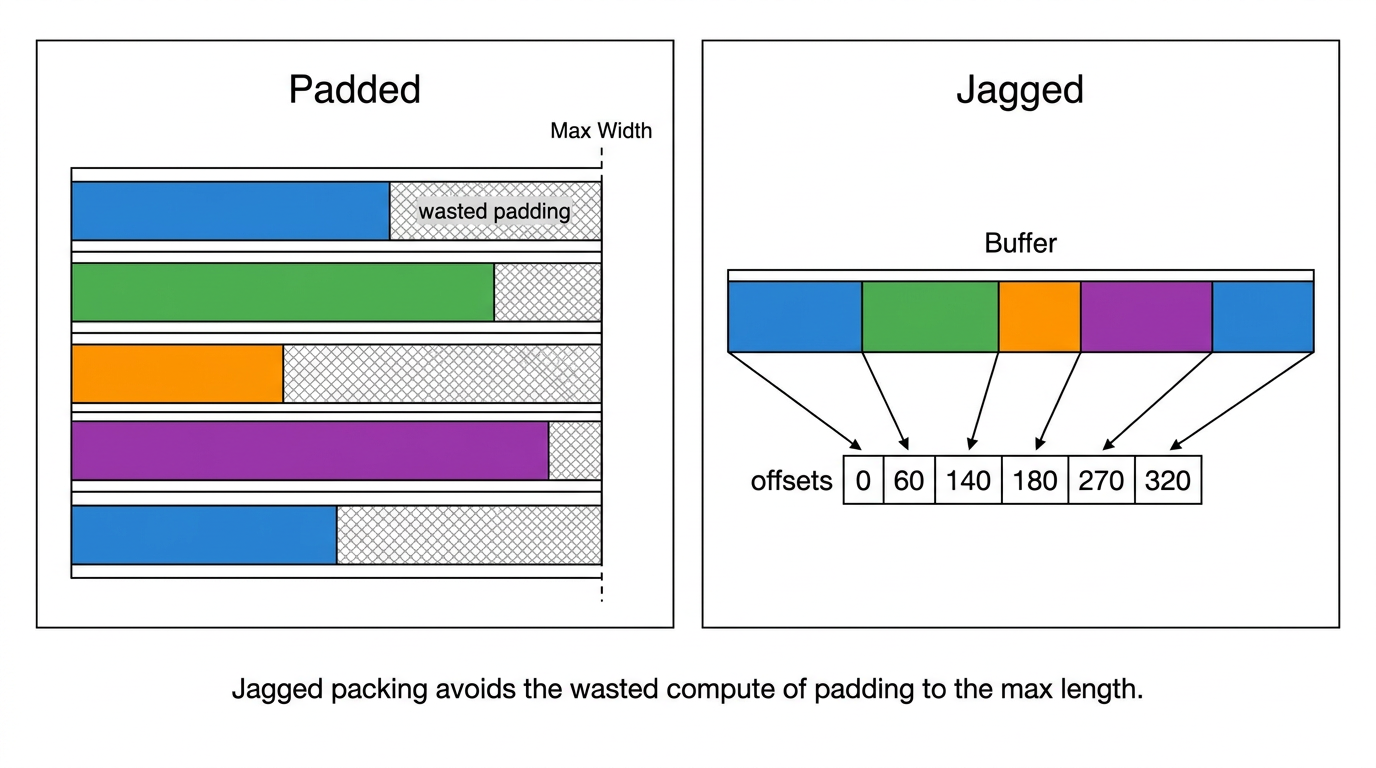
读图:左边补齐到统一长度,灰色区域没有有效 token;右边紧凑存储,只用 offsets 标出各序列起止位置。节省 padding 不等于已经解决 GPU 各部分的负载均衡。
文章的主要生产场景还带有 broadcast-Q:一个共享的 Q 对应多个不同长度的 K/V 序列。反向计算时,各序列对共享 Q 的梯度必须加总。因此,前向怎样分 tile 与反向怎样累加 dQ,具有不同的瓶颈,不能照搬同一调度策略。
架构:让搬运、计算和写回同时向前走
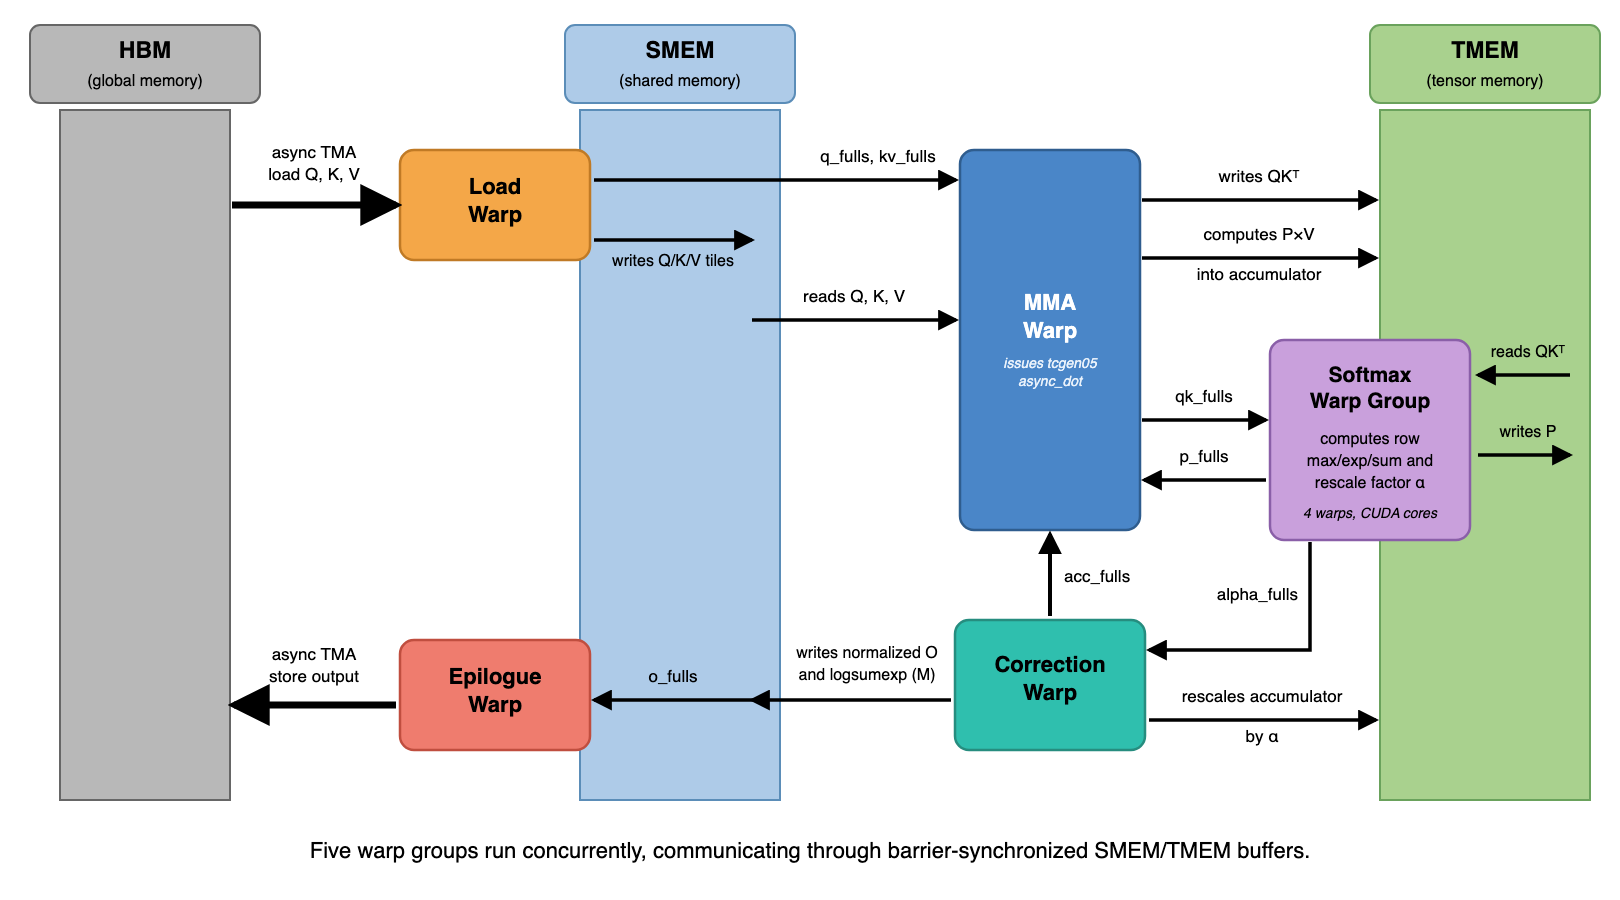
读图:关注不同角色之间的依赖和重叠;加载、矩阵乘、softmax 与写回由专门的执行角色负责,缓冲区和同步信号约束数据何时可读、何时可复用。
作者将一个线程块内的 warp 分成不同角色:读取数据、发起 tensor-core 矩阵乘、执行 softmax 与修正、写回结果;反向还有专门的 dQ 归约角色。生产者和消费者通过显式同步交换缓冲区,K/V 多缓冲允许数据读取提前进行。
这类设计的目标不是增加角色数量,而是减少关键计算单元的空等。若加载和计算完全串行,即使两者各自很快,总时间也近似相加;形成稳定流水后,部分等待能被其他工作覆盖。但过多缓冲会占用片上空间,过早复用缓冲又可能破坏正确性,所以速度与资源、同步必须一起分析。
负载均衡为什么需要静态和动态两层
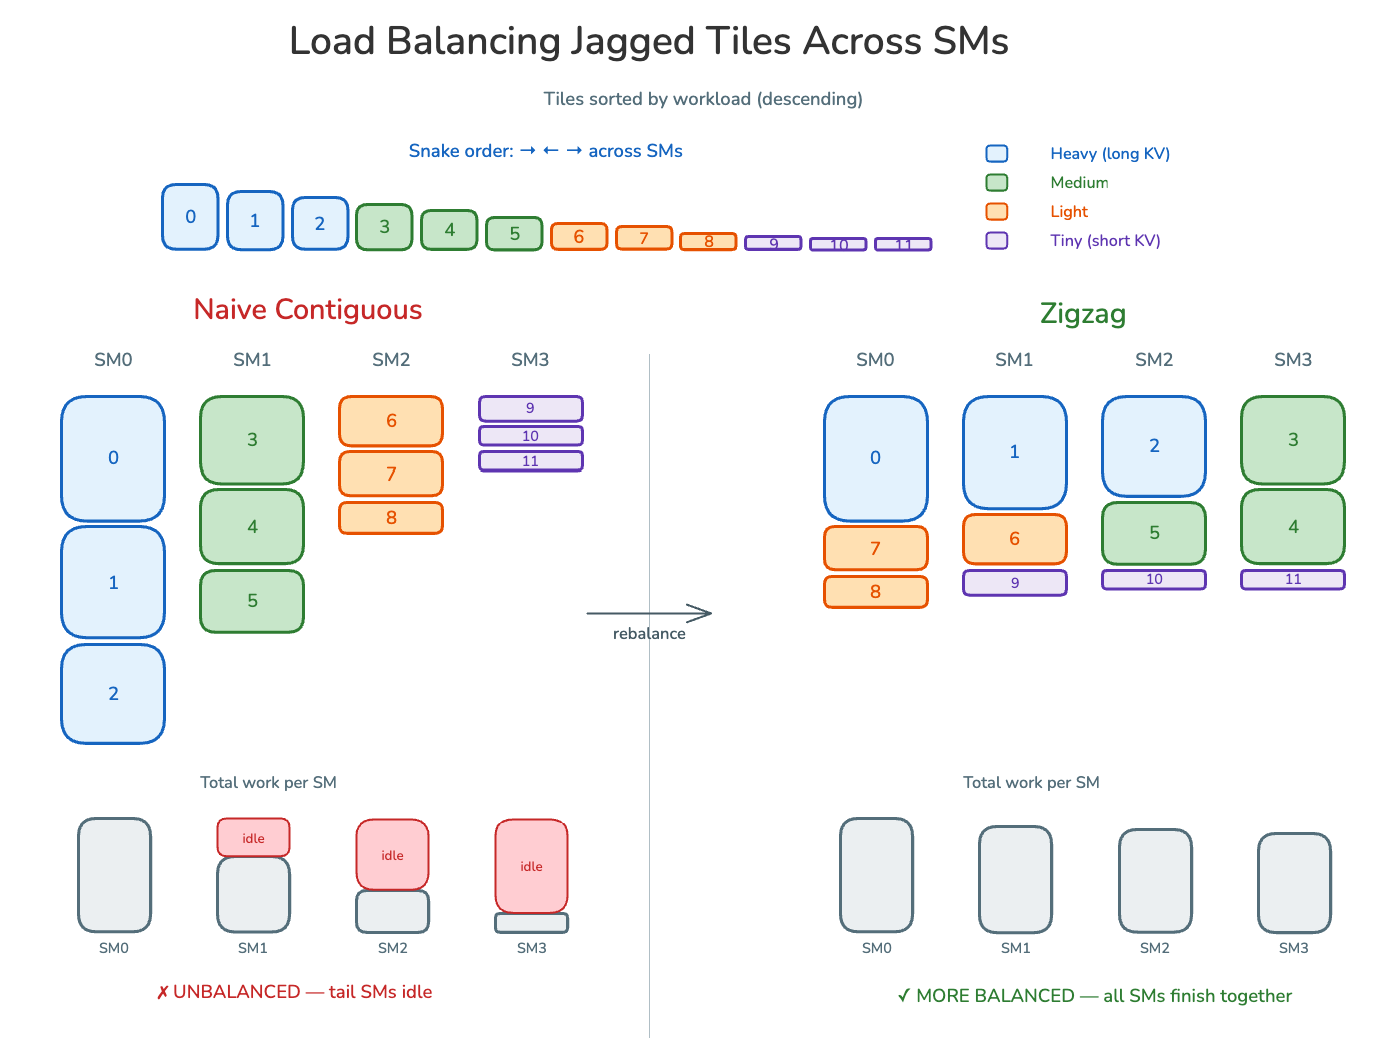
读图:连续分配可能让少数 SM 拿到大量重 tile;右侧 zigzag 把长短工作混合分配,减少先空闲和最后拖尾的 SM。
前向中,tile 成本随对应 K/V 长度变化。作者先按工作量排序,再用往返式分配把重轻任务铺到不同 SM。反向的 tile 成本更接近,但各序列的 tile 数不同,因此更适合预先列出有效 tile,再轮转分配。
Blackwell 的 Cluster Launch Control 进一步按运行时进度分发工作,让先完成的 SM 获取后续任务。TLX 的 CLC 官方说明提供了这一机制的背景。静态与动态方式并非重复:前者可以提前删掉空 tile、改善初始分布,后者处理执行过程中才显露的差异。
对工程实践的启发是,先问“不均匀来自单个任务的成本,还是任务数量”,再选调度策略。只看平均长度,容易掩盖尾部工作拖慢整个 batch 的情况。
小优化为何能改变整条流水线
报告中的 dQ 写回竞争、TMEM 释放时机和循环尾部处理说明,瓶颈不一定在最大的矩阵乘上。共享 Q 的梯度归约容易竞争;如果写回阶段一直占着下一轮需要的缓冲,计算单元也会跟着停。
作者以分阶段写回和提前释放缓冲减少这类等待,并将仅在末尾 tile 才需要的掩码处理从主循环中分离。后者值得注意:很少执行的分支仍可能影响静态寄存器分配,导致热路径溢出。优化因此需要结合 profiler、编译日志与受控 A/B 延迟,而不能只凭代码行数猜测。
这是本文的工程解读:流水线优化应沿依赖链看收益。某一步更快是否重要,取决于它是否解除关键路径上的等待;反之,一个看似不起眼的释放点可能影响下一轮全部计算。
怎样理解性能结果和功能范围
作者在 B200、BF16 下,与 2026 年 5 月版本的 FA4 比较。报告的 jagged 工作负载平均吞吐提升约为前向 13%、反向 50%;在 dense 场景,前向约为 FA4 的 87%,反向约高 17%。这些是指定形状和实现版本下的内核结果,不是所有 Blackwell 注意力负载都获胜,也不是训练端到端加速。
当前官方 README 还明确限制:要求 SM100+;head dimension 不超过 128;GQA 支持前向,反向要求单 query group。双 CTA 协作反向只覆盖 broadcast-Q、head_dim=128、单 query group、无滑动窗口且启用负载均衡等条件,其他支持的情况走单 CTA 路径。这里的 README 是本次核对时版本,实际使用应固定提交。
报告也探索低精度与块稀疏变体,但不能仅因文章提到,就假定所有变体已经由公开包完整支持。代码行数更少同样不等于维护成本已被独立量化。
继续阅读与实际采用
做推荐模型或 jagged attention 的工程师,可以优先核对自身长度分布、broadcast-Q 语义、前反向需求和数据精度,再看官方测试。做通用 LLM 服务的读者,则更适合学习负载均衡和异步流水的分析方法,而非直接搬用报告倍率。
若要验证,应保持输入、精度、实现版本一致,分别比较正确性、前向、反向和端到端时间,并观察长尾形状。本篇是原文解读,未在 B200 上运行性能复现,也未在网站服务器安装或执行内核。