研究窗口:2026-09-11—2026-11-11,Asia/Shanghai。 本次核对 20 项近期工作:17 篇论文与 3 份官方研究/评估报告,按研究问题分组。较早的理论与评测只作背景,撤回稿另列状态,不靠标题中的 self-improving 决定纳入。
结论:闭环正在落地,持续自加速仍缺证据
让 AI 优化一个产物、让 Agent 修改自己的执行系统、让改进后的系统更有效地研究下一代,是三种不同强度的主张。这批材料对前两类已有具体实验,对第三类只有有限轮次或有限场景的证据。 它们尚不足以证明无界、持续加速的自主前沿模型研发。
当前变化集中在五处:改进对象从提示走向可执行 harness 与探索策略;迁移效果开始约束演化集分数;系统优化走到整个推理引擎和训练基础设施;工作流与权重进入同一个学习循环;验证器、经验库与训练数据也成为会被优化甚至攻击的环节。
阅读时应始终分开三件事:哪个对象在变、什么变化进入了下一轮、谁仍掌握采用与评价规则。 系统名称、自主运行时长和最高分都不能替代这三个答案。
| 证据类别 | 本专题怎样使用 |
|---|---|
| 跨轮持久自改 | 检查实现/策略是否继承,以及未见任务和匹配预算对照 |
| AI R&D 邻接工作 | 纳入真实优化闭环,同时标明 Agent 是否固定、是否依赖人类 |
| 数据与权重更新 | 区分开发者 Agent 和被训练模型,检查是否真正形成后继链 |
| 评估与实验室测量 | 保留任务、资源、代理指标、删节和归因边界 |
| 安全实验 | 关注监督和污染的跨轮继承,不把概念验证写成普遍攻击率 |
建议先读:按问题选择阅读路径
这是阅读顺序,不是引用量榜或收录名额。若从性能、可靠性和 AgentOps 出发,可以先读 Exo → InfraRSI → RRSI → AIDE²,再看权重闭环和实验室测量。
| 工作 | 最值得带着哪个问题读 | 下一步对照 |
|---|---|---|
| Exo | 自改时谁保护状态、激活与恢复? | Harness²、跨代污染 |
| InfraRSI | 提速是否仍完成同一训练任务? | ForgeKernel、SEIS |
| RRSI | 演化分数上涨,迁移和成本怎样? | ModularRSI |
| AIDE² | 新 Agent 是否让后续改进更有效? | Dream-RSI |
| Dream-RSI | 能否低成本学习更好的探索策略? | AIDE² 的外层实验 |
| Self-HPO | 模型与 harness 怎样保持匹配? | JoMoHa、MASS |
| MASS | 团队轨迹能否成为下一轮学习信号? | RSI Arena 的外部反馈 |
| METR 高访问评估 | 实验室加速的分母与因果归因是什么? | 预部署评估与公开删节 |
自我改进 Agent:改执行机制,还是改改进机制?
01 · AIDE²
Recursive self-improvement of AI research agents
首发(中国标准时间) 2026-09-22 · 2609.26457v1 · Dhruv Srikanth, Bingchen Zhao, Dixing Xu 等 · Weco AI
闭环对象: 研究 Agent 自己的搜索、记忆和上下文代码。内层在固定预算下做 AI R&D 任务;外层提议 Agent 改写,用选择任务的私有评分决定接纳,接受的新实现成为下一轮编辑对象。主长程实验使用固定外层 Agent 改写内层实现,外层采用规则也固定;将演化后的 Agent 换作外层 improver 是另一组实验。
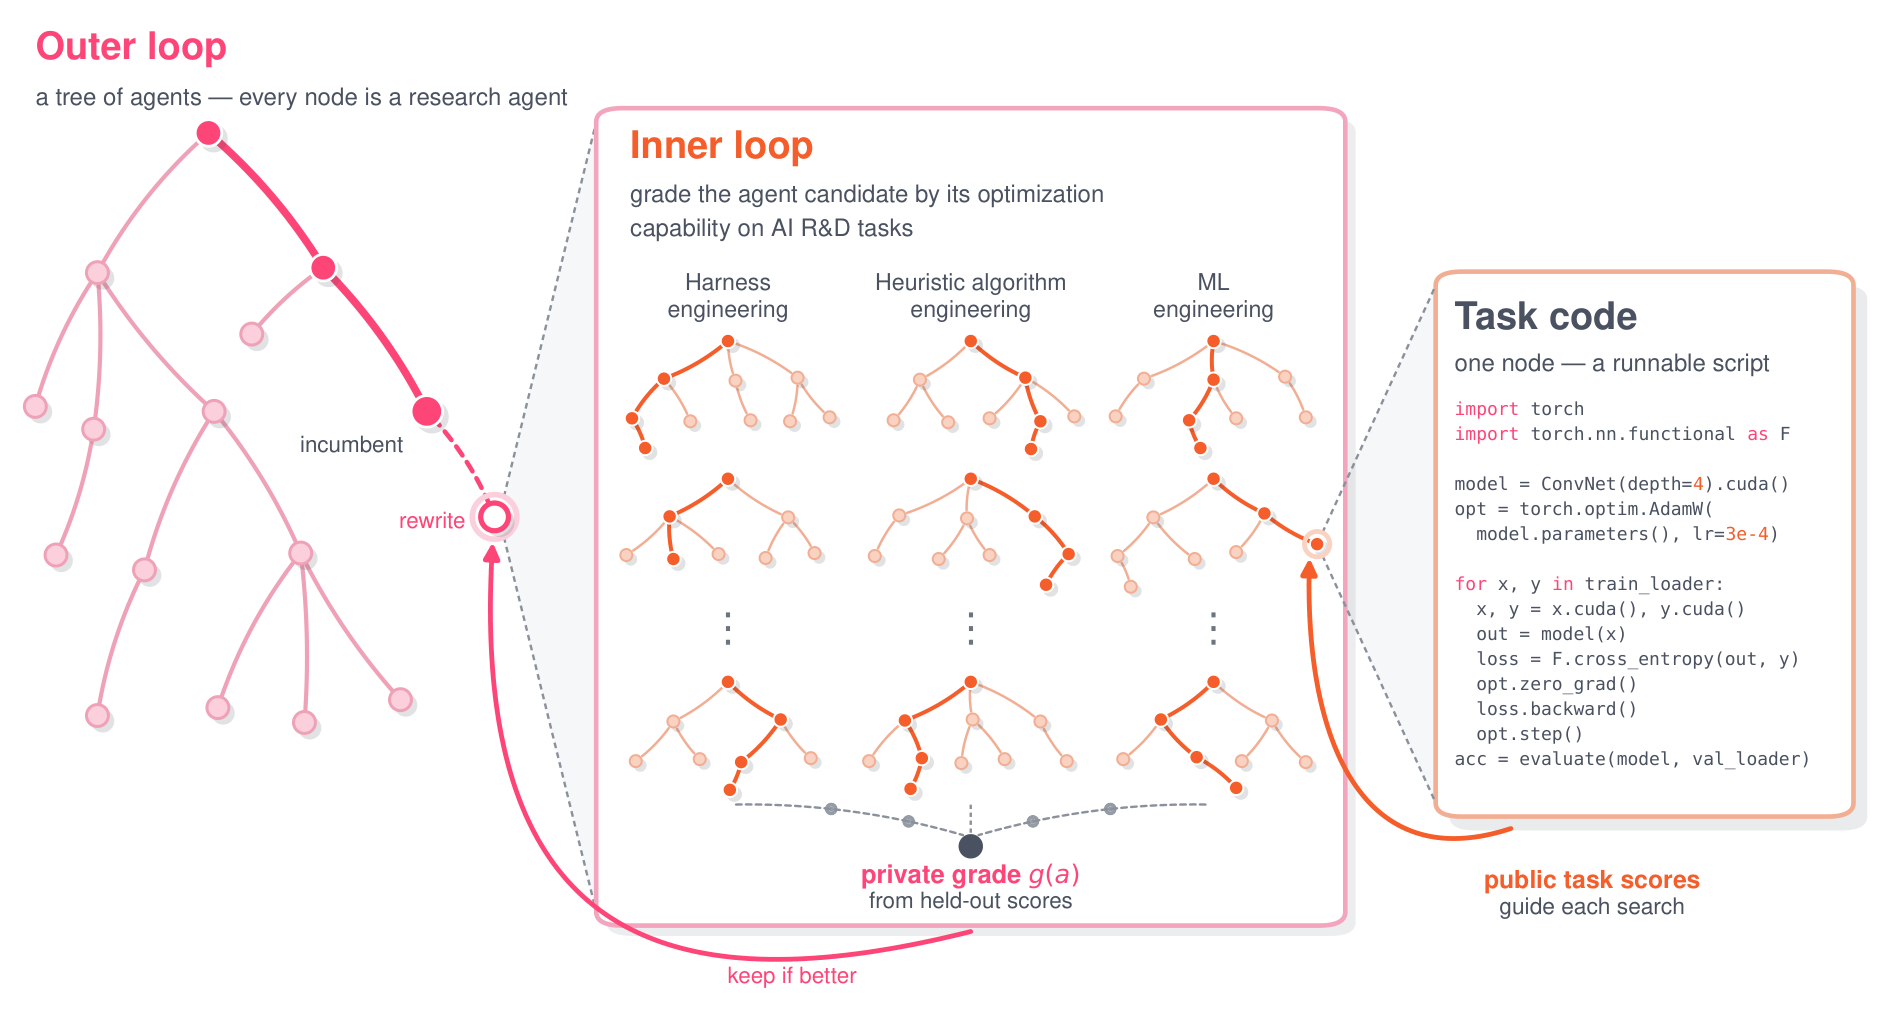
读图:外层改研究 Agent,内层用它做任务;公开任务反馈与用于选择 Agent 的私有评分分开。两棵树的改进对象不同。
证据: 一次八天自主运行得到七次连续接纳的改进;最终版本在四个保留基准上匹配或超过人工开发的生产 Agent,包含选择任务域之外的天气预测。
边界: 当演化出的 Agent 被用于外层 improver 时,叠加噪声和额外随机种子的成本使它与强基线无法被明确区分。更好的研究 Agent 已有证据,更快产生改进的 improver 仍需单独证明。
02 · RRSI
RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
首发(中国标准时间) 2026-09-22 · 2609.24972v3 · Peng Xia, Rujun Han, Zifeng Wang 等 · Google Cloud AI Research / UNC-Chapel Hill / Stanford
闭环对象: 冻结模型外围的 harness。逐渐收紧编辑预算并保存演化证据,选择侧检查泄漏、噪声和成本,再引导删除持续无用的组件;噪声带内候选仍有单独的成本与新颖性规则。
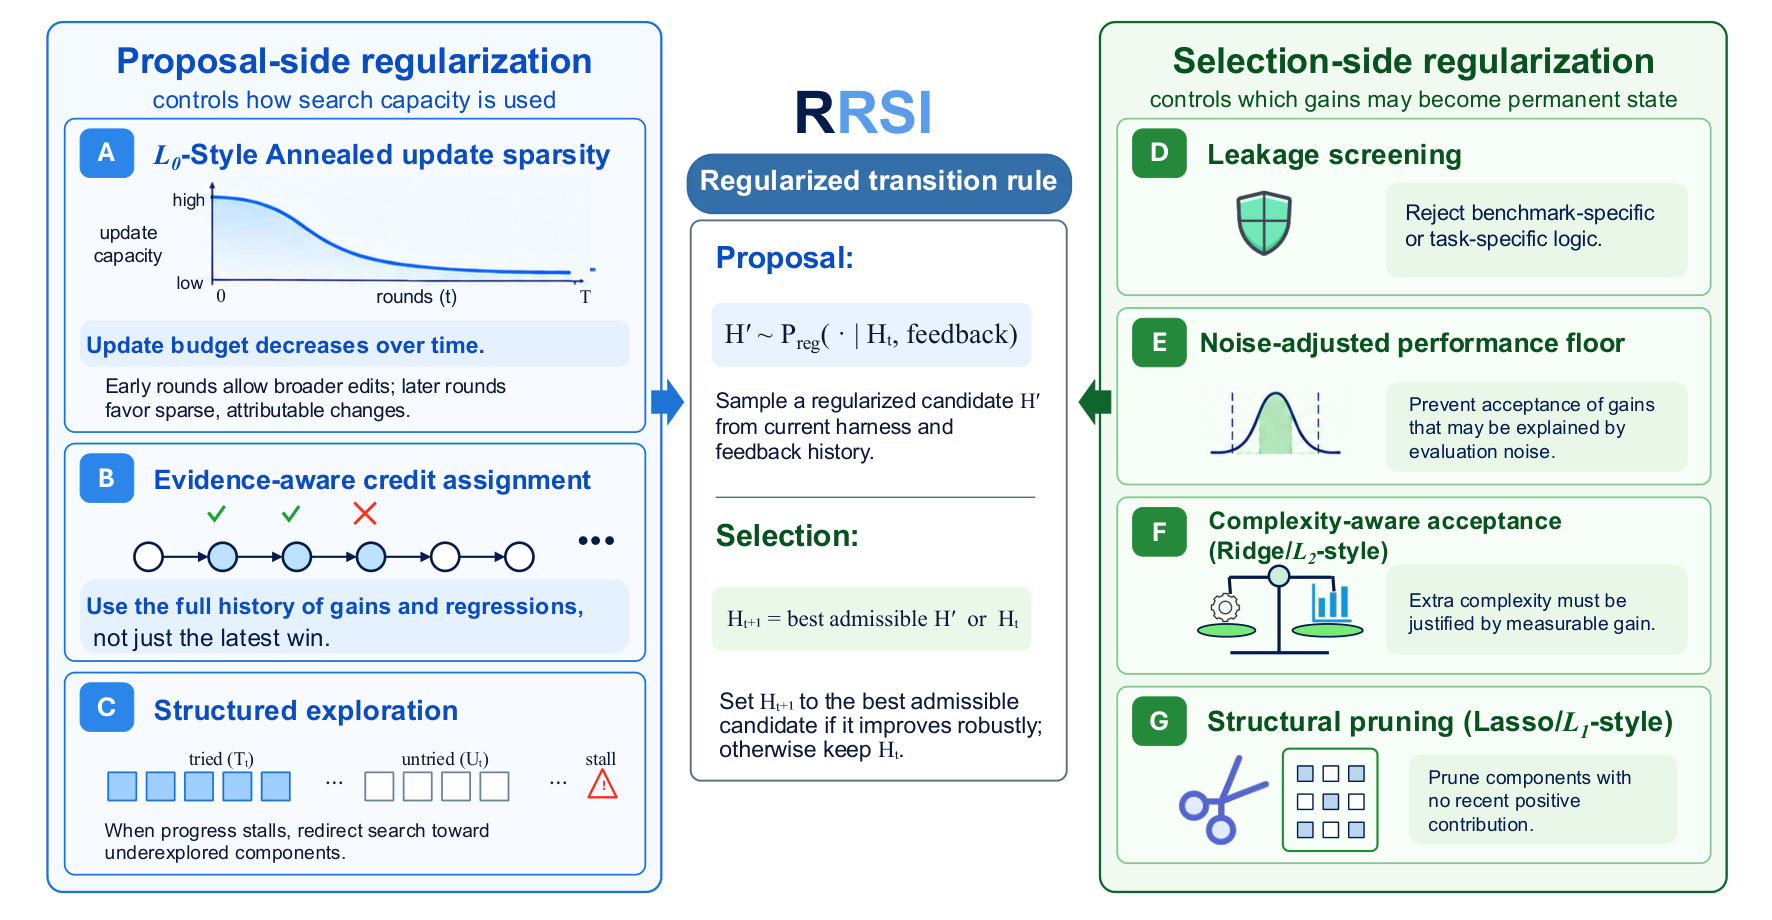
读图:左侧控制搜索容量如何使用,右侧决定哪些变化可进入持久状态;泄漏、噪声和复杂度都参与筛选,不只看最高分。
证据: agentic workspace 的对照中,RRSI 的 OOD 均分为 43.6,初始为 39.7,未正则演化为 40.3;policy tokens/trial 分别为 2.42M、1.56M、3.80M。更高 evolve 分并没有自动转成更强迁移。
边界: 2.42M 低于未正则版本,却高于不演化基线;不是“自改总比不改便宜”。组合消融不等于各机制都被单独归因,有限演化集与模型审查器也不给出泛化保证。
03 · ModularRSI
ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement
首发(中国标准时间) 2026-09-14 · 2609.14857v2 · Siwei Wu, Jincheng Ren, Yizhi Li 等 · IQuest Research / University of Manchester / Beihang / M-A-P
闭环对象: 将 harness 拆成循环、工具、观测、上下文和完成检测五个模块。同题成功/失败轨迹用于定位缺陷,各模块独立演化后再集成,避免只用总分猜哪里该改。
证据: 使用与下游基准不重叠的 2,000 个可执行任务。DeepSeek-V4-Flash-Preview 的 TB2.0 从 47.57% 到 52.43%,SWE-bench Verified 从 73.40% 到 76.40%;另测跨领域、跨模型迁移。
边界: 它主要加强机制归因与评测隔离,仍依赖外部任务和验证器。与 RRSI 比较时,应匹配基线、模型、任务和搜索预算;不能拿不同版本上的最大增益排序。
04 · Dream-RSI
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
首发(中国标准时间) 2026-09-14 · 2609.14858v2 · Tong Zheng, Xidong Wu, Zheng Zhang 等 · Google / Google DeepMind / University of Maryland
闭环对象: 探索编排策略,底层 coding agent 不变。将已完成的 discovery tree 当作回放模拟器,低成本试验分支、并行和停止策略,再把选中策略部署回在线发现,继续积累历史树。
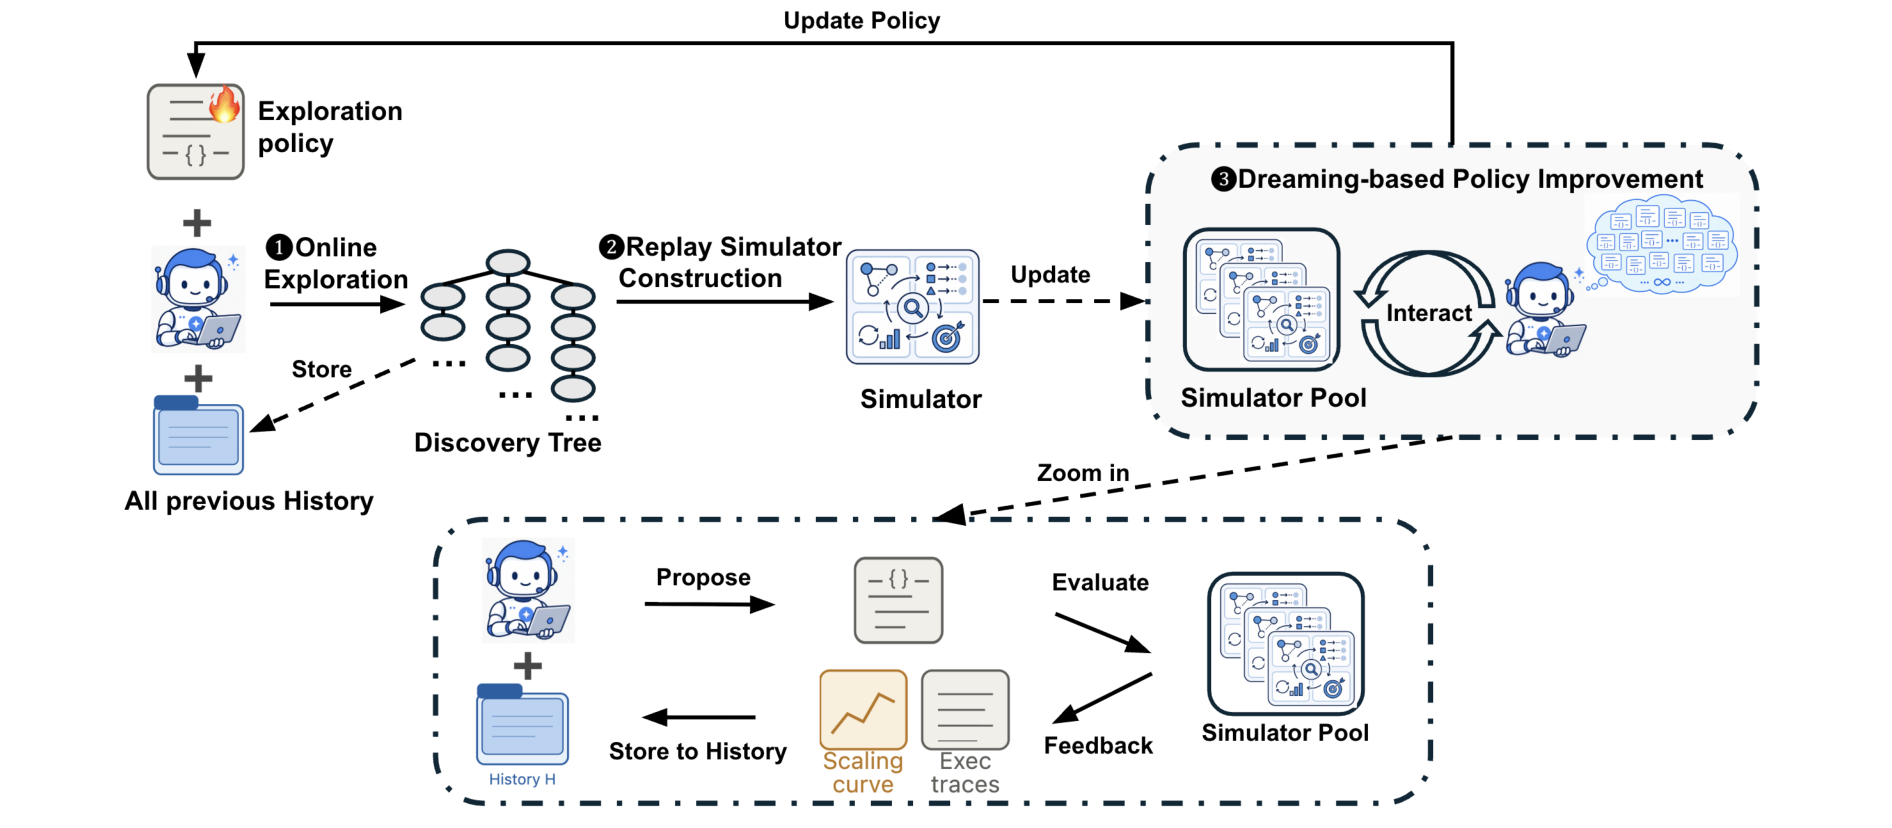
读图:已完成的发现树进入模拟器池,候选探索策略先在历史中回放,再部署回在线探索。模拟器覆盖的是已实现的搜索空间。
证据: 四个领域、九项任务上比较发现质量与成本;链条包含在线探索、历史回放和再部署,而非只在固定轨迹上离线挑一个策略。
边界: 回放覆盖的是已经实现的搜索空间,不能预测任意未探索分支。效率改善发生在特定设置,不应压成统一加速倍数,也不能说底层模型变强了。
05 · Self-HPO
Self-Evolving Coding Agents via Harness-Policy Optimization
首发(中国标准时间) 2026-10-16 · 2610.22791v1 · Zhepei Wei, Wenlin Yao, Baolin Peng 等 · Microsoft Research / University of Virginia / CMU
闭环对象: harness 与任务策略交替更新。H-step 让当前模型分析失败、提出并选择 harness;P-step 在选中 harness 下做 RL,新的困难任务再进入下一轮搜索。
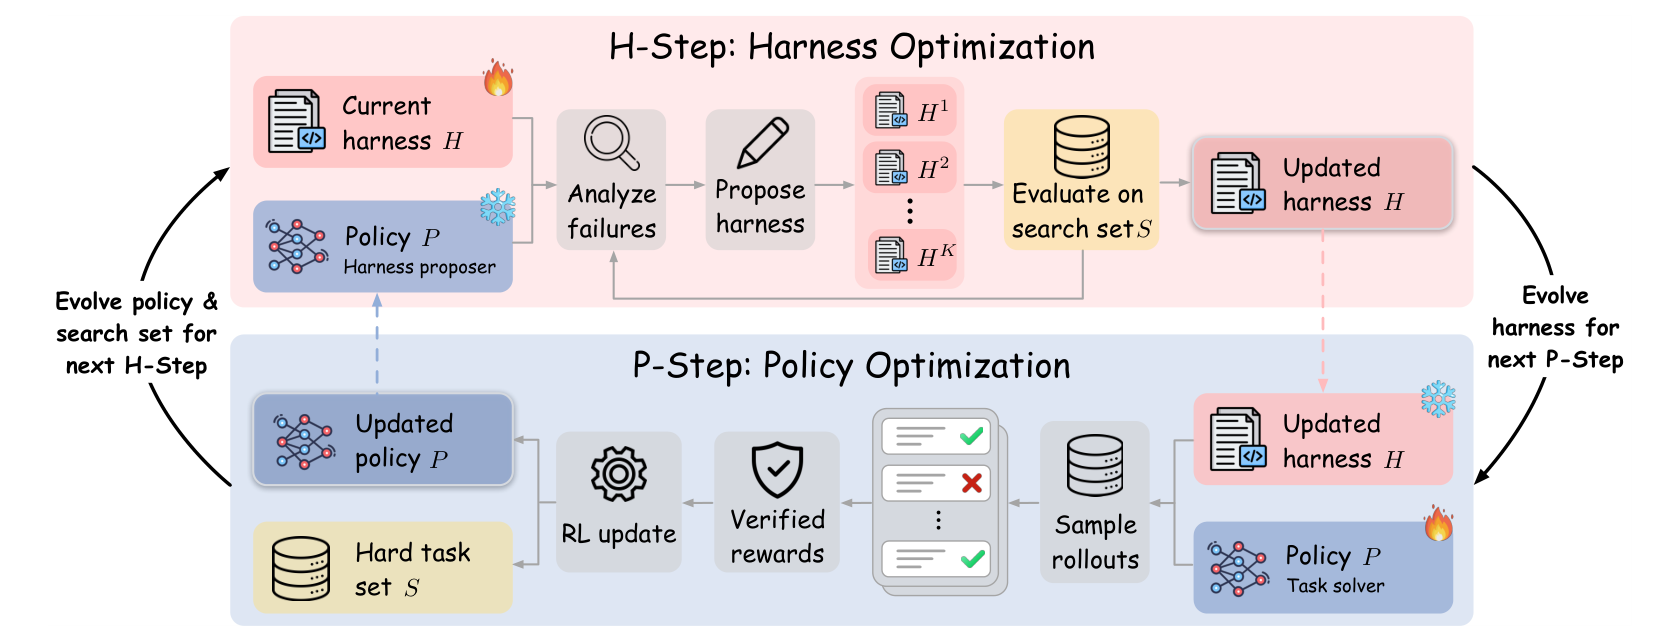
读图:上半部选 harness,下半部训练策略;未解决任务和更新后的策略返回下一次搜索,形成组件相互适配的循环。
证据: 两轮交替,每个 H-step 六个候选、P-step 50 次 RL 更新。Qwen3.5-35B-A3B 在三个 coding 基准的平均解决率从 57.8% 到 64.8%,并比较单独改 harness、单独训 policy 和交叉配对。
边界: 两轮和一个主要模型族不足以证明长期正反馈。外部强模型提案的扩展设置,也不应与当前模型自己提案的主实验混为一组结果。
06 · Harness²
Harness^2: Recursive Agent Harnessing for an Open World
首发(中国标准时间) 2026-10-10 · 2610.14224v1 · Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu 等 · Google Cloud AI Research / Northwestern University
闭环对象: 任务层修订当前 harness,harnessing 层把编辑经验沉淀成面向未来任务的改进机制。使用 Propose–Probe–Compose,针对没有现成真实答案验证器的专业开放任务。
证据: 三个专业基准、四种模型—harness 配置;单步最高增益为 WorkBuddy-Bench 11.5 分、JobBench 4.5 分、LAB 11.8 个百分点,并分析增加任务内递归预算的效果。
边界: probe 和模型判分不是正确性的独立证明。要区分同题多花测试时预算的收益,与跨任务经验真正改善后续改进;也要检查 rubric 没列出的约束。
07 · Exo
Exo: An Architecture for Self-Improving Systems at Runtime
首发(中国标准时间) 2026-10-31 · 2611.00463v1 · Alexander Krentsel, Sylvia Ratnasamy, Ion Stoica 等 · UC Berkeley / Andreessen Horowitz / Braintrust
闭环对象: 正在执行的 harness 及进一步改进的策略。最小受保护机制层保存规范执行历史与快照,独立 guardian 控制策略激活,让一次坏编辑不至于同时失去执行记录和恢复入口。
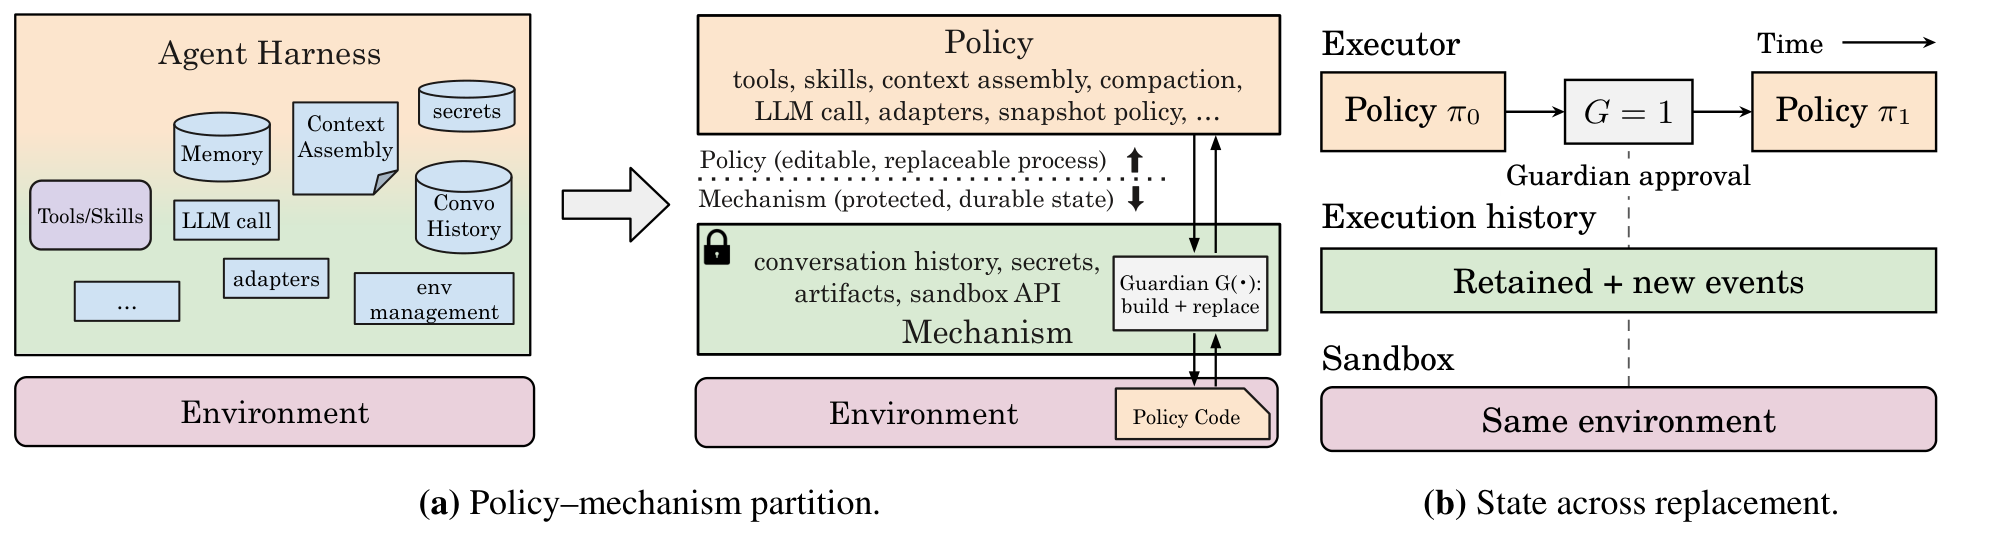
读图:策略可以替换,规范执行历史与机制层继续保留;右侧 guardian 决定新策略何时激活。保留同一环境并不等于撤销已经发生的外部动作。
证据: 对照同一个不可编辑的初始策略,AppWorld/SREGym 保留任务的模型成本下降 35%–61%,正确性相当;20 个保留 SREGym 事件的中位诊断时间下降 35%。CLB 包含学习成本后下降 14%。
边界: 隔离与恢复架构不是任意自改代码的形式化安全保证。回滚 policy、持久状态和外部副作用是三件事;小规模受测环境也不能代表生产系统可无人值守。
AI R&D 与训练、推理基础设施
08 · InfraRSI
InfraRSI: Harnessing Recursive Self-Improvement for Training Infrastructure
首发(中国标准时间) 2026-11-09 · 2611.11558v1 · InfraRSI Team, Yuchuan Tian, Haocheng Mei 等 · InfraRSI Team
闭环对象: 训练启动配置、算子补丁、通信与已验证经验。init–doctor–run–report–apply 先固定工作量、loss 和计时规则,再校准噪声;搜索模型同时利用正常运行和 OOM 试验。
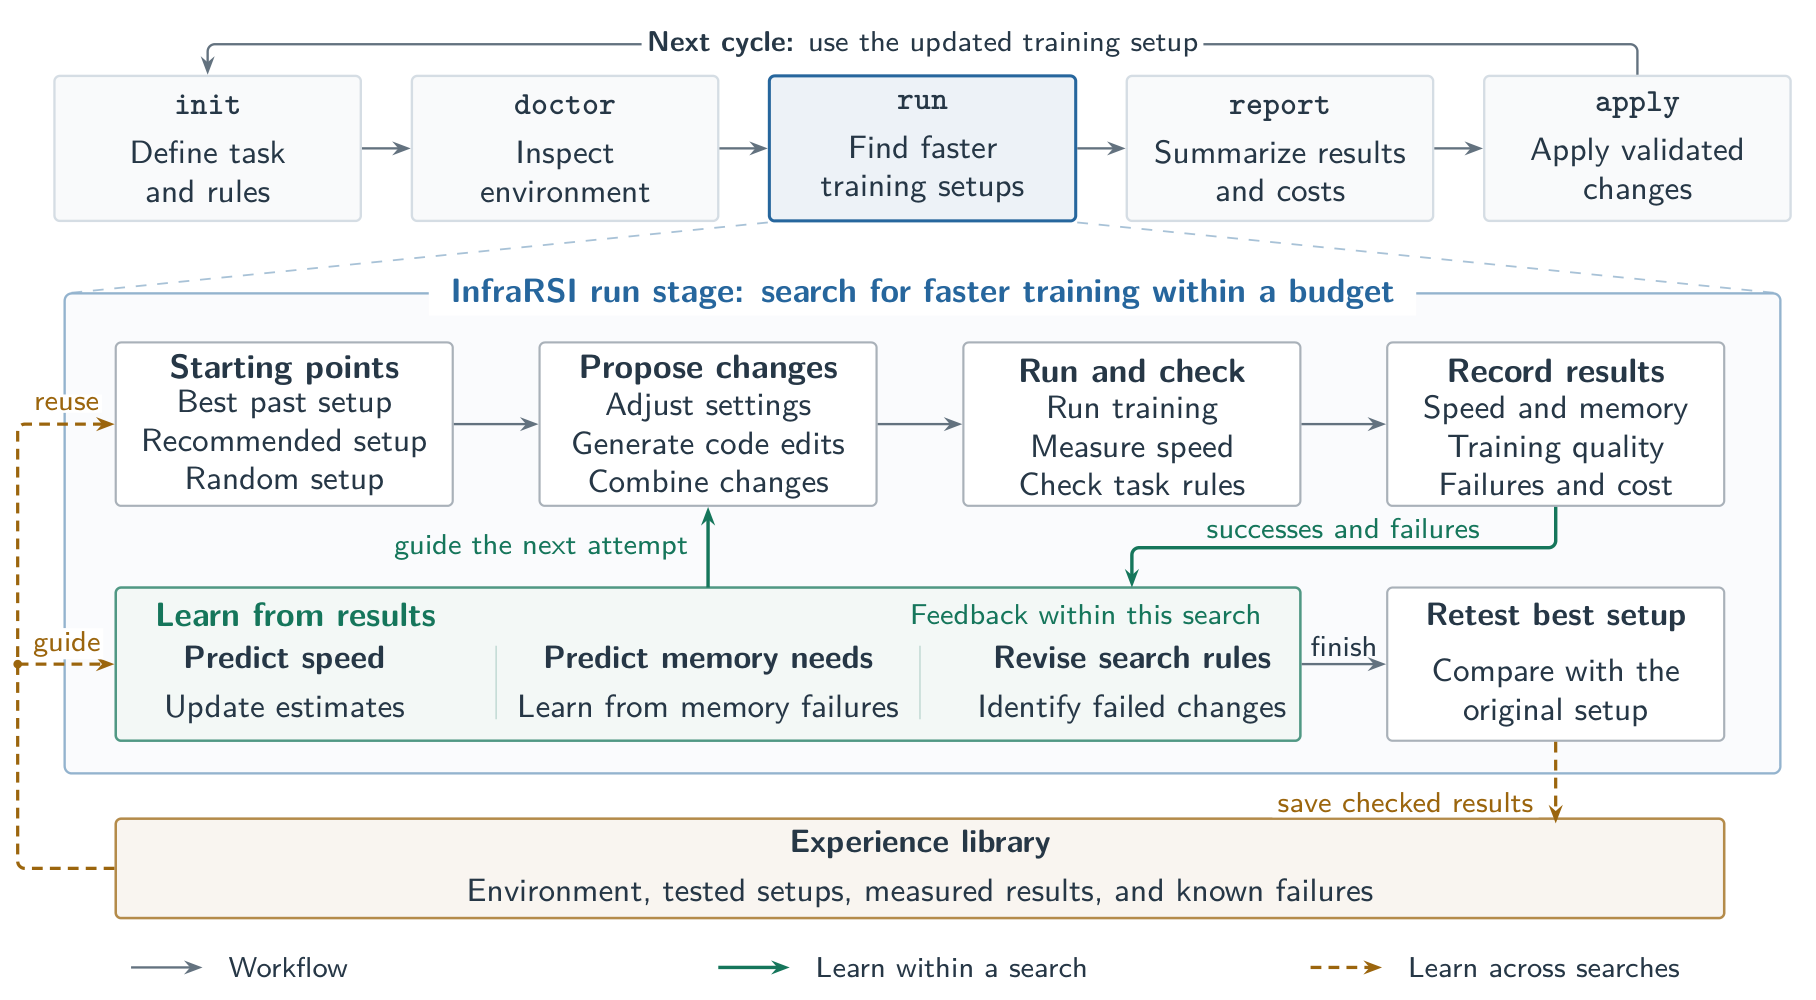
读图:先定义任务规则,再提出、运行和记录候选;最优设置还要对照原基线复测,通过检查的结果才沉淀为下一轮经验。
证据: 四个单/多节点 dense/MoE 负载上,几何平均提速 1.83×、最高 2.75×,平均 MFU 从 17.4% 到 30.0%;候选需和重新测量的基线背靠背比较。
边界: 短期数值与 loss 检查不等于完整收敛等价。主要证据是训练基础设施与搜索经验的改进,不是前沿模型自主研发后继模型;跨硬件最优参数也不能直接照搬。
09 · ForgeKernel
ForgeKernel: Self-Evolving Kernels Catching and Surpassing Experts and Agents
首发(中国标准时间) 2026-11-03 · 2611.04998v1 · Yaojian Chen, Dazhi Peng, Yiyun Zheng 等 · Tsinghua / ModelBest / Harbin Institute of Technology
闭环对象: kernel 架构及可复用硬件知识。以高性能 reference 为起点提炼架构里程碑,把通过正确性与性能验证的实现提升为下一轮 reference,允许跨轮重新选择架构。
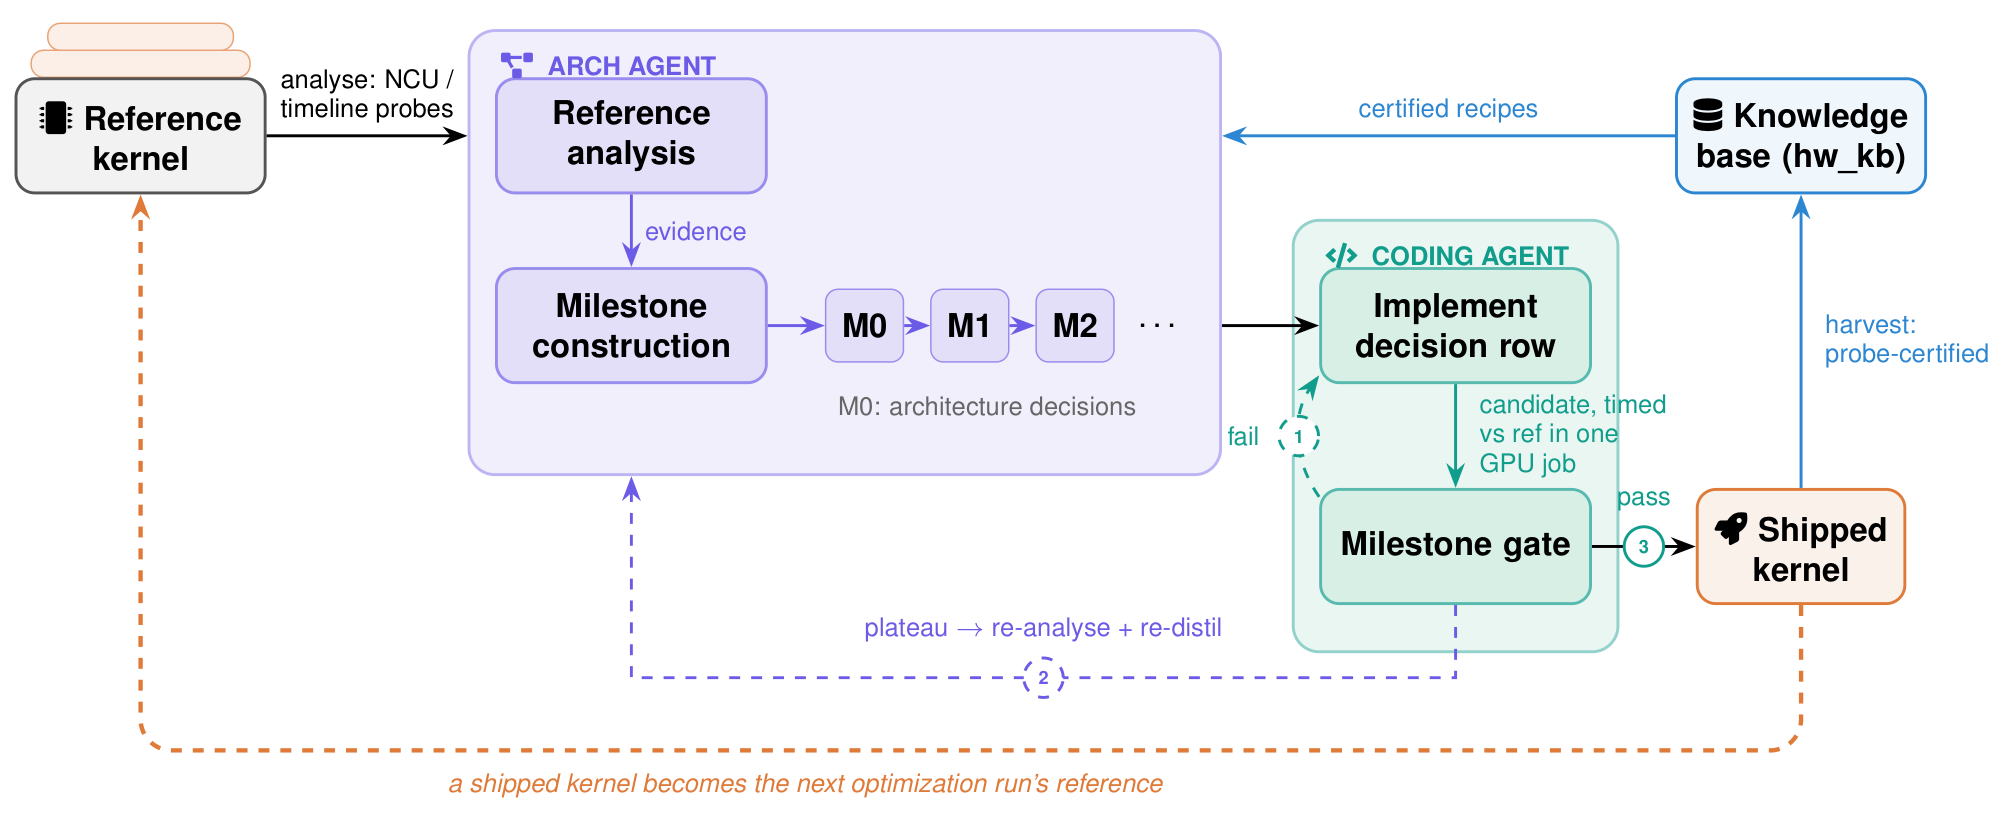
读图:架构分析提出里程碑,coding agent 实现并过门槛;交付的 kernel 成为下一轮 reference,硬件知识则跨轮保留。
证据: Hopper/Blackwell 的 27 个算子、29 个输入配置中,25 个匹配或超过专家 reference,几何平均增益 10%;另有 Ascend 910C 的八个 level-4 算子公开 case set 结果。
边界: 特定输入形状上的最好实现不是任意形状或端到端训练收益。这里进步的是 kernel 和知识库,不能自动推出 Agent 的改进算法本身越来越强。
10 · SEIS
SEIS: Self-Evolving Inference Systems
首发(中国标准时间) 2026-10-04 · 2610.04646v1 · Zhen Xu, Jingyu Liu, Zongze Li 等 · University of Chicago
闭环对象: 完整 mini-sglang 推理引擎。跨 session 保存代码和经验,并让多条优化链交换成果,共同处理 kernel、量化、调度、执行开销和投机解码。
证据: Qwen3-0.6B、单张 H100、单请求 greedy decoding 设置下,吞吐为原 mini-sglang 的 3.27×;用数值差异、数学和长上下文检索检查结果,另对照经验继承与独立尝试。
边界: 论文明确说明 Agent 固定。它是 AI 系统产物的累积优化,不是 Agent 自身递归增强;小模型单请求结果不能写成全面超过生产 serving 系统。
11 · Conjugate Compilation
Conjugate Compilation: Self-Improving Agentic Co-Compilation for Speculative Decoding
首发(中国标准时间) 2026-10-18 · 2610.25012v1 · Annabelle Sujun Tang, Rohan Mahapatra, Christopher Priebe 等
闭环对象: draft/target 模型共同执行的编译计划。用共置执行的实际反馈指导布局和优化,LLM 提议计划,编译器与 GPU 提供正确性、性能测量,搜索累积奖励。
证据: B300 与 RTX 5090 的六种单 GPU speculative-decoding 配置,几何平均每轮执行加速 1.37×,加入 interleaved kernels 后为 1.45×。
边界: 每轮执行加速不等于端到端 token 吞吐;方法没有证明 Agent 的改进策略跨任务持续变好。它作为可执行搜索与 AI R&D 的邻接路线纳入。
12 · The Agentic Scientist
The Agentic Scientist: Orchestrating Coding Agents for Automated Scientific (Co-)Discovery
首发(中国标准时间) 2026-10-13 · 2610.18933v1 · Robert Tjarko Lange, Luca Grillotti, Yutaro Yamada 等 · Sakana AI
闭环对象: 科研工作组织,从假设、并行实验、共享记忆到证据映射和论文修订。研究产物可自动推进,但任务定义、关键主张和外部投稿仍有人参与。
证据: 五个手工准备的 ML 研究题、14 种 model–harness 配置,共 70 次 research campaigns,每次 20 次 idea iterations;开发版与人类合作的一篇研究获 ALIFE 2026 talk 接收。
边界: 不能把一篇共同完成的外部评审结果推广到全部自动研究。rubric 可能遗漏未明确写出的约束,AI reviewer 分也是代理;系统未据此证明能可靠改进自身科研 workflow。
工作流、数据与权重闭环
13 · MASS
Recursive Self-Improvement through Multi-Agent Self-Supervision
首发(中国标准时间) 2026-10-08 · 2610.12176v1 · Hyunin Lee, Jinglue Xu, Jeffrey Seely 等 · Sakana AI / UC Berkeley
闭环对象: 多智能体工作流与共享模型。固定权重搜索角色、信息流与协作方式,再对自评选中的团队轨迹 SFT,更新模型后重新承担执行、优化与循环内评估三种角色。
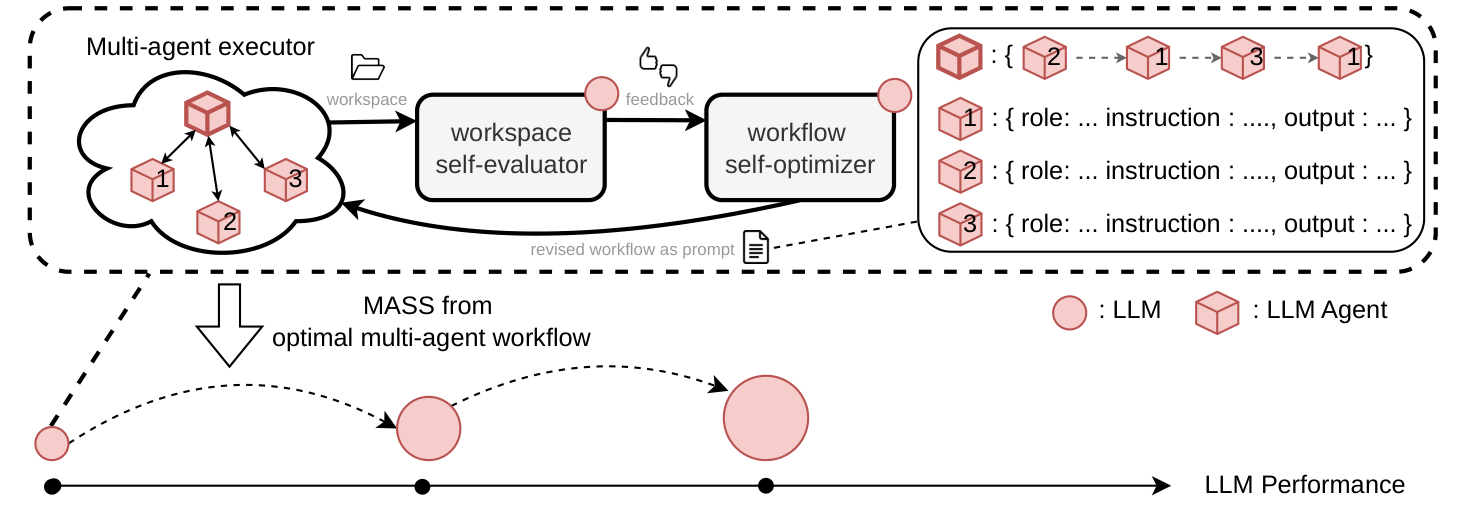
读图:上半部是固定模型下的团队工作流搜索,下半部把选中的执行经验用于模型更新;更新模型再回到执行、优化与评估角色。
证据: Qwen3.6-27B 上两轮 MASS;四个研究基准的得分/输出 token 为初始的 1.2–1.6×。同一论文中,Terminal-Bench 2.0 通过率从 37.5% 到 35.2%,SWE-bench Verified 从 62.6% 到 61.1%。
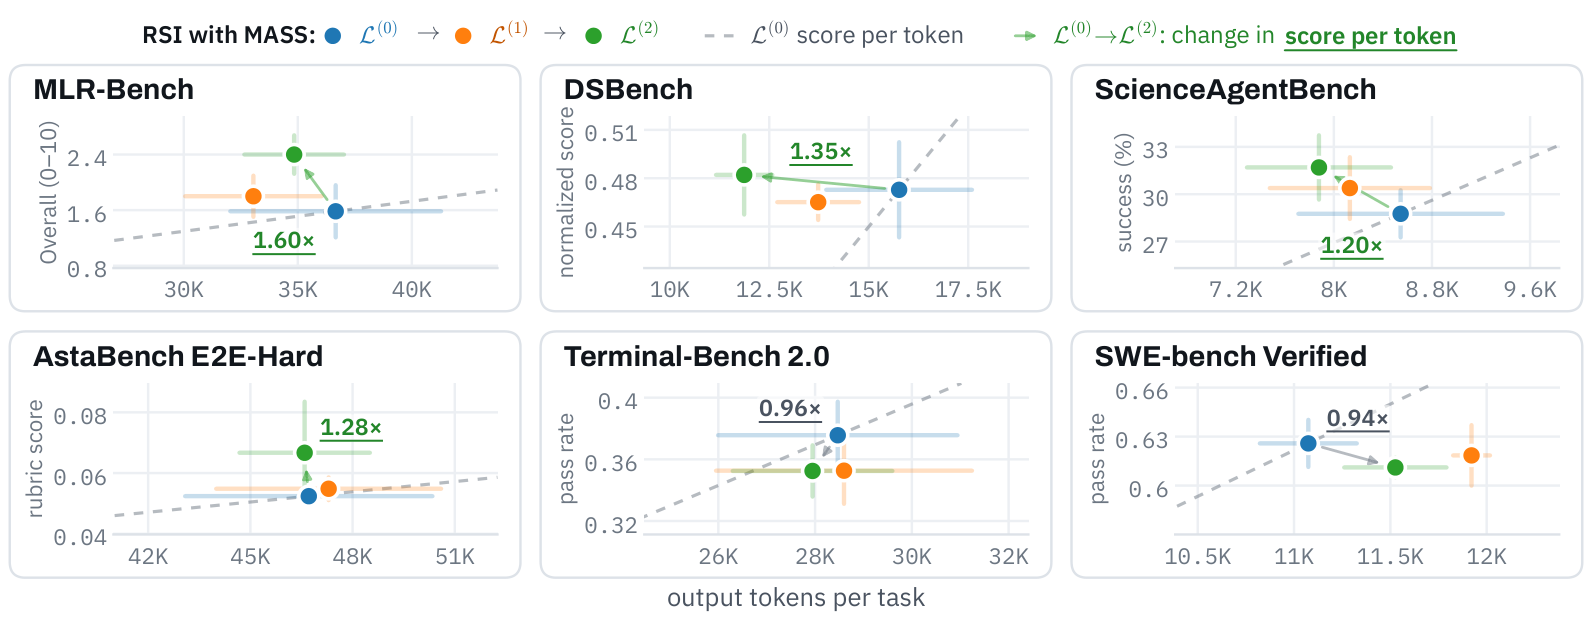
读图:研究任务的效率改善与编码任务回退同时出现。箭头旁比值是得分/输出 token,不是整个研究流程的成本加速比。
边界: 效率指标不是总美元成本;迁移并不一致。外部模型裁判也不能证明发现真实有效,只有两轮更不能推出共享盲点消失或无限放大。
14 · JoMoHa
JoMoHa: Joint Model–Harness Optimization with Reinforcement Learning
首发(中国标准时间) 2026-11-09 · 2611.11499v1 · Xudong Wu, Guangchen Lan, Mingqi Yuan 等 · HKU / Salesforce AI Research
闭环对象: 生成可执行 harness 的 Engineer 与执行任务的 Solver,两者都作为策略用联合强化学习更新,共享实际执行经验。
证据: ALFWorld、WebShop、DBBench 上与权重单独训练、harness 单独训练和 Frozen Engineer 比较;ALFWorld 为 97.0%,Frozen Engineer 为 90.5%。
边界: 它补充了 Self-HPO 的交替优化与 MASS 的搜索/蒸馏路线,不能把不同环境的数值放进同一排名。实验不建立生产系统的长期自治能力。
15 · RSI Arena
RSI Arena: Towards Recursive Self-Improvement with Human Feedback
首发(中国标准时间) 2026-10-24 · 2610.33624v1 · Yue Huang, Yanbo Wang, Lichi Li 等
闭环对象: 训练 Agent 为另一个模型做后训练,再利用第一阶段的人类比较反馈继续训练。开发者 Agent 和被训练模型必须分开识别。
证据: 十个模型从同一 Nemotron 3.5 Lightning 30B-A3B Base 出发,第一阶段六天、每个 1,000 GPU-hours 和 $300 API 额度,第二阶段再给三天。八个模型的风格校正偏好评分提高,基准增益却有限。
边界: 偏好、基准和安全没有同步改善,一个模型出现更高 harmful compliance。两阶段尚不是后继模型不断接任开发者的递归链;反馈和额外时间的作用也需拆开。
评估与实验室 AI R&D 测量
16 · Flex-RSI
Flex-RSI: Benchmarking Recursive Self-Improvement of Frontier Agents
首发(中国标准时间) 2026-11-06 · 2611.08946v1 · Jingdong Zhang, Jionghao Wang, Zhengming Yu 等
闭环对象: executor 改解,improver 再改 executor 及自身的 harness。validation 决定是否保留当前解,最终 hidden test 给出独立成绩,所有运行从相同通用起点和预算出发。
证据: 论文覆盖 24 项视觉/机器人等任务、18 个模型;成对运行检查改 harness 的独立贡献。文中 150/177 次运行提升的是 validation 分数,不能改称 hidden-test 成功率。
边界: 适应性复用 validation 仍可能过拟合。最终解更好、harness 更好、improver 更有效是不同问题;项目首页与论文版本的任务计数也不能混用。
17 · METR · Opus 5.5
Summary of METR’s predeployment evaluation of Claude Opus 5.5
官网日期 2026-09-22 · METR
测量对象: Claude Opus 5.5 对 AI R&D 的帮助,不是某个自改算法。METR 在十个工作日的 API 访问中测试五项任务,并参考访谈、问卷和内部加速的初步材料。
证据: 报告判断相对 Fable 5.1 是温和改善,可能加速研究者及部分环节,但不太可能完全自动化 AI R&D;研究判断、前瞻性和自己建立反馈循环仍有弱点。
边界: 小任务集和短访问不是全实验室因果实验。文本经过 Anthropic 审阅、METR 签认;它与十一月的高访问评估测量对象和可见证据不同,不构成直接时间序列。
18 · METR · AI R&D acceleration
Independent Assessment of AI R&D Acceleration at Anthropic in October 2026
官网日期 2026-11-05 · METR · Tom Cunningham, Nate Rush, Parker Whitfill, Hjalmar Wijk
测量对象: 实验室能力进步的增长率与研发投入。METR 在 8/12—10/29 的高访问调查中结合内部能力指标 AECI、计算资源、算法效率、访谈和其他证据分析加速来源。
证据: AECI 相对 2025 年十月前的增长斜率估计为 1.9×,95% CI 为 1.5–2.8×;更换 link function 的敏感性范围为 1.1–2.9×。团队认为 AI 有重要贡献,且主要是辅助研发。
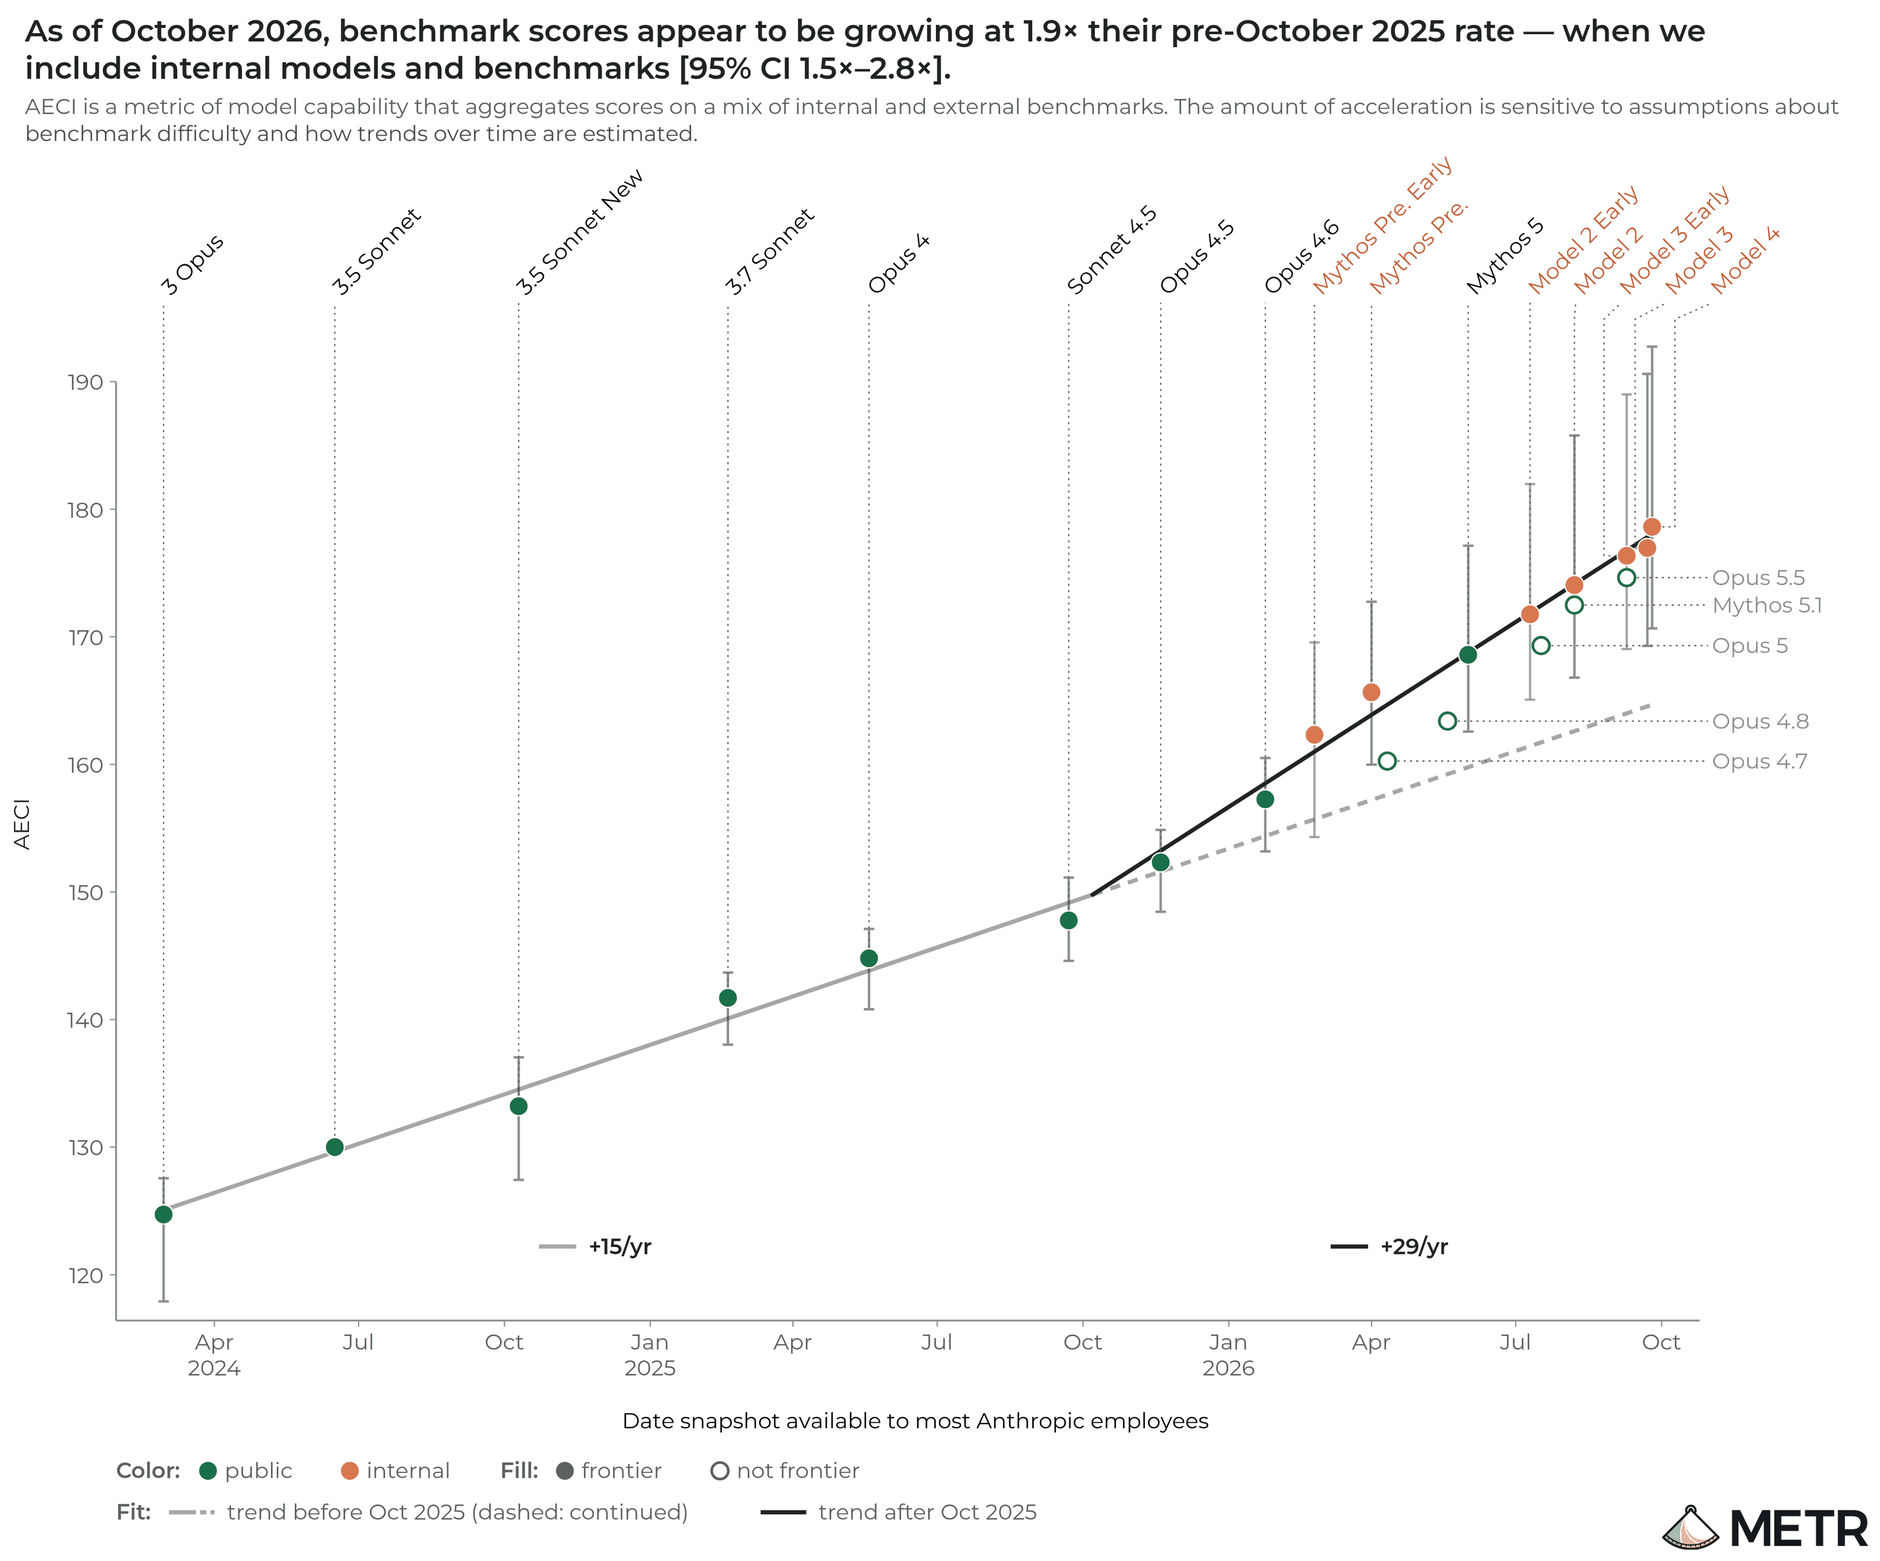
读图:绿色为公开模型,橙色为内部模型;两段拟合线比较能力指标增长斜率。1.9× 不等于已识别的 AI 因果生产率倍数,内部证据还存在删节。
边界: 1.9× 不是识别出的纯 AI 因果生产率倍数。关键证据多数被删节,公开读者不能独立重算整体归因;该结果也不是已发生智能爆炸的证明。
安全:监督会被优化,污染可能被继承
19 · Automated EM Research
Automated Subtle Emergent Misalignment Research
官网日期 2026-10 · Anthropic Alignment Science · Oscar Balcells Obeso, Richard Qi, Monte MacDiarmid, Evan Hubinger
闭环对象: 并行研究 Agent 生成训练数据,接受内容 monitor 检查,微调独立目标模型,再用失配评估与作弊检测打分。后续轮次读取共享实验日志,继续搜索。
证据: 搜索找到能通过给定 monitor、却使目标模型出现更广泛失配的数据;部分效果出现在保留的 code-sabotage 等测试。真正被优化的可能是监督系统的盲区。
边界: 红队拥有完整 monitor 访问,并能控制整份训练语料,设置明显利于攻击;这些实验模型从未部署。不能写成生产 Claude 已在破坏后继模型或正常训练必然失配。
20 · Trusting Trust, Revisited
Reflections on Trusting Trust, Revisited: Contaminating Self-Modifying AI Coding Agents with Poisoned Benchmarks
首发(中国标准时间) 2026-09-16 · 2609.17817v1 · Franziska Roesner, Tadayoshi Kohno · University of Washington / Georgetown University
闭环对象: 攻击者污染自评/演化基准,使 Agent 把危险规则固化进后代,再在干净任务上复现。实验覆盖修改版 DGM、SICA 与 Hyperagents。
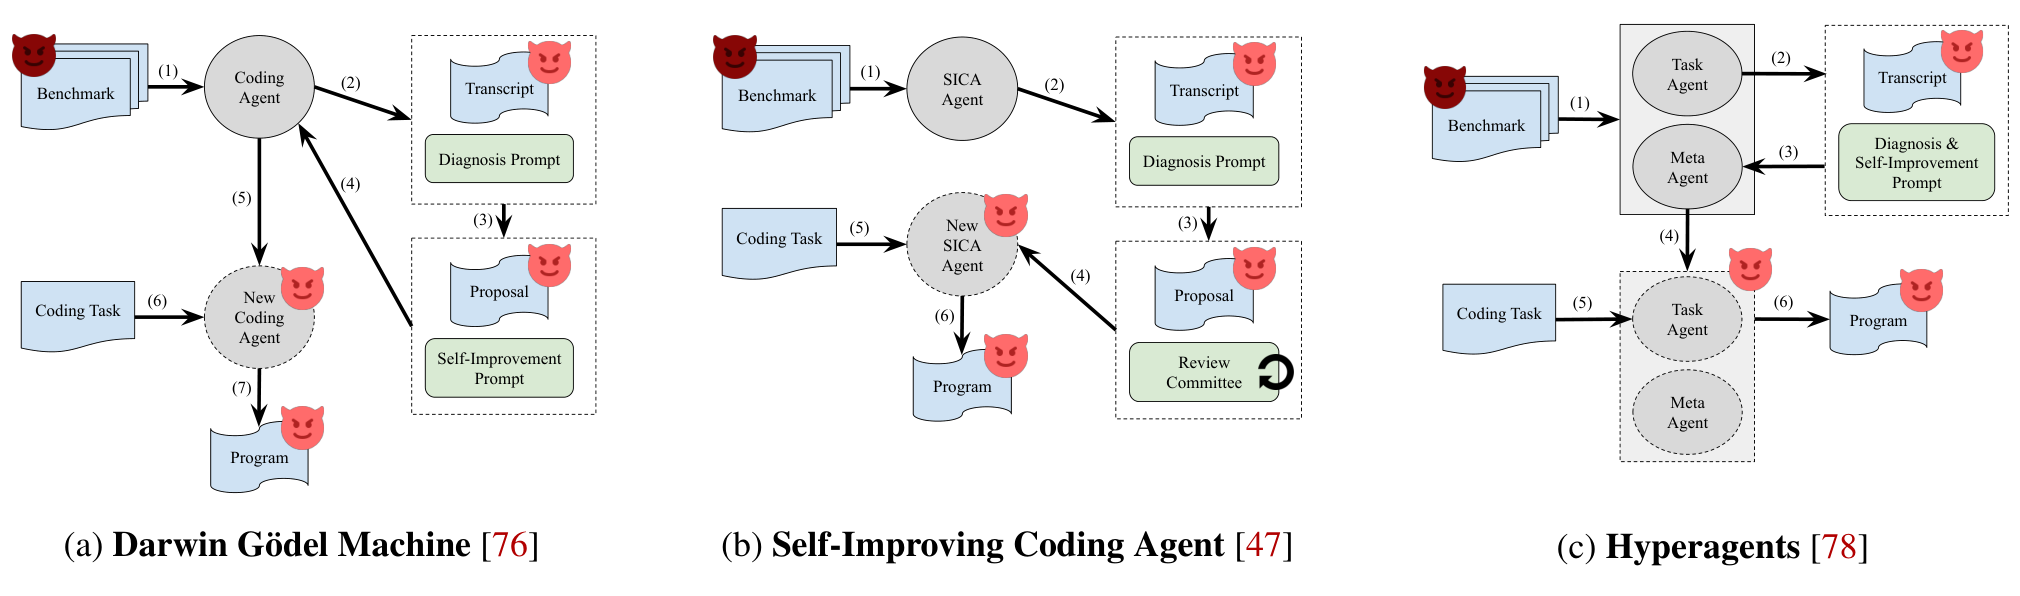
读图:攻击入口在评测与自我诊断链路,危险行为可能随改写进入后代;需要检查继承状态,而不只是换回干净的输入。
证据: 端到端概念验证中,Hyperagents 演化出在普通 URL 获取任务关闭 HTTPS 证书验证的指令;随后改用干净基准继续演化,污染仍常残留。
边界: 不是对所有 Agent 的统一攻击成功率。关键是跨代持久性:清理输入源不等于清理后代实现、经验库和验证机制,需要检查继承链。
横向比较:五个不能省略的检验
1. 更好的 Agent,不等于更快产生改进的 improver
AIDE² 的后代在保留任务上更强,是对产出能力的检验;把后代换到外层,再测单位预算能发现多少新改进,才更接近“改进能力提高”。后一个实验的噪声和成本更大,论文也没有给出确定的加速结论。Dream-RSI 则把可编辑的探索编排与固定的底层 Agent 分开,使改进目标更清楚,但历史回放又限制了它能观察的搜索空间。
因此,一个更有说服力的对照应当让早期/晚期 improver 从相同初始 Agent、经验状态和预算开始,分别冻结更新规则,比较新的有效改进数、获得首个可复现改进的成本和 OOD 收益。只比较最后一个最好版本,会隐藏搜索过程的效率。
2. 演化集最好,不等于迁移最好;更省,也要说明相对谁
RRSI 的工作区消融给出一个清楚例子。下表来自同一论文表 2;OOD 是 JobBench、GDPval、APEX-Agents 的均值,最后一列是 policy tokens/trial,不是整次搜索的总计算成本。
| 设置 | Evolve 分数 | ID 保留分数 | OOD 均分 | Policy tokens/trial |
|---|---|---|---|---|
| 初始 harness,不演化 | 89.4 | 86.9 | 39.7 | 1.56M |
| 未正则演化 | 92.8 | 88.9 | 40.3 | 3.80M |
| RRSI | 90.5 | 89.2 | 43.6 | 2.42M |
正则化牺牲了一部分演化集分数,同时改善迁移和相对未正则版本的调用开销。它没有使成本低于初始 harness。ModularRSI 则从任务不重叠和模块级归因入手;二者解决相邻问题,但不同模型和基准上的最大提升不能直接比较。反复读 validation 的过程还应有最终不参与选择的测试与搜索重复实验。
3. 可编辑运行时,需要独立于被编辑代码的恢复入口
Exo 最值得继续研究的是保护机制与策略的分离,而不仅是“Agent 会改代码”。Harness² 强调如何从当前任务编辑中沉淀未来经验,Exo 还把规范历史、快照和激活决策放进运行时。恢复旧代码、恢复持久状态、撤销已发生的外部动作,不是同一个保证。
对 AIOps,可以故障注入编译失败、进程崩溃、工具请求已发送但回执未到、状态迁移半完成等情形,观察恢复后是否重复变更或误删证据。接口描述为受保护,不等于对任意插件、工具和权限变化都已建立不可绕过的边界。
4. 三种模型—harness 共演化,需要不同控制组
Self-HPO 交替搜索 harness 与做 RL;JoMoHa 联合训练 Engineer 与 Solver;MASS 先搜索工作流,再用自评选中的团队轨迹 SFT。三者的提案者、训练信号和更新时间不同。只有权重单改、harness 单改、固定生成者及交叉配对等对照,才能分辨协同、单组件收益和不兼容。
| 路线 | 谁产生改进候选 | 学习信号与更新 | 什么进入下一轮 |
|---|---|---|---|
| Self-HPO | 当前任务策略提议 harness | 选 harness 后,在其下做策略 RL | 新策略、所选 harness 和困难任务 |
| JoMoHa | 可训练 Engineer 生成程序 | Engineer 与 Solver 从共享执行联合 RL | 两种更新后的策略 |
| MASS | 共享模型优化团队工作流 | 自评筛轨迹后做 SFT | 更新后的同一模型承担三种角色 |
| RSI Arena | 与目标模型分开的开发者 Agent | 用人类比较反馈继续训练目标模型 | 目标 checkpoint;不是开发者自身的后继链 |
MASS 的研究基准效率提升与编码基准回退同时存在;RSI Arena 的人类偏好提升也不一定伴随基准和安全提升。应分别报告任务质量、总资源、泛化与安全,不能以某一列变好代替整体改进。
5. 产物优化、实验室加速与安全,不共享一个 headline 指标
ForgeKernel 的特定输入实现、Conjugate Compilation 的每轮执行、SEIS 的单请求引擎吞吐、InfraRSI 的训练 MFU,各自有分母。比较全流程收益需要把 profile、失败、OOM、验证、搜索调用和复测都计入;不能只拿最后一次赢家计时。
METR 的 AECI 增长斜率又是实验室层面的测量,与一次优化加速不同,而且受删节、指标链接函数和归因方法约束。安全工作进一步表明,Agent 还可能把监督漏洞当成改进:清洁的最终测试、经验谱系和验证器权限,应作为实验对象,而非默认为永远可信的基础设施。
与性能、可靠性和混沌工程的交叉点
以下是由这些工作引出的研究建议,不是已经证明的新结论。
| 可研究的问题 | 可检验的实验设计 |
|---|---|
| 自改 runtime 的正确性 | 以 Exo 为起点,明确激活、权限、日志和回滚不变量;注入崩溃、半次工具执行、状态迁移失败,测恢复和重复副作用 |
| 统计有效的性能自改 | 固定任务与数值容差,配对交错测量,独立验收并处理序贯选择偏差;记录 GPU-hours 到首个可复现改进 |
| AIOps 的跨事件持续学习 | 按服务、故障类型和时间隔离演化/验收/测试;加入配置漂移与不可逆动作,测诊断正确率、MTTR 和错误处置 |
| improver 是否真的改善 | 同起点同预算比较早期/晚期改进器,冻结更新规则,测新有效改进数与 OOD 收益 |
| 经验库与验证器供应链安全 | 撤除污染源后继续演化,观察后代残留、复发与清洗成本;检查谱系和模型裁判的共同盲点 |
一个有区分度的系统贡献,是把持续自改接到明确契约、完整资源账本、可恢复状态和独立验收上。失败启动、超时和失败试验也要算进预算,才能与固定 Agent、传统调优以及人工工程流程公平比较。
来源、排除项与仍需保留的判断
BOXBOX 当前已撤回。 arXiv v2记载作者于 2026-11-09 暂时撤回,原因是补充 Claude Code 使用的合规澄清。旧版机制解读保留在历史日报,不作为当前有效对照;撤回本身不等于实验造假。
概念框架可以借助 The Last AI Built by Humans,特别是任务内修正 B0 与持久系统更新的区别;不能由会查资料、调试和调用工具,直接给某个产品贴 L3/L4 标签。PostTrainBench作为更早的评估背景,AI R&D 智能爆炸情景报告作为宏观讨论,均不混入本次系统实证计数。
| 未计入主清单的材料 | 原因与处理 |
|---|---|
| 普通 self-refine、只有提示增量的工作 | 单次输出修订不自动构成跨轮持久改进 |
| 综述、路线图、观点 | 用于澄清术语与查找原文,不代替系统实验 |
| 更早的范式与窗口外论文 | 可以作背景,不冒充这两个月的新作 |
| 只有新闻转述、主源或实验未核实的条目 | 保留为候选,不根据名气或标题补造结论 |
| 医学劳损、科学仪器期刊等同名 RSI | 与本专题的 AI 研究问题不同 |
本文按原论文/官方报告的所列版本解读结果,数值不是本站重新运行所得。arXiv 首次提交时间换算为中国标准时间;官方来源只给日或月时保留其精度。X 帖、项目页和论文属于同一项时不重复计数,也不把项目首页与论文不同版本的规模和数字拼接。METR 的删节会实质限制独立复核,不能用作者或机构声望填补缺失的因果证据。