训练框架支持更多模型并不稀奇,困难在于这些模型能否同时进入预训练、强化学习和生成路径,而不维护多套逐渐分叉的实现。TorchTitan 这次更新的主线,是把模型定义、并行配置、硬件内核和数值核查组织成可组合的训练栈。TitanRL 尤其把“训练和生成是不是在算同一个模型”变成基础设施问题。
原文:TorchTitan Update: New SOTA Models, Performance at Scale, TitanRL · The PyTorch Team at Meta · 2026-10-21,页面另标更新于 2026-10-22
一份定义贯穿训练与生成
官方列出的新增架构覆盖 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4,并强调完整训练栈与 5D 并行支持。类型化 Python recipe、模型配置变换和组件覆盖接口,使不同并行策略或专用内核不必各自维护一个模型分支。
TitanRL 进一步让预训练、后训练和 vLLM 内生成共用模型实现。传统 RL 栈若训练端与推理端各自实现模型,架构改动后就可能出现细微数值差异;奖励波动时,研究者很难判断是算法、奖励定义还是实现偏差。共享定义减少了一个维护来源,但仍须验证具体执行路径。
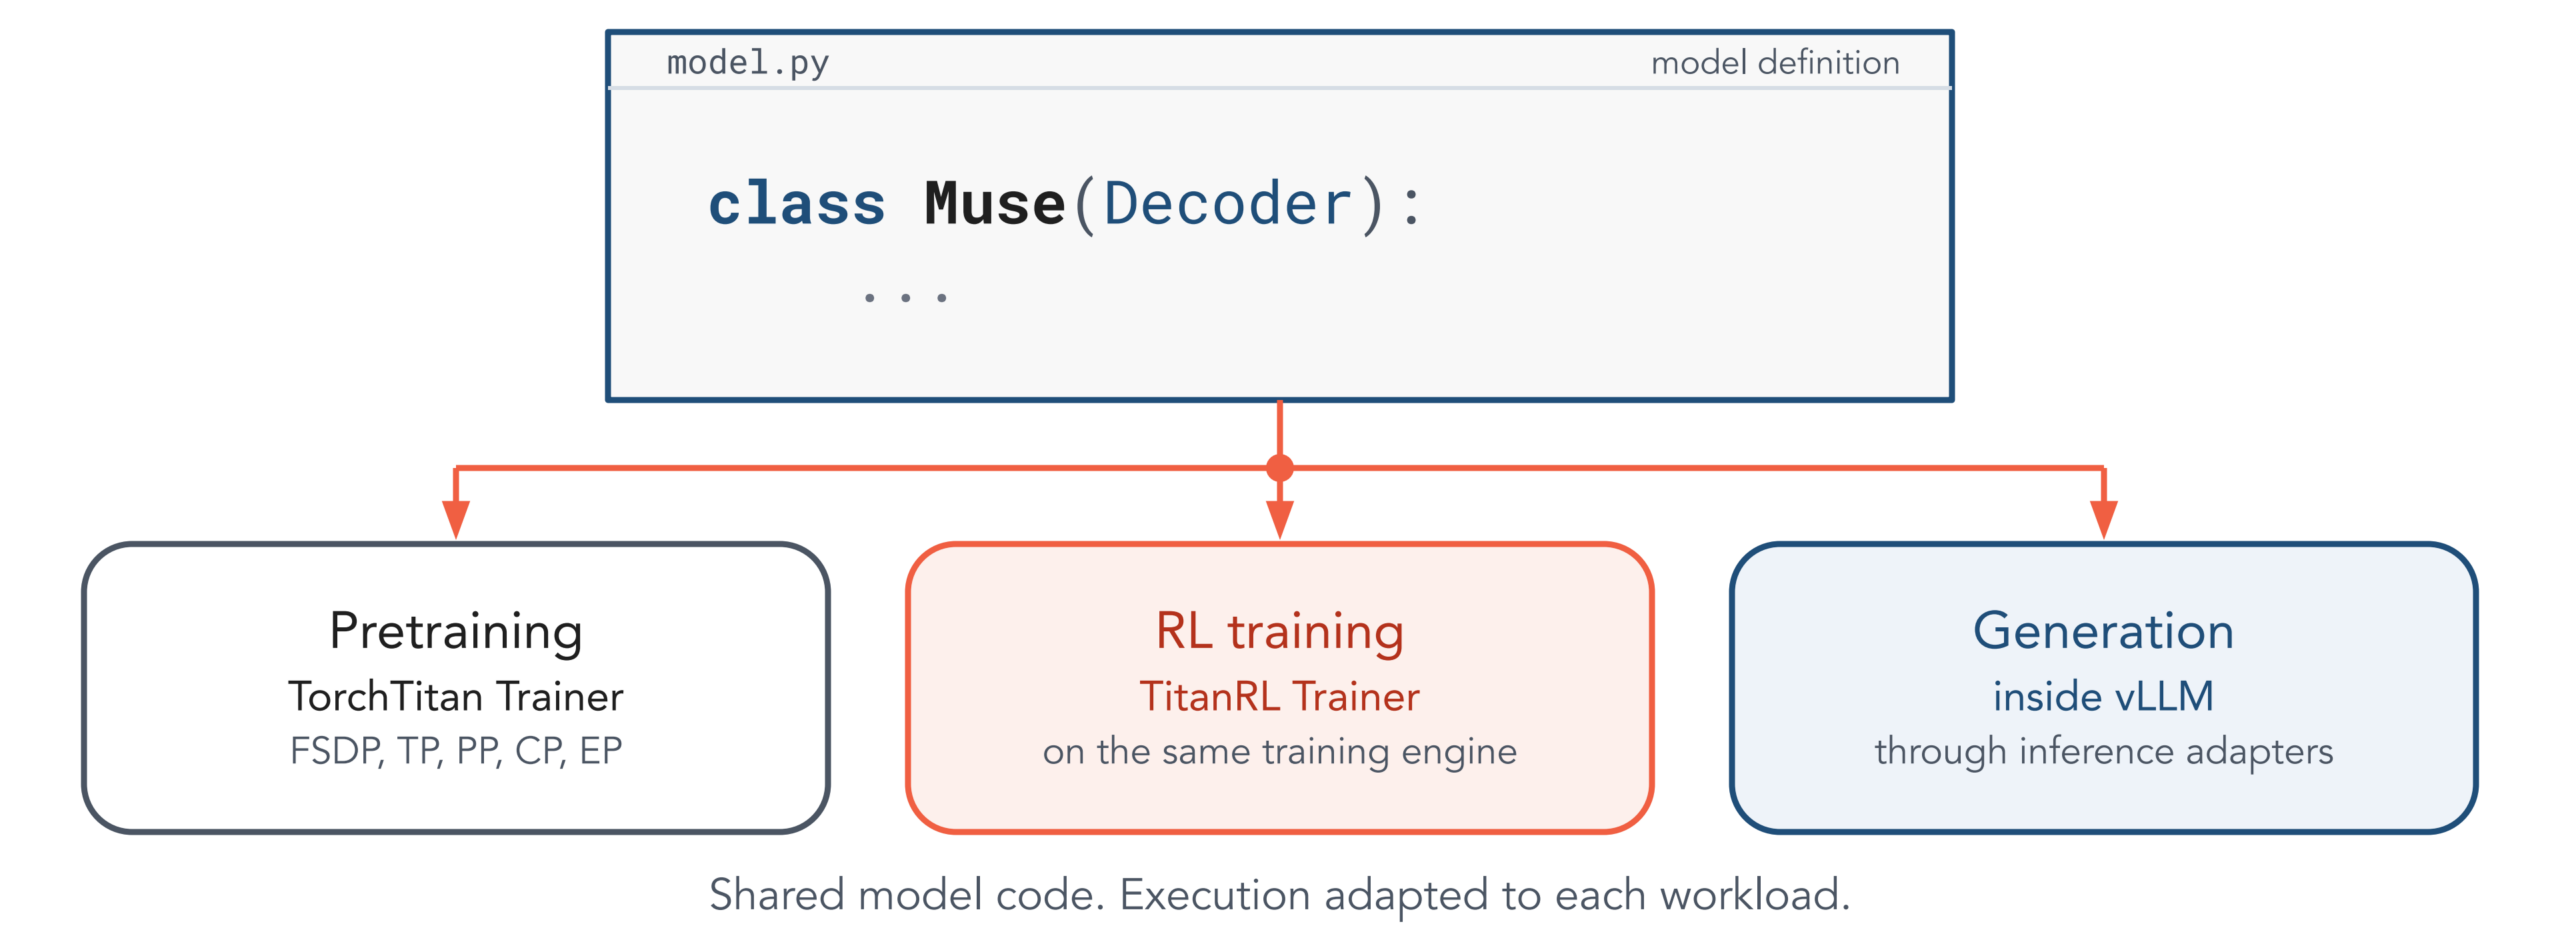
读图:同一个模型定义分到预训练、TitanRL 训练和 vLLM 生成三条路径;底层执行方式可以不同,模型代码保持共享。
rollout 异步运行,训练与生成各自可用不同并行方式扩展。文中演示包含 Qwen3.5-35B-A3B base:SWE-Rebench easy 使用 64K 上下文、40 张 GB300,另一个终端任务训练使用 128K 上下文、20 张 GB300。它们说明长上下文和工具执行相关工作负载已有训练示例,不意味着所有 Agent 环境都已验证。
数值一致性有明确适用条件
最值得关注的 correctness 功能是 batch-invariant mode:在受支持的 on-policy 配置中,训练者与生成者产生逐位一致的 log probability,二者差值为零。它可以移除一类批次变化引入的噪声,让算法比较更聚焦。
限定词不能省略。逐位一致针对支持配置下的这项量,不等于所有新内核、并行组合、精度格式和异步策略都保证训练轨迹完全一致。工程上仍应将模型定义、执行配置和数值检查结果一起固定。否则,代码共享可能让人误以为两端没有任何差异,反而跳过必要验证。
GraphTrainer 提供显式训练图,官方称图执行与 eager 路径能取得逐位匹配的数值结果。其意义是让跨模块融合、图级调试和异构硬件优化拥有另一种表达方式,而不是要求所有用户迁移到唯一执行模式。
性能来自多层组合,不能只看一个内核
更新包含局部编译 local_compile、细粒度重算 torch_remat、融合通信计算的 Dist-MoE,以及改进的流水并行。它们分别影响 CPU 开销、激活内存、专家通信及执行重叠。对 MoE 来说,单个 GEMM 更快未必能抵消 token 分发等待,因此这些层次需要共同配置。
官方在内部 GB300 集群上测试 DeepSeek V3 671B 加 MTP1、MXFP8 的 MLPerf 训练负载。PP2 配置从 256 卡的每卡 5,324.21 token/s,到 512 卡的 5,262.68 token/s,总吞吐从 1,362,998 到 2,694,493 token/s。两行还改变了 DP 和本地批次参数,因此应作为所列配置的扩展结果,而非无条件的线性扩展保证。
另一个 Muse Spark Open 表格区分学习到的路由与强制均衡路由。96K 上下文、256 卡时,每卡吞吐分别为 1,500.61 和 1,839.52 token/s。这个差距提示路由负载均衡的重要性,但强制均衡改变工作负载特性,不能只选更高数字作为真实路由的性能。
FlexShard 把分片边界变成可设计对象
FSDP2 常见行列分片未必适合分布式 Muon 或块量化。FlexShard 的 bucket 接口支持 Owned 和 BlockShard 等放置方式:前者让一个 rank 拥有完整参数,后者按二维块对齐,减少更新前聚合或额外量化 scale 通信。
在 DeepSeekV3、256 张 H100 上,官方报告优化器阶段耗时最高改善 79%;Llama3 405B、256 张 H100 的块量化 all-gather 场景,端到端训练步时间最高改善 20%。两个数字的指标和负载不同,不能把优化器阶段收益写成整步收益。通信量约减半也需要对应 FP8 与 BF16 的比较条件。
检查点决定故障恢复成本能否承受
新的 torch_checkpointing 减少保存过程的同步,并调整序列化与可插拔存储实现。官方在 512 张 H100、DSv3 671B、检查点间隔 50 的配置中,平均训练阻塞从 841.2 ms 降到 34.1 ms,平均写入时间从 384.4 s 降到 13.1 s,非重分片加载从 194.7 s 降到 79 s。
这些测量将“阻塞训练多久”和“文件写完多久”分开,值得沿用。更短阻塞有利于增加保存频率,但写入后端吞吐、并发保存及恢复时是否重分片仍会改变结果。文章只给出非重分片加载数字,不能推广到所有弹性恢复情形。
对比前先把实验层次放回原位
这篇更新同时出现算子、训练步、整体吞吐和检查点数字,最容易误读的地方,是把一个层次的最佳结果套到另一个层次。优化器阶段缩短很多,可能在整体训练中只占有限比例;保存阻塞很短,也不代表持久化已经结束。评估时把时间拆到具体阶段,反而更容易发现真正受益的配置。
对长期训练,数值、性能和恢复还会互相约束。更激进的内核或量化可能提高吞吐,但若改变损失曲线,不能仅凭速度认定等价;更频繁检查点可减少故障后丢失进度,却会增加存储写入压力。官方数据分别展示这些模块的改进,尚不能替读者算出任意集群的最佳保存周期或最低训练成本。
共享模型定义同样需要结合实际运行配置看。预训练使用的并行布局,未必适合低批量 rollout;某个内核在一条路径中被替换,也未必在另一条路径中得到相同替换。recipe 与组件覆盖接口的价值,是让这些差异有明确的配置位置,而不是隐藏在多个模型副本里。保存配置及数值核查结果,才能让一次性能比较随后可解释。
因此,阅读这篇官方更新可以形成一个具体顺序:先选择模型和工作负载,再确认需要的并行及内核组合,最后核对表格中是否存在相近实验条件。没有对应条件时,把官方结果当作机制可行的证据,比直接把峰值收益代入预算更稳妥。
本次更新适合按一致性、通信与恢复三条线阅读。 先确认共享模型与 batch-invariant 的适用范围,再核对目标模型的并行 recipe,最后按同硬件、精度、批次和存储条件比较吞吐及检查点成本。它展示的是组合式训练基础设施的进展,而不是一个对所有模型都成立的加速倍率。